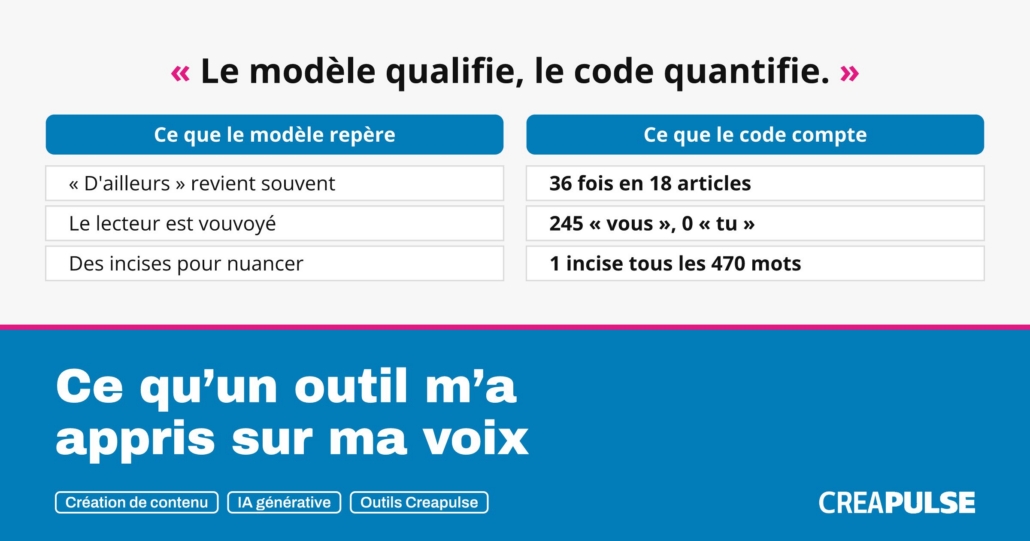
Schéma : « Le modèle qualifie, le code quantifie ». Le même trait de voix, repéré par le modèle et compté par le code.

En bref

  • Un outil gratuit qui tire votre voix d’auteur de trois de vos articles, construit et mis en ligne en deux jours.
  • Testé sur ma propre voix, il a révélé le vrai défaut : on donne des traits de style aux IA sans jamais leur dire combien de fois les employer.
  • Une IA repère très bien un trait, elle ne sait pas estimer sa fréquence : le modèle qualifie, le code quantifie.
  • Une règle de voix se mesure avant de s’écrire : une règle qui interdit ce que personne n’écrit ne sert à rien.

Article fil rouge, statut : en cours. Ce qui a changé : 24 octobre 2026, première publication.

Cet article raconte la fabrication d’un outil gratuit de Creapulse : un générateur qui extrait la voix d’un auteur à partir de trois de ses articles, et la rend prête à donner à n’importe quelle IA. Construit et mis en ligne en deux jours, il m’a surtout servi de miroir. En le testant sur ma propre voix, j’ai compris pourquoi les IA caricaturent un style, et ce qu’il faut leur donner pour qu’elles arrêtent.

Je reprends ici les huit moments qui ont compté, avec les vrais chiffres, erreurs comprises. Chaque section se termine par l’échange qui l’a déclenchée, résumé, entre Claude (l’IA avec laquelle j’ai construit l’outil) et moi.

Trois articles collés, et l'outil rend votre voix d'auteur, prête pour n'importe quelle IA
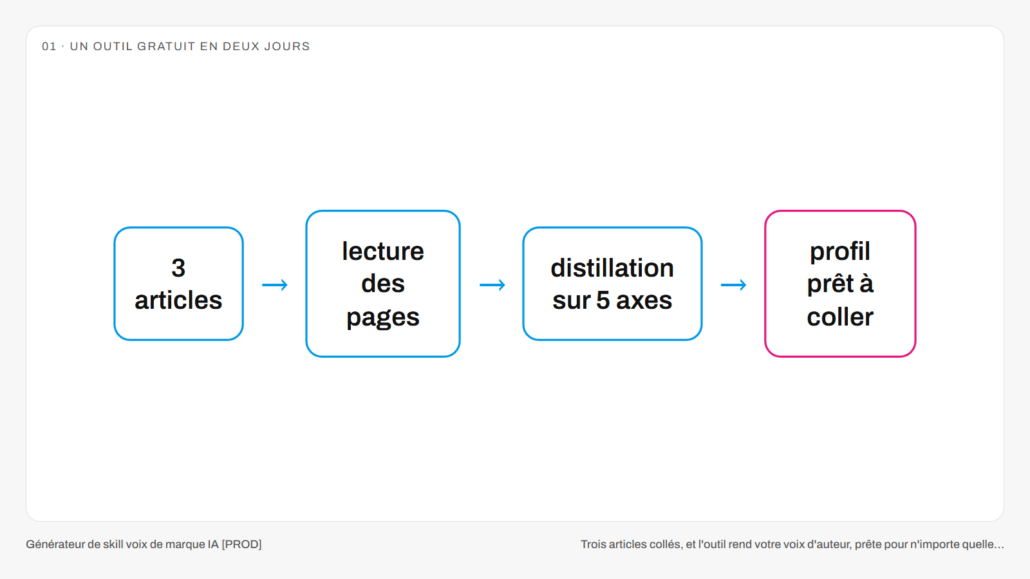
Les quatre étapes de l'outil : trois articles, lecture des pages, distillation sur cinq axes, profil prêt à coller

Le principe tient en une ligne. Vous donnez les adresses de trois de vos articles, l’outil les lit, en tire un profil de votre style sur cinq axes (ton, phrase, vocabulaire, déroulé, principes), et vous le rend sous deux formes : un bloc à coller dans ChatGPT ou Claude, et un skill à importer dans Claude.

La commande est partie un soir de septembre, et l’outil répondait en production le lendemain : une première génération sur deux articles a pris 21 secondes. Au passage, j’ai posé une règle pour tous mes outils à venir : ils vivent sous creapulse.fr/outils, jamais sur un sous-domaine chacun. Sinon, on n’a pas fini.

L’échange, résumé. Moi : je veux un outil gratuit sur mon site qui transforme quelques articles en profil de voix réutilisable. Claude : l’outil lit les pages, fait distiller la voix par un modèle, puis met le résultat en forme sans IA.

« Zéro mot exploitable » sur de vrais articles : le coupable n'était pas celui qu'on croyait
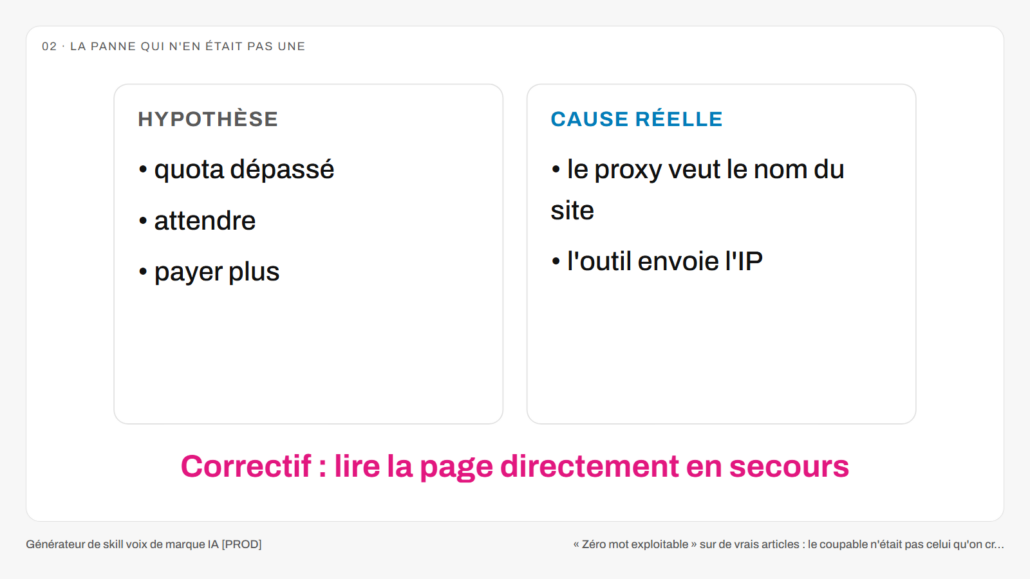
Hypothèse et cause réelle de la panne : le proxy voulait le nom du site, l'outil envoyait l'adresse IP

Le lendemain de la mise en ligne, l’outil s’est mis à répondre qu’il ne trouvait aucun mot exploitable sur des articles pourtant longs. Au même moment, le fournisseur du proxy, l’intermédiaire réseau qui sert à lire les pages, envoyait une alerte qui ressemblait furieusement à un dépassement de quota.

Ce n’en était pas un. Ce type de proxy veut connaître le nom du site visité, et l’outil ne lui donnait que son adresse IP. Plutôt que de dépendre d’un intermédiaire dont je ne maîtrise pas le protocole, l’outil lit désormais la page directement quand il échoue. Un outil public ne doit pas dépendre d’un maillon qu’on ne contrôle pas.

L’échange, résumé. Moi : l’outil me dit zéro mot exploitable, et j’ai reçu une alerte de quota du fournisseur de proxy. Claude : ce n’est pas un quota, le proxy veut le nom du site, on ne lui donne que l’adresse IP.

Le guide de voix pesait 70 % des consignes, et les articles ressemblaient à des check-lists
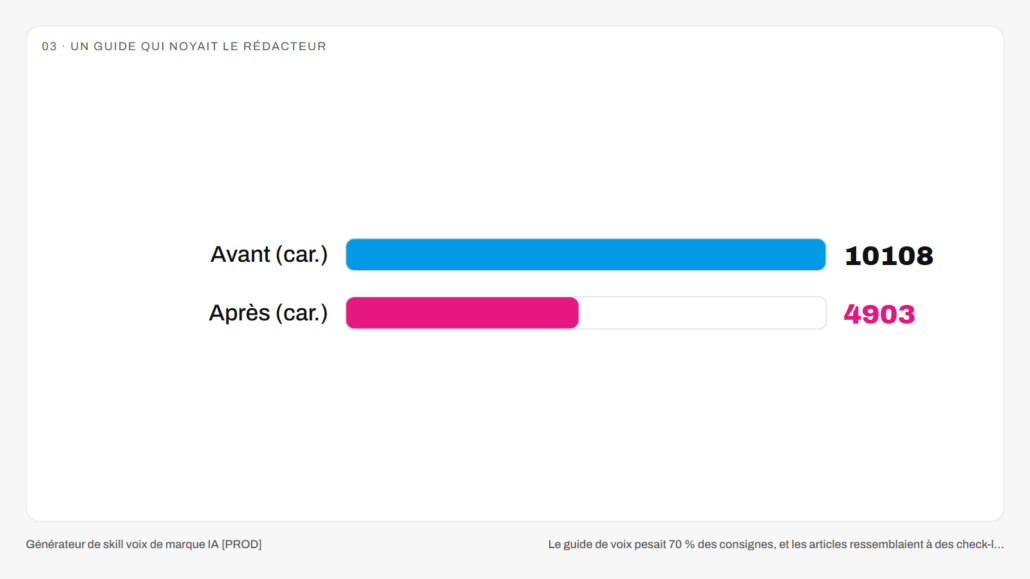
Taille du guide de voix avant et après : 10 108 puis 4 903 caractères

Un guide de voix, c’est le document qui dit à une IA comment sonne un auteur. Le mien, tiré de mes propres articles, sert à tous mes outils de rédaction. Problème : il faisait plus de 10 000 caractères, soit 70 % des consignes de mon rédacteur d’articles. Et il ne décrivait pas que la voix, il décrivait aussi la mise en page : sommaire, listes, gras, liens internes. Résultat, les articles produits ressemblaient à des check-lists.

En gros, on l’a coupé de moitié, en ne gardant que la façon dont ça sonne. La même discipline vaut pour l’outil public : un profil trop long noie le modèle qui l’applique, donc sa longueur est plafonnée, et c’est le programme qui garantit ce plafond, pas une consigne donnée au modèle. Un guide de voix qui décide de la mise en page n’est plus un guide de voix.

L’échange, résumé. Moi : mon guide de voix fait 70 % des consignes du rédacteur, il noie le plan, allège-le. Claude : on garde ce qui décrit le son, on sort tout ce qui décide la mise en page.

L'IA multipliait les « Bon, » ; l'auteur, lui, l'écrit moins d'une fois tous les deux articles
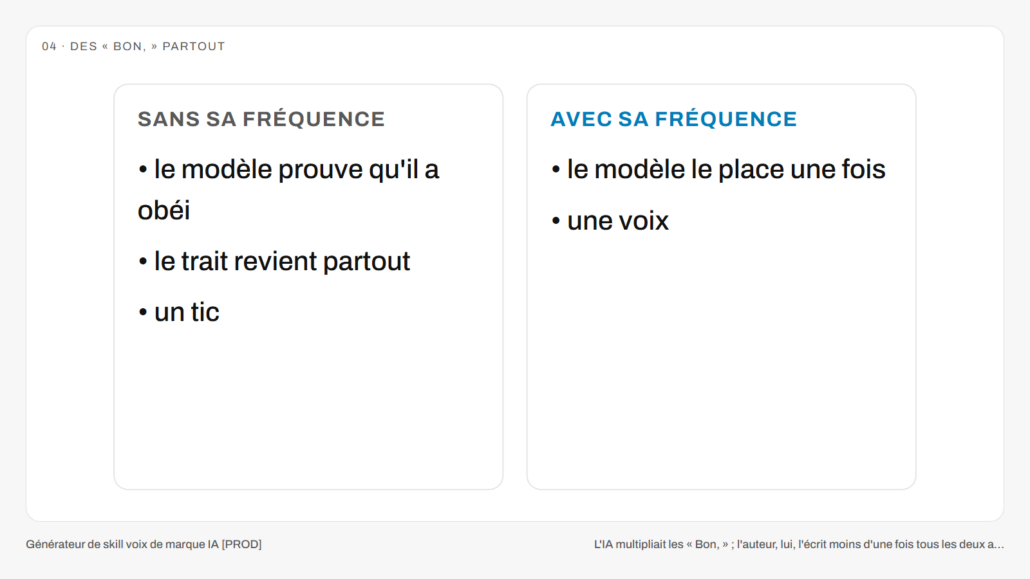
Le même trait sans sa fréquence devient un tic, avec sa fréquence il reste une voix

En relisant des textes générés pour moi, je tombais sur des « Bon, » et des « mécaniquement » bien plus souvent que je ne les écris. Chaque tournure était bien la mienne, mais à cette fréquence, c’étaient devenus des tics.

La cause était dans le guide. Il listait mes tournures sans dire à quelle fréquence je les emploie, et les présentait comme « à réemployer ». Or un modèle à qui on donne une consigne cherche à prouver qu’il l’a suivie, et le plus sûr moyen de le prouver, c’est de rendre le trait visible. Partout. Ce que je voyais comme une description, le modèle l’a lu comme un ordre.

L’échange, résumé. Moi : pourquoi y a-t-il autant de tics dans mes textes générés ? Montre-moi d’où ça vient. Claude : le guide nomme les tournures sans leur dose, et les dit « à réemployer » ; le modèle obéit trop.

Demander à l'IA d'estimer la fréquence d'un trait : zéro réponse sur vingt-cinq

Le modèle qualifie, le code quantifieLe même trait de voix vu par le modèle et par le code. Le modèle repère que « D’ailleurs » revient souvent, le code compte 36 occurrences en 18 articles. Le modèle repère que le lecteur est vouvoyé, le code compte 245 « vous » et aucun « tu ». Le modèle repère des incises pour nuancer, le code en compte une tous les 470 mots.« Le modèle qualifie, le code quantifie. »Ce que le modèle repèreCe que le code compte« D’ailleurs » revient souvent36 fois en 18 articlesLe lecteur est vouvoyé245 « vous », 0 « tu »Des incises pour nuancer1 incise tous les 470 motsRelevé par script sur les 18 articles publiés de Serge Esteves, en octobre 2026.

Pour donner la dose, la solution la plus simple semblait de demander au modèle de l’estimer lui-même, en même temps qu’il repère les traits. On a essayé deux formulations, dont une avec un format imposé et un exemple. Résultat : zéro trait annoté sur 25.

Le modèle repère très bien un style, il n’en mesure pas la densité. Compter, en revanche, c’est exactement ce que sait faire un programme : le rappel de dosage de l’outil est donc écrit par le code, pas demandé au modèle. Ce qu’il faut retenir tient en une phrase : le modèle qualifie, le code quantifie.

L’échange, résumé. Moi : peut-on demander au modèle de noter la fréquence de chaque trait qu’il trouve ? Claude : essayé deux fois, zéro trait annoté sur 25 ; le modèle qualifie, le code quantifie.

Trois règles proposées pour le guide : deux déplacées, une annulée trois minutes après son ajout
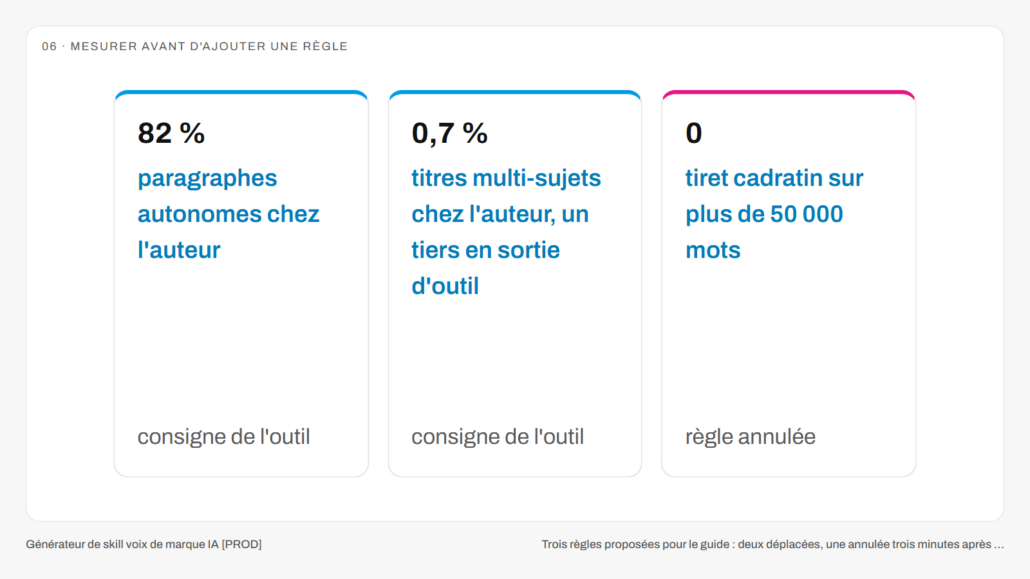
Trois règles mesurées : 82 % de paragraphes autonomes, 0,7 % de titres multi-sujets, zéro tiret cadratin

Plus tard, une autre session de Claude, celle qui rédige mes articles, m’a proposé trois règles à ajouter au guide : des paragraphes qui se comprennent seuls, un seul sujet par titre, jamais de tiret cadratin. Vous me direz : plus de règles, plus de garanties. Pas forcément. Avant d’en accepter une, on l’a comptée sur mes articles publiés.

82 % de mes paragraphes se comprennent déjà seuls, et 0,7 % de mes titres mélangent plusieurs sujets, contre environ un tiers en sortie de mon outil d’enrichissement. Ces deux défauts viennent de l’outil, pas de ma voix : les règles vont donc dans les consignes de l’outil. Le tiret cadratin, lui, n’apparaît jamais dans mes articles. J’ai d’abord validé la règle, puis je l’ai fait retirer trois minutes plus tard : une règle qui interdit ce que personne n’écrit n’apporte rien.

L’échange, résumé. Moi : jamais de tiret cadratin dans mes textes, ajoute-le au guide. Claude : ajouté. Puis j’annule : je n’en écris jamais, la règle n’apporte rien.

245 « vous », zéro « tu » : une voix d'auteur mesurée sur 18 articles
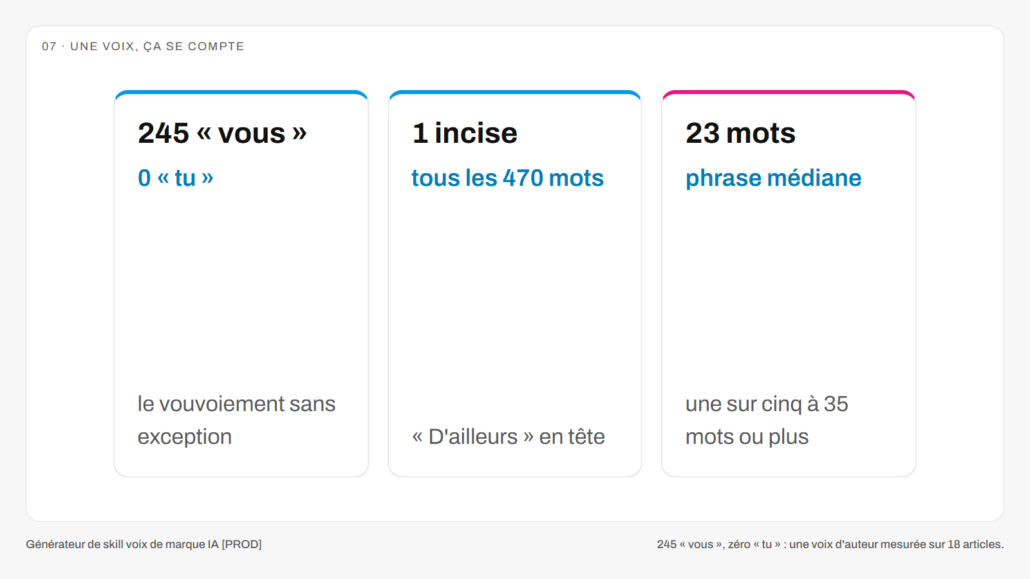
Trois mesures de ma voix : 245 vous et 0 tu, une incise tous les 470 mots, une phrase médiane de 23 mots

Pour l’article de lancement de l’outil, plutôt que de décrire ma voix avec des adjectifs, je l’ai fait compter sur mes 18 articles publiés : pronoms, incises, longueur des phrases. 245 « vous » et pas un seul « tu ». Une incise tous les 470 mots. Une phrase médiane de 23 mots, alors que mes textes aérés donnent une impression de phrases courtes.

Ces chiffres disent mieux qu’un brief comment j’écris, et ils ont une autre vertu : on ne peut pas les inventer. Chaque chiffre de l’article vient du relevé, et l’article lui-même a été relu contre les faits : deux anecdotes inventées par le premier jet ont été retirées avant publication. Tout est détaillé dans l’article Votre voix de marque est déjà dans vos articles publiés.

L’échange, résumé. Moi : écris l’article toi-même, dans ma voix, avec mes vrais chiffres. Claude : tout est relevé par script sur tes 18 articles, et chaque chiffre publié vient de ce relevé.

Une image à la une tirée d'un détail fait croire que l'article se résume à ce détail
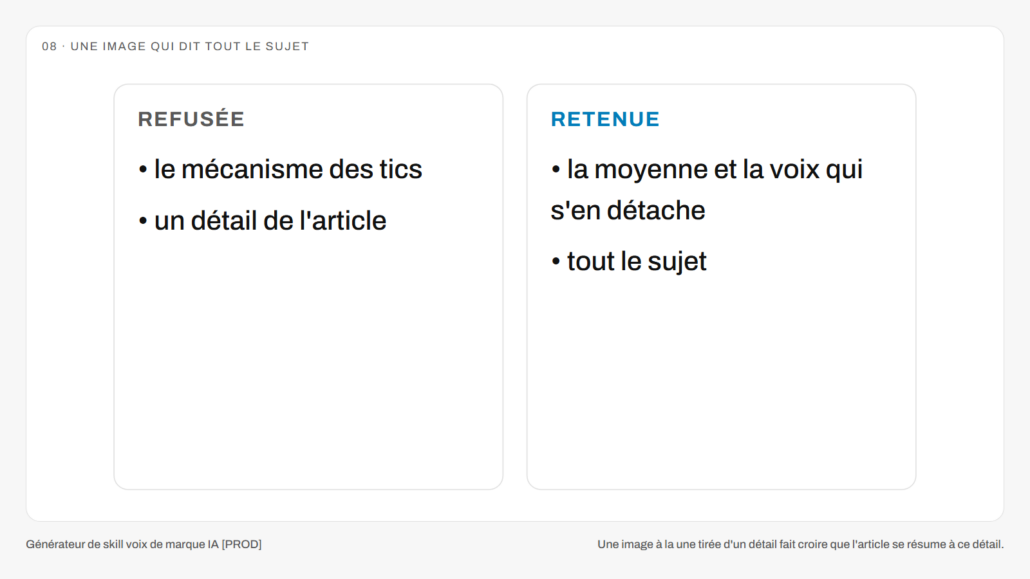
L'image refusée montrait un détail, l'image retenue montre tout le sujet

Dernier épisode, d’ailleurs pas le moins utile. La première image à la une de l’article de lancement reprenait le schéma des tics. Je l’ai refusée : elle réduisait l’article à un seul de ses mécanismes, alors que le sujet, c’est la voix tout entière.

La version retenue montre la masse des contenus qui se ressemblent, et une voix qui s’en détache. Une image à la une doit dire le sujet, pas un de ses détails.

L’échange, résumé. Moi : cette image est réductrice, elle doit représenter l’article dans son ensemble. Claude : nouvelle carte, tirée du schéma « La moyenne n’a la voix de personne ».

Ce qu'il faut retenir

  • Quand vous donnez un trait de style à une IA, donnez aussi sa fréquence : sans dose, elle l’applique partout pour prouver qu’elle a obéi.
  • Laissez l’IA repérer les traits, et comptez-les vous-même : elle qualifie très bien, elle ne quantifie pas.
  • Mesurez une règle sur vos textes avant de l’écrire : si vous ne produisez jamais le défaut, la règle n’a pas d’objet.
  • Gardez votre guide de voix court et centré sur le son : la mise en page se décide ailleurs.

Questions fréquentes

À quoi sert un générateur de voix de marque ?

À donner à une IA une description précise de votre façon d’écrire, tirée de vos propres textes, pour que ce qu’elle rédige sonne comme vous plutôt que comme la moyenne.

Combien d'articles faut-il pour extraire sa voix ?

Trois au minimum, cinq au plus. En dessous de trois, une tournure propre à un seul texte passe facilement pour un trait de voix.

Pourquoi une IA exagère-t-elle certains traits de style ?

Parce qu’on les lui donne sans fréquence. Un modèle cherche à montrer qu’il a suivi la consigne, et il place le trait aussi souvent qu’il le peut.

L'outil est-il gratuit ?

Oui. Une première génération est possible sans compte, puis avec un compte gratuit sur creapulse.fr.

Et maintenant ?

L’outil est en ligne et gratuit. Il reste une ligne de mon guide de voix à corriger : elle affirme une proportion que je n’ai pas réussi à retrouver en comptant, et elle n’a donc rien à faire dans un guide qui se veut mesuré. Je compléterai cet article à chaque nouvelle étape.

Extrayez votre voix de marque à partir de trois de vos articles, gratuitement.

Une liste curée d'experts SEO / GEO à suivre, classés par leurs pairs et non par leur notoriété, mise à jour chaque mois.

En bref

  • Une liste de 28 « experts AI search » publiée par un blog a été confrontée aux citations réelles entre ses membres, sur trente jours, sur X puis sur LinkedIn.
  • 2 514 posts analysés (1 980 sur X, 534 sur LinkedIn) pour 1,665 $ de données au total.
  • Le compte le plus relayé par ces experts ne figure pas dans la liste : 125 citations, par 13 des 20 comptes actifs.
  • LinkedIn ne permet pas de classer qui que ce soit par citations, mais il réhabilite deux personnes que X faisait passer pour inactives.
  • La décision la plus rentable n’était pas technique : « aucun paramètre chiffré en dur ». Elle a révélé un calcul faux en dix minutes.

Article fil rouge — dernière mise à jour : 12 octobre 2026 · statut : mesure faite, automatisation mensuelle à câbler. Ce qui a changé : première publication.

Pourquoi j'ai refusé de croire une liste d'experts

Bon, je vais être direct : une liste de « X experts à suivre », ça mesure la notoriété de ceux qui y figurent, et c’est à peu près tout. Ça ne dit pas qui est réellement lu par ses pairs, ni qui publie de l’information plutôt que sa propre promotion.

Le point de départ, c’est un article d’iloveseo.net qui liste 28 spécialistes de la recherche par IA. Je voulais en ajouter quelques-uns à ma liste de veille, mais seulement ceux qui diffusent de l’actualité substantielle. Deux critères donc, à croiser : être cité par les autres, et publier autre chose que soi-même.

Plutôt que de trancher à l’intuition, on a mesuré. Je vais raconter ici comment, avec les chiffres, et surtout avec les trois endroits où la méthode s’est trompée avant de se corriger. Parce que c’est là que ça devient intéressant.

Une liste d'experts mesure la notoriété, jamais si leurs pairs les citent vraiment

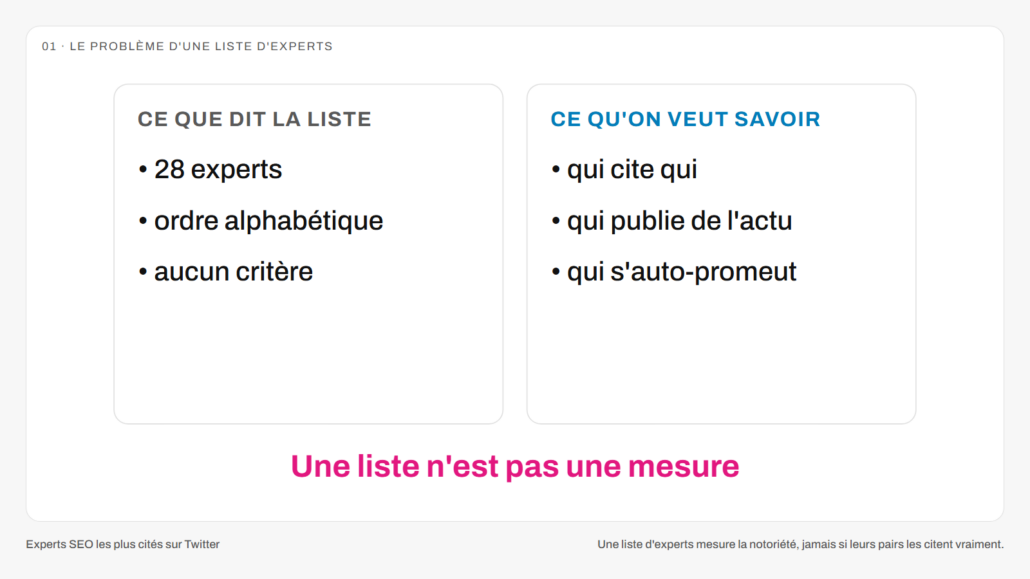
Comparaison entre ce que dit la liste d'experts et ce qu'on veut réellement savoir
Une liste n'est pas une mesure.

Le premier réflexe, c’est de poser la question correctement. La liste donne 28 noms, dans l’ordre alphabétique, sans critère. Ce qu’on veut savoir, c’est qui cite qui, qui publie de l’actu, et qui s’auto-promeut.

Ce qui s’est dit — Moi : regarde ces 28 personnes, dis-moi lesquelles sont les plus citées entre elles. Claude : il faut d’abord retrouver leurs comptes, puis compter les citations réelles sur trente jours.

Pour faire simple : avant de compter quoi que ce soit, il faut un corpus. Trente jours de publications pour chacun des 28, et une définition claire de ce qu’on appelle une citation.

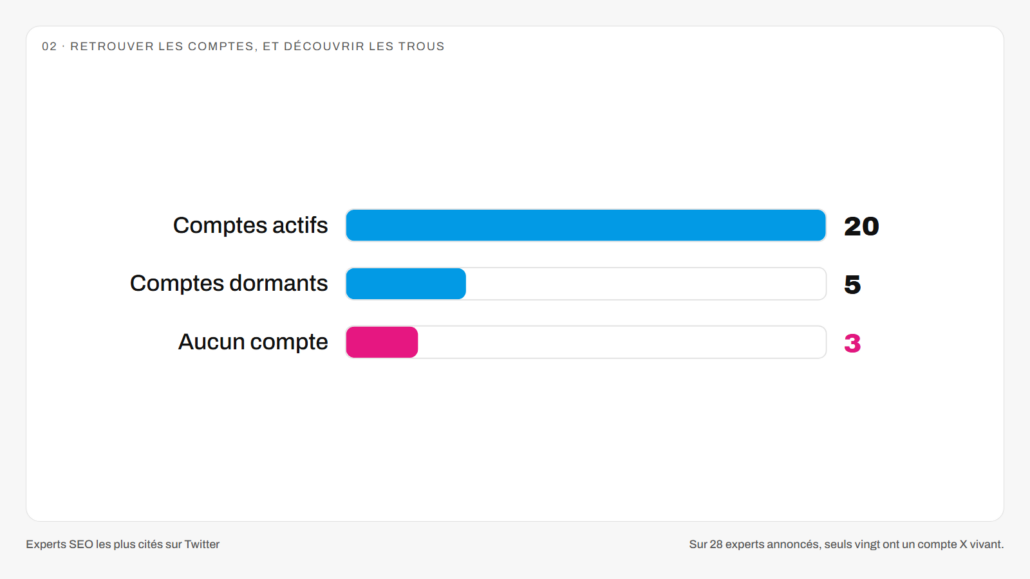
Sur 28 experts annoncés, seuls vingt ont un compte X vivant

Vingt comptes actifs, cinq comptes dormants, trois personnes sans compte X
Vingt comptes actifs, cinq dormants, trois introuvables.

Première surprise, avant même d’analyser quoi que ce soit : retrouver les comptes. La liste était bâtie sur LinkedIn, pas sur X. Une sonde automatisée à six millièmes de dollar sur 24 hypothèses de pseudos, puis onze recherches web pour les cas difficiles, et voilà le bilan : 25 comptes trouvés, 3 personnes sans aucun compte, 5 comptes abandonnés depuis des mois.

Ce qui s’est dit — Moi : cherche-les sur X et analyse leurs trente derniers jours. Claude : vingt-cinq comptes trouvés, trois introuvables, cinq dormants, le plus récent depuis janvier 2025.

À noter que l’un des experts a deux comptes, le sien et celui de son agence. Il a fallu les fusionner pour le comptage, sinon il aurait été compté deux fois, ou pas du tout.

Répondre à quelqu'un ajoute son nom automatiquement : ce n'est pas une citation

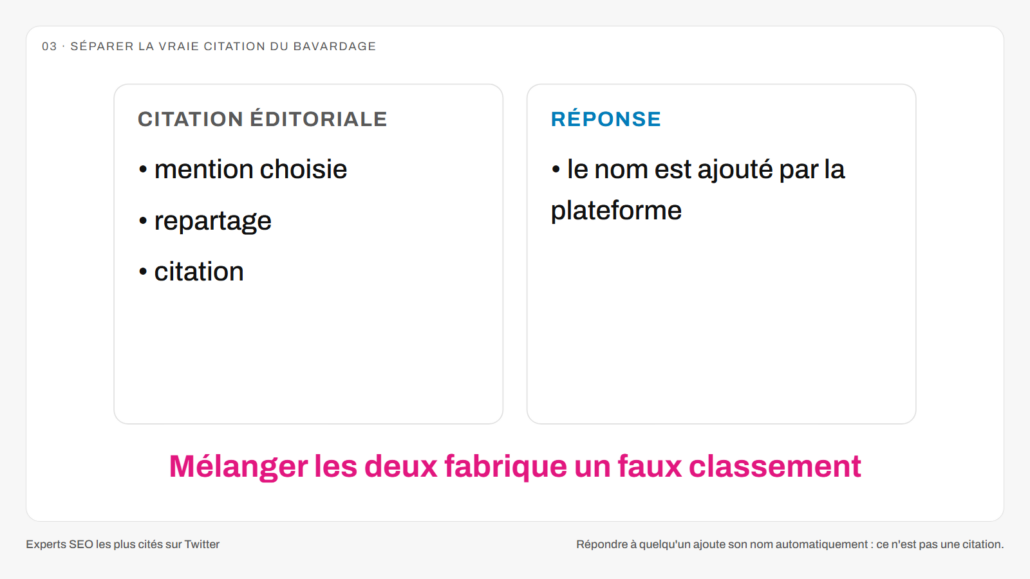
Différence entre une citation éditoriale et une réponse où la plateforme ajoute le nom
Mélanger les deux fabrique un faux classement.

C’est le piège classique des comptages de mentions. Sur X, quand vous répondez à quelqu’un, son nom est inséré automatiquement dans votre message. Deux personnes qui discutent beaucoup gonflent donc leur score mutuel sans qu’aucune des deux n’ait décidé de citer l’autre.

On a donc séparé deux choses : les mentions éditoriales, celles d’un post original, d’un repartage ou d’une citation, et les réponses, où le nom est ajouté par la plateforme. Et on a ajouté un deuxième compteur, le nombre de pairs distincts : dix citations par dix personnes différentes valent plus que dix citations par une seule.

Ce qui s’est dit — Moi : je veux ceux qui balancent de l’actu intéressante, pas seulement de l’auto-promotion. Claude : alors on compte aussi les pairs distincts.

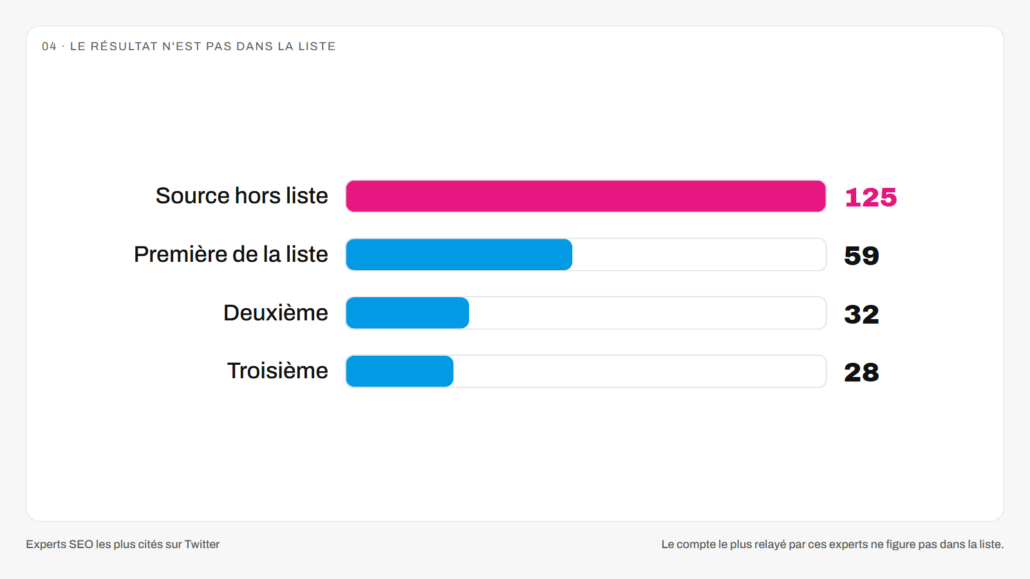
Le corpus X : 1 980 posts sur trente jours, du 12 septembre au 12 octobre 2026, pour 0,297 $. Le classement qui en sort est net, avec une vraie séparation en tête : 59 citations pour la première, puis 32, puis 28.

Le compte le plus relayé par ces experts ne figure pas dans la liste

La source hors liste reçoit 125 citations contre 59 pour la première de la liste
125 citations pour un compte absent de la sélection.

Et voilà le résultat qui justifie tout le reste. Treize des vingt comptes actifs relaient la même personne, et cette personne n’est pas dans la liste des 28. Cent vingt-cinq citations, contre 59 pour la mieux classée de la liste.

Ce qu’il faut retenir, c’est que les experts de la liste commentent l’information. Quelqu’un d’autre la produit. Si vous ne deviez ajouter qu’un compte à votre veille, ce serait celui-là, et aucune liste ne vous l’aurait donné.

Ce qui s’est dit — Moi : l’idée est de les ajouter à ma liste de veille. Claude : alors commence par celui qu’ils relaient tous, et qui n’est pas dans la liste de départ.

Les mentions LinkedIn sont nombreuses, mais elles sortent du groupe étudié

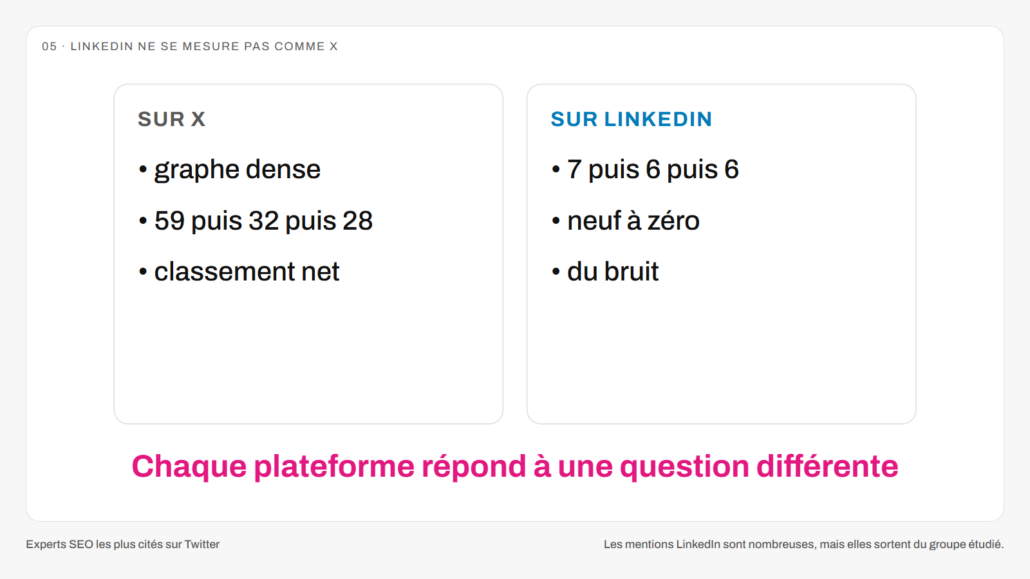
Sur X un graphe de citations dense, sur LinkedIn un graphe trop clairsemé pour classer
Chaque plateforme répond à une question différente.

La liste de départ venait de LinkedIn, donc logique d’y refaire la mesure. On s’attendait au même graphe de citations. Ça n’a pas marché, et c’est une vraie leçon.

Les mentions y sont denses, 403 pour 399 posts, mais elles pointent massivement vers l’extérieur du groupe. Entre les 28, le graphe plafonne à sept citations, avec neuf personnes à zéro. Impossible de classer qui que ce soit là-dessus. Pour faire simple, X est une clique, LinkedIn est un réseau ouvert.

Ce qui s’est dit — Moi : analyse aussi leurs profils LinkedIn, la liste vient de là. Claude : testé, les mentions sont denses mais dispersées, donc LinkedIn servira à autre chose.

Décision : deux classements, jamais fusionnés. X trié par citations reçues, LinkedIn par engagement. Un score composite aurait additionné deux signaux qui n’ont rien à voir.

Deux experts jugés inactifs sur X sont parmi les plus actifs sur LinkedIn

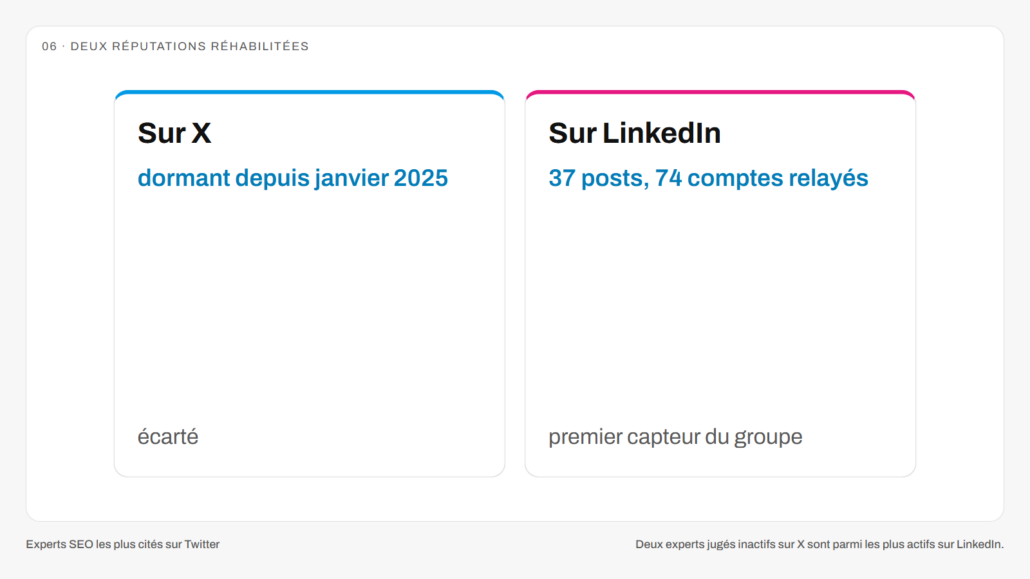
Un même profil dormant sur X et premier capteur de sources sur LinkedIn
Le verdict change quand on change de plateforme.

C’est l’autre apport de LinkedIn, et il est concret. Une personne n’avait rien publié sur X depuis janvier 2025 ; sur LinkedIn, elle relaie 74 comptes par mois, ce qui en fait le premier capteur de sources neuves du groupe. Une autre, elle aussi silencieuse sur X, obtient le meilleur engagement des 28 sur LinkedIn.

Une analyse mono-plateforme les jugeait sur un terrain qu’elles avaient quitté. Vous me direz que c’est évident une fois écrit. Ça ne l’était pas avant la mesure.

Ce qui s’est dit — Moi : après tout, la liste de départ vient de LinkedIn, logique d’y mesurer leur pertinence. Claude : tu avais raison, deux profils changent complètement de verdict.

Au passage, une source neuve est apparue : citée par cinq membres distincts, soit plus que n’importe quel membre de la liste. Avec une nuance honnête, deux des cinq sont ses collègues.

Aucun paramètre chiffré en dur : tout se recalcule, sinon la mesure ment

Un paramètre dérivé mais faux est pire qu'une constante en dur, parce qu'il ne se voit pas
La consigne qui a trouvé un bug.

On arrive au moment le plus instructif. Pour passer de « combien de citations » à « quel engagement, quelle portée », il faut des seuils. La première version les posait en dur : tel pourcentage, telle valeur. J’ai refusé. Ce qui est vrai d’un domaine ne l’est pas d’un autre, donc tout doit être recalculé sur les données du mois, ou déclaré comme valeur importée avec sa provenance.

Appliquer cette règle a immédiatement révélé un calcul défaillant. L’estimation de l’âge auquel les interactions d’un post se stabilisent renvoyait « un jour ». Plausible. Faux. Une coupe transversale sur des posts différents ne peut pas mesurer une accumulation : la variance entre posts écrase tout. Et ce chiffre faux avait changé en silence un tiers du corpus analysé, 571 posts jugés exploitables au lieu de 429.

Ce qui s’est dit — Moi : aucun paramètre en dur. Claude : appliqué, et ça a attrapé un calcul faux mais plausible que rien ne signalait.

Un paramètre dérivé mais faux est pire qu’une constante en dur, parce qu’il ne se voit pas. Depuis, chaque dérivation automatique porte un test de validité et un repli déclaré. C’est écrit dans la spec, et c’est transférable bien au-delà du SEO.

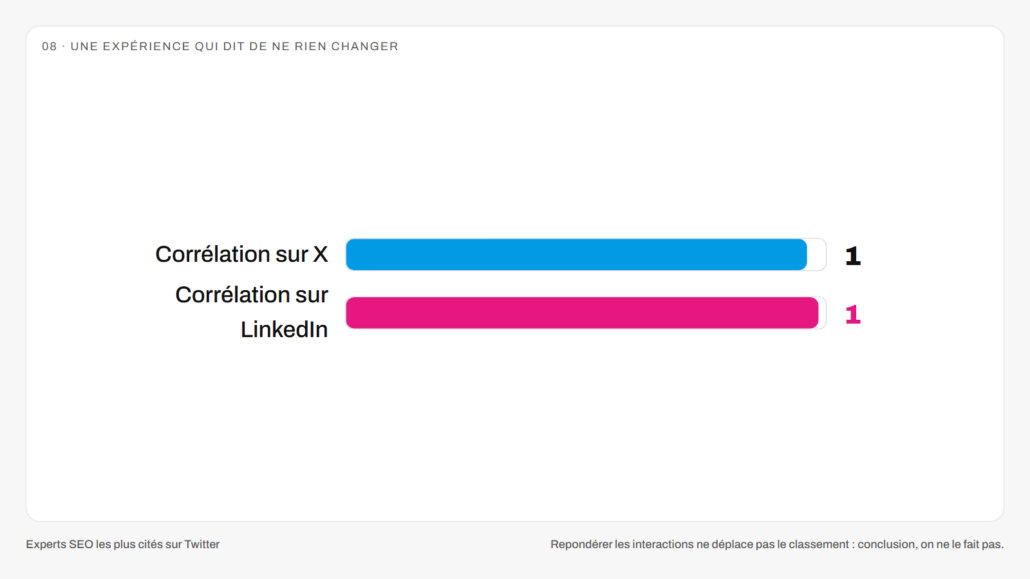
Repondérer les interactions ne déplace pas le classement : conclusion, on ne le fait pas

Corrélation de 0,96 sur X et 0,985 sur LinkedIn entre les deux variantes de poids
0,96 sur X, 0,985 sur LinkedIn.

Une autre idée séduisante : pondérer chaque type d’interaction par sa rareté, plutôt que d’utiliser des poids simples de 1, 3 et 5. Les poids dérivés sortent deux à quatre fois plus élevés. Et le classement des personnes ne bouge pas : corrélation de 0,96 sur X et 0,985 sur LinkedIn entre les deux variantes.

Ce qui s’est dit — Moi : compare la variante dérivée aux poids simples. Claude : les poids n’ont aucun effet utile sur le classement.

Les trois types d’interaction sont trop corrélés pour que la pondération compte. Donc on ne change rien, et l’idée est rangée ailleurs : qualifier la forme de l’engagement d’un post, pas classer des personnes. Une expérience qui conclut « ne touchez à rien » est une bonne expérience.

Sept zones de la page se rafraîchissent chaque mois sans toucher au texte

Pipeline de mesure d’influence X + LinkedInDeux sources, les posts X et les posts LinkedIn avec leurs abonnés, sont analysées séparément, citations croisées d’un côté et engagement de l’autre, puis un recalcul des paramètres sur le corpus du mois alimente les sept zones dynamiques d’une page WordPress dont le texte rédactionnel reste intact.UN PASSAGE MENSUEL, 1,665 $ DE DONNÉESPAGE WORDPRESS DE VEILLE1 980 POSTS534 POSTSCITATIONSENGAGEMENTCHAQUE MOISSOURCEPosts X, 30 joursscraper du Store ApifySOURCEPosts LinkedIn + abonnésposts et profilsANALYSECitations croiséesmentions, pairs distinctsANALYSEEngagement et découvertepas de classementRÈGLERecalcul des paramètressur le corpus du moisseuils en quantilesratio vues/abonnés mesuréaucun chiffre en durJAMAIS FUSIONNÉSREMPLACÉ7 zones dynamiquestableaux, scores, sourcesINTACTTexte rédactionneljamais réécritLÉGENDESource de donnéesAnalyse par plateformeRègle qui gouverne toutMis à jour chaque moisCHIFFRES MESURÉS LE 12/10/2026 · 28 EXPERTS · 1 980 POSTS X · 534 POSTS LINKEDIN
Le pipeline de mesure : deux sources analysées séparément, un recalcul des paramètres sur le corpus du mois, puis sept zones de la page remplacées sans toucher au texte rédactionnel. Mesures du 12 octobre 2026.

Une mesure faite une fois vieillit vite. La page de veille qui en est sortie est donc conçue pour être rafraîchie chaque mois : les tableaux, les scores et les sources émergentes vivent dans sept zones balisées qu’un automate remplace. Le texte rédigé, lui, reste figé.

Le piège, c’est l’ordre. Si les sections par personne étaient rangées par rang, le texte contredirait les tableaux dès la deuxième mise à jour. Elles sont donc rangées par palier de verdict, jamais par position.

Ce qui s’est dit — Moi : ça pourrait être une page dynamique mise à jour chaque mois ? Claude : oui, et le piège est l’ordre du texte, à découpler de celui des données.

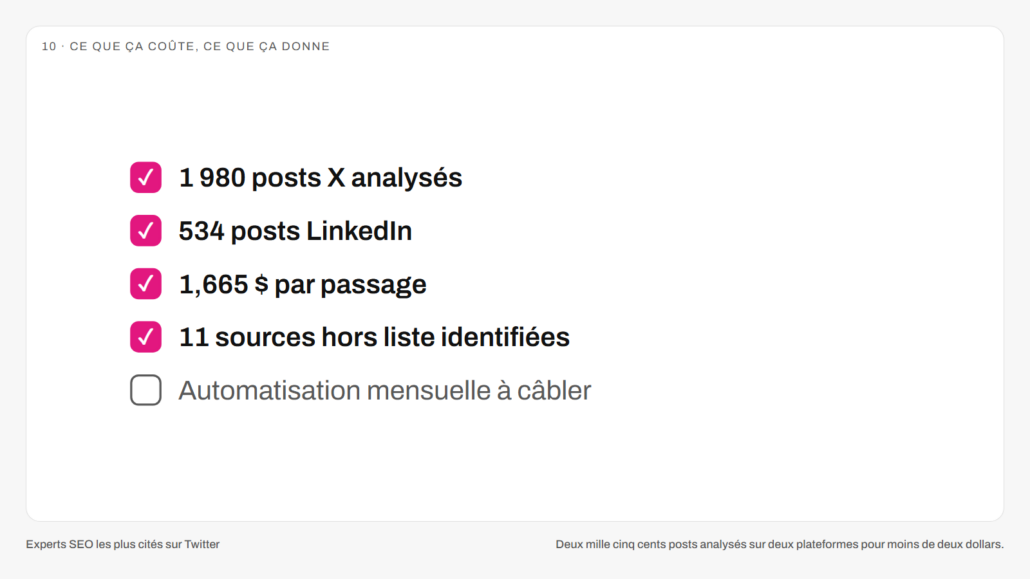
Deux mille cinq cents posts analysés sur deux plateformes pour moins de deux dollars

Bilan du pipeline : posts analysés, coût du passage, sources hors liste identifiées
Ce qui est fait, ce qui reste.

Le coût total du passage : 1,665 $. Dans le détail, 0,006 $ pour résoudre les comptes, 0,297 $ pour les 1 980 posts X, 0,002 $ pour vérifier les comptes dormants, 0,180 $ pour le test LinkedIn, 1,068 $ pour les 534 posts LinkedIn, et 0,112 $ pour les abonnés. Mesuré le 12 octobre 2026.

Ce que ça produit : un classement par citations sur X, des scores d’engagement sur les deux plateformes, et surtout onze sources hors liste que les listes d’experts ne donnent jamais. Repérer une source avant qu’elle soit sur les listes, c’est exactement le différenciateur d’un service de veille.

Ce qui s’est dit — Moi : à terme, cette page pourra renvoyer vers mon service de veille d’influenceurs. Claude : c’est exactement le différenciateur.

Ce qu'il faut retenir

  • Une liste d’experts n’est pas une mesure. Les citations croisées réelles disent qui produit l’information, et la réponse peut être hors de la liste.
  • Un paramètre dérivé automatiquement est plus dangereux qu’une constante en dur quand il est faux mais plausible : il déplace tout en silence. Chaque dérivation mérite un test de validité.
  • Le graphe de citations ne se transpose pas d’une plateforme à l’autre. X est une clique, LinkedIn un réseau ouvert : mesurez chaque plateforme pour ce qu’elle sait dire.
  • « Qui on lit » n’est pas « qui on observe ». Les comptes les moins intéressants à suivre sont souvent les meilleurs capteurs de sources neuves.

Questions fréquentes

Pourquoi ne pas simplement compter les mentions ?

Parce qu’une réponse sur X insère le nom de l’interlocuteur automatiquement. Compter toutes les mentions revient à mesurer qui discute avec qui, pas qui cite qui.

Pourquoi deux classements au lieu d'un score unique ?

Parce que les deux plateformes ne mesurent pas la même chose. Sur X, le graphe de citations est dense et séparant. Sur LinkedIn, il est trop clairsemé pour classer, mais l’engagement y est riche. Additionner les deux aurait fabriqué un chiffre sans signification.

Combien ça coûte de refaire la mesure ?

1,665 $ par passage pour 28 personnes sur deux plateformes, données d’octobre 2026. Les posts sont achetés à l’unité auprès de scrapers du Store Apify.

Peut-on appliquer ça à une autre liste, dans un autre secteur ?

Oui, c’est précisément pour ça qu’aucun paramètre n’est écrit en dur : seuils et quantiles se recalculent sur le corpus du mois.

Est-ce que ça remplace le jugement éditorial ?

Non. La mesure dit qui est relayé et qui publie de l’actualité. Décider qui mérite votre attention reste votre affaire, avec de meilleures cartes en main.

Et maintenant ?

La mesure est faite, la page de veille existe en brouillon, et il reste à câbler l’automatisation mensuelle qui remplacera les sept zones. Cet article suivra : à chaque étape franchie, une ligne datée en tête dira ce qui a changé.