Clustering concurrentiel : la topical map que dessinent Google et ses réponses IA
Clustering concurrentiel : la topical map que dessinent Google et ses réponses IA
En bref
Article mis à jour le
- Clustering concurrentiel est un outil d’analyse concurrentielle SEO et GEO, en ligne sur creapulse.fr : il construit votre topical map (piliers, sous-sujets, angle et plan H2) à partir de vos vrais concurrents.
- Les requêtes sont regroupées par recoupement des résultats Google : deux requêtes vont ensemble quand leur top 10 partage au moins 4 pages. Pas par ressemblance des mots.
- Les sous-sujets et leurs H2 sont tirés des sections des réponses IA de Google (AI Overview, AI Mode).
- C’est vous qui validez vos concurrents : sur un site de niche, 799 recherches Google ne donnaient que 9 piliers tant que des généralistes faussaient l’analyse.
- Une analyse dure 10 à 15 minutes, et 2 crédits sont offerts à l’inscription.
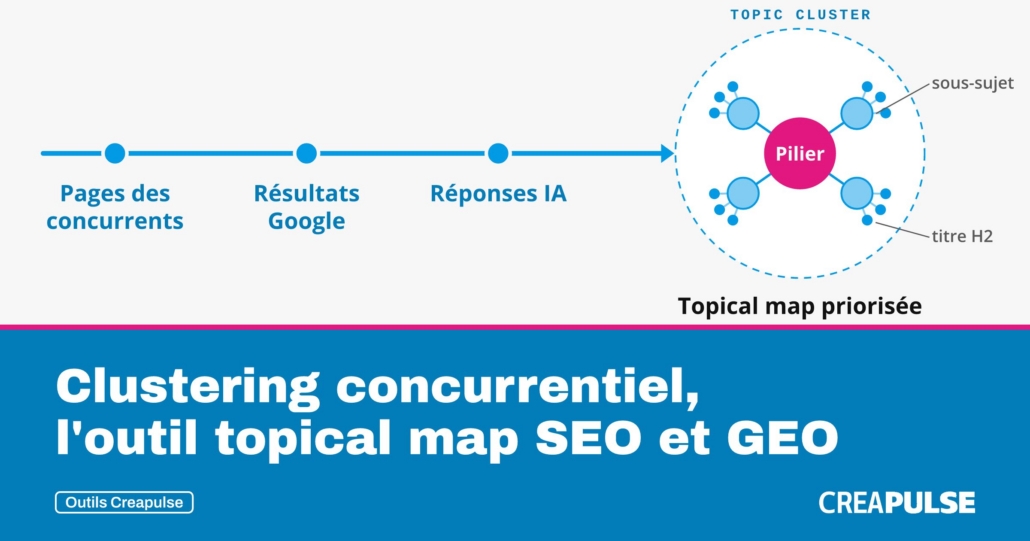
Clustering concurrentiel est le nouvel outil de creapulse.fr. Vous donnez l’adresse de votre site ; il lit les meilleures pages de vos concurrents, demande à Google quelles requêtes relèvent d’une même page, puis laisse ses réponses IA dessiner les sous-sujets et leur plan. Ce que vous récupérez, c’est une topical map : la carte des pages à écrire, classées par priorité.
Pour faire simple, je voulais un outil qui dise quoi écrire, pas un export de mots-clés de plus à trier dans Excel. Il m’a fallu six semaines d’essais pour y arriver, avec des méthodes gardées et beaucoup de méthodes jetées. Je vous raconte ici les deux, parce que c’est dans ce qui n’a pas marché qu’on comprend pourquoi le reste marche.
Le vrai livrable n'est pas un groupe de mots-clés, mais la page à créer ou à optimiser
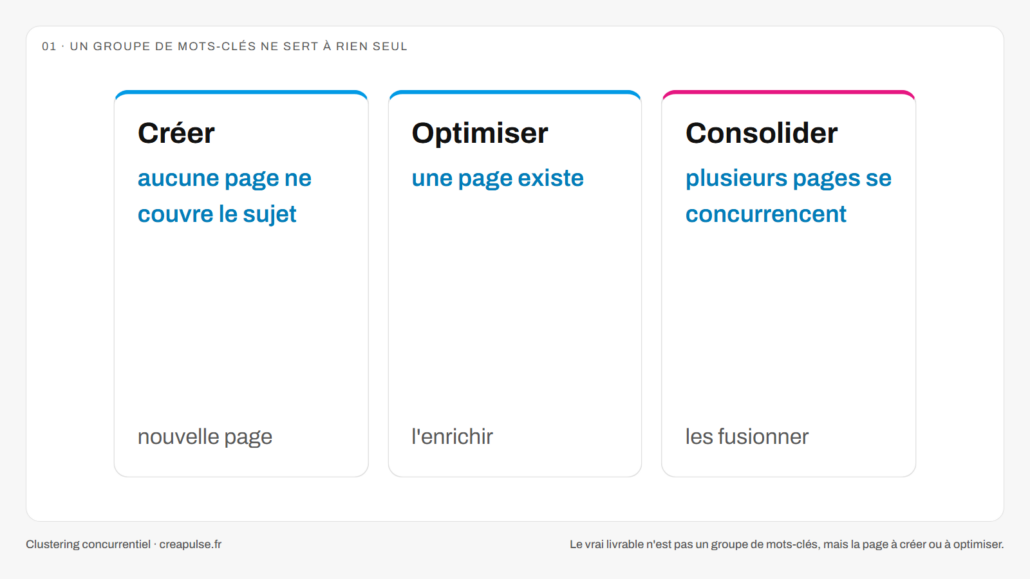
Le projet est parti de là où partent la plupart des SEO : les requêtes Search Console d’un site, regroupées par thème. Sauf qu’un groupe de mots-clés, tout seul, ne sert à rien. Ce qui compte, c’est la décision qui va avec : créer une page parce qu’aucune ne couvre le sujet, enrichir celle qui existe, ou fusionner deux pages qui se marchent dessus (la fameuse cannibalisation).
Chaque groupe croise donc ses requêtes avec les pages du site, et reçoit une action et une priorité. Premier enseignement au passage : un premier méta-regroupement, qui rassemblait les groupes par similarité, rangeait « crawl seo » sous « migration seo ». Faux rattachement, abandonné. Règle retenue : un groupe, un pilier.
Moi : Je veux une décision par groupe : créer, optimiser ou consolider, avec l’URL concernée.
Ce qui s'est dit, en résumé
Claude : Chaque groupe croise ses requêtes avec les pages du site et reçoit une action et une priorité.
Pour trouver ce qui manque à un site, mieux vaut lire les pages de ses concurrents
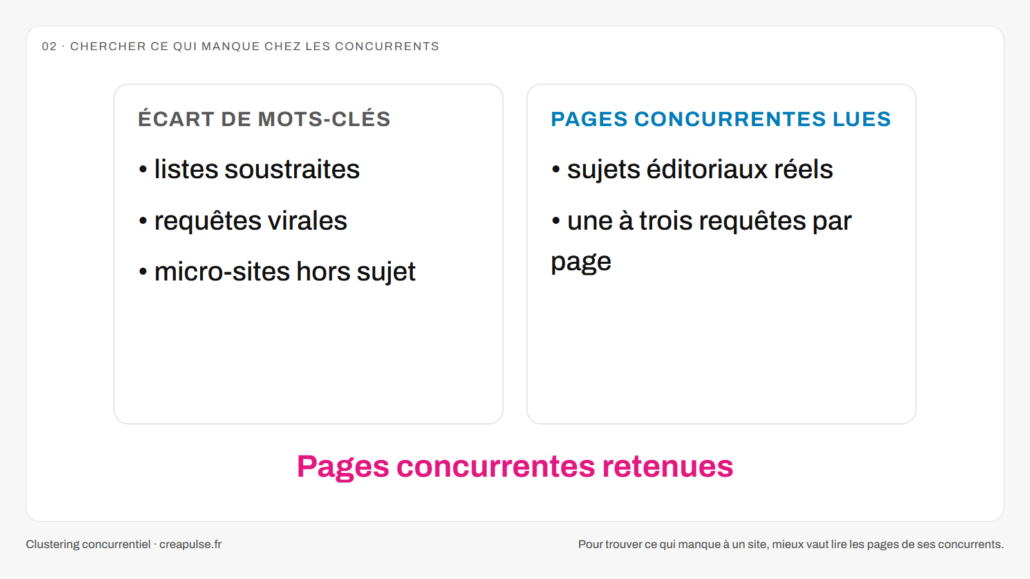
Chercher ce que le site ne couvre pas, c’est l’étape suivante. La méthode classique, c’est l’écart de mots-clés : on prend les mots-clés des concurrents, on retire ceux du site, et on regarde ce qui reste. En pratique, ce qui restait, c’était du bruit : des requêtes virales sans rapport, des micro-sites hors sujet. Et le peu qui tenait debout recoupait les piliers qu’on avait déjà.
Alors on a changé d’angle : lire les meilleures pages éditoriales des concurrents, une par une, et en extraire les une à trois requêtes qu’un internaute taperait vraiment pour tomber dessus. Là, on voit apparaître de vrais sujets éditoriaux. C’est à ce moment-là que l’outil « clustering concurrentiel » est né. (Si le sujet des idées de contenu vous intéresse plus largement, j’en parlais déjà dans mon guide des outils pour trouver des idées de contenu.)
Moi : Et si on lisait directement les meilleures pages des concurrents pour en tirer les sujets ?
Ce qui s'est dit, en résumé
Claude : Chaque page lue donne une à trois requêtes réelles ; l’écart de mots-clés classique est abandonné.
Regrouper par le sens des mots crée des fourre-tout ; seul Google sait ce qui va ensemble
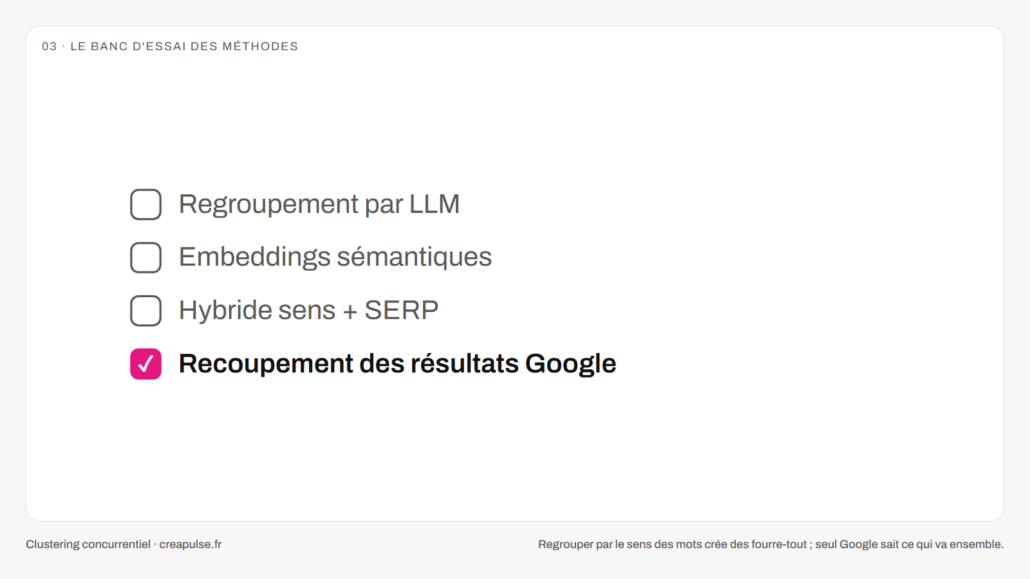
Une fois les requêtes en main, il faut les regrouper, et chaque groupe doit correspondre à une seule page à écrire. J’ai mis plusieurs méthodes sur le banc d’essai, avec les mêmes requêtes : regroupement par un LLM, par embeddings (une représentation mathématique du sens des mots), par texte enrichi, découpage par LLM, et un hybride embeddings + résultats Google.
Verdict : toutes les méthodes qui regroupent « par le sens » produisent des méga-groupes fourre-tout. Un réglage de sensibilité faisait même tout basculer d’un coup en un seul groupe. Et l’hybride, loin d’additionner les qualités, se dégradait. La seule méthode qui capte l’intention de recherche, c’est le recoupement des résultats Google. Et c’est assez logique quand on y pense : c’est Google lui-même qui dit quelles requêtes une même page peut satisfaire, puisqu’il leur montre les mêmes pages.
Moi : Quelle méthode regroupe vraiment les requêtes qu’une seule page peut satisfaire ?
Ce qui s'est dit, en résumé
Claude : Le recoupement des résultats Google : les autres méthodes fusionnent des intentions différentes.
Deux requêtes vont ensemble quand Google leur montre au moins quatre pages communes
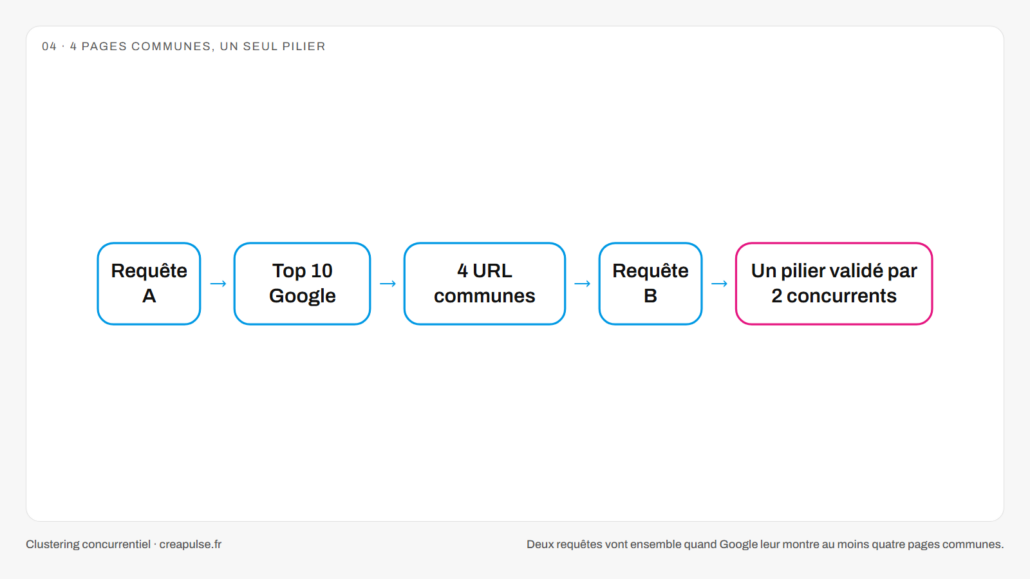
Concrètement, l’outil compare le top 10 Google de chaque requête. À partir de quatre URL communes, une même page peut satisfaire les deux requêtes : elles rejoignent le même pilier. Le seuil était à trois au départ ; il est passé à quatre après une fusion abusive repérée à la relecture. Un point de plus, et deux sujets distincts cessaient de se coller.
Deuxième garde-fou, le consensus : un pilier n’est gardé que si au moins deux concurrents distincts le travaillent. Un sujet que personne ne traite n’est pas une opportunité prouvée, c’est un pari. Même logique entre pilier et sous-sujet : on les considère en doublon dès qu’ils partagent au moins 2 URL dans le top 5, ou 3 dans le top 10 (un seuil calibré sur de vraies SERP françaises, pas au doigt mouillé).
Moi : Comment l’outil décide-t-il que deux requêtes différentes appartiennent au même pilier ?
Ce qui s'est dit, en résumé
Claude : Quatre URL communes dans le top 10, et au moins deux concurrents distincts qui couvrent le sujet.
Les sections des réponses IA de Google révèlent les sous-intentions d'un sujet
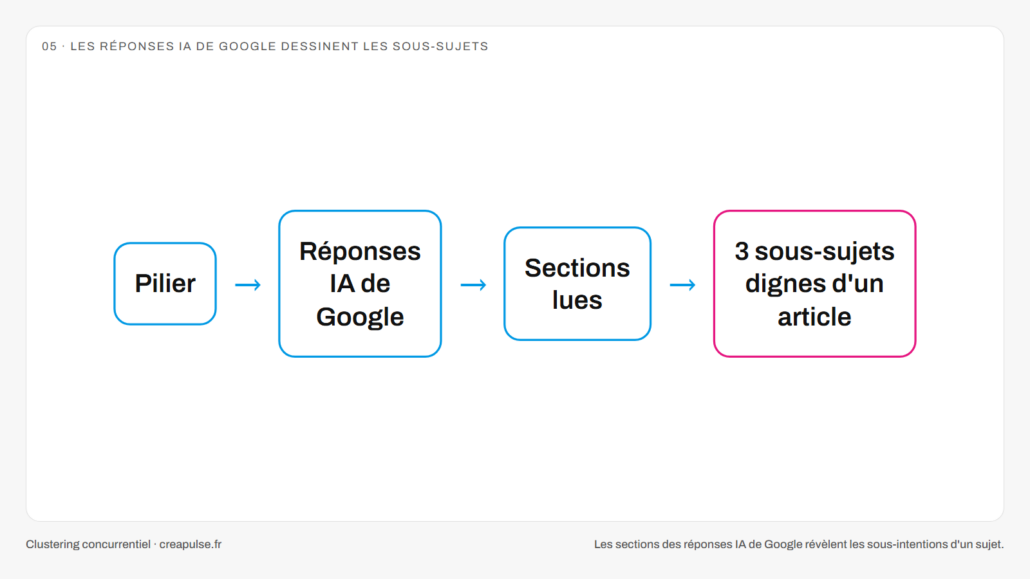
Un pilier, c’est une page de fond. Mais autour, il faut des sous-sujets qui méritent chacun leur page. Les suggestions génériques (les « autres questions posées », les recherches associées) donnaient des sous-sujets trop plats. L’idée qui a tout changé : interroger chaque pilier dans les réponses IA de Google, l’AI Overview (la réponse générée en haut des résultats) et l’AI Mode, avec 2 à 4 formulations.
Leurs sections montrent comment Google découpe un sujet, autrement dit les sous-intentions qu’il y associe. Un LLM les regroupe ensuite en trois sous-sujets maximum, avec un test simple : un rédacteur écrirait-il un article complet dessus ? Au départ, l’outil en proposait cinq, trop pointus, au niveau d’un simple H2. Sur un run de contrôle, une réponse IA a été trouvée pour 17 piliers sur 17. C’est là que l’outil devient aussi un outil GEO : vous n’écrivez pas ce qu’un modèle imagine sur votre marché, vous écrivez ce que Google affiche déjà à vos lecteurs.
Moi : Les sections des réponses IA pourraient devenir de nouvelles pages, donc de nouveaux sous-sujets, non ?
Ce qui s'est dit, en résumé
Claude : Oui : on les regroupe en trois sous-sujets maximum, chacun assez riche pour un article complet.
Les sections trop étroites pour une page deviennent le plan H2 d'un sous-sujet
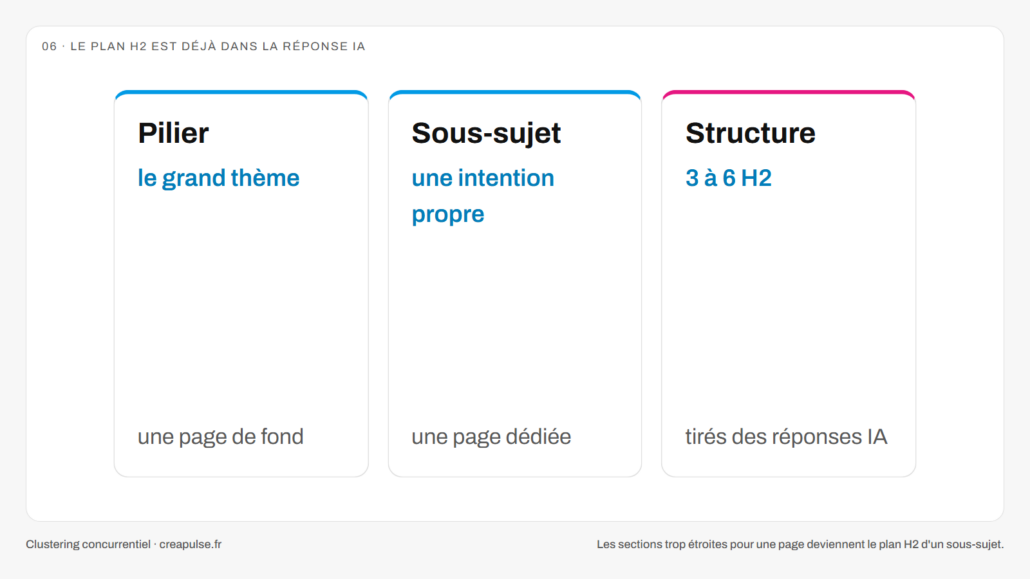
Et les sections trop petites pour mériter une page ? Plutôt que de les jeter, on les recycle : elles deviennent les titres H2 du sous-sujet auquel elles se rattachent. Chaque sous-sujet reçoit ainsi 3 à 6 H2, soit un mini-brief lisible d’un coup d’œil.
Dernière règle, et pas la moins importante : anti-cannibalisation. Deux sous-sujets ne doivent jamais pouvoir se positionner sur la même page de résultats. Sinon, vous écrivez deux articles qui se disputent la même place, et aucun des deux ne la prend. Sous-sujets et structure ont été jugés de qualité livrable dès le run du 2 septembre.
Moi : On garde les sections trop petites comme H2 des sous-sujets, pour avoir un brief rapide ?
Ce qui s'est dit, en résumé
Claude : Chaque sous-sujet reçoit 3 à 6 titres H2, et deux sous-sujets ne visent jamais la même SERP.
Deux concurrents généralistes suffisaient à valider des sujets hors cible, comme le smic
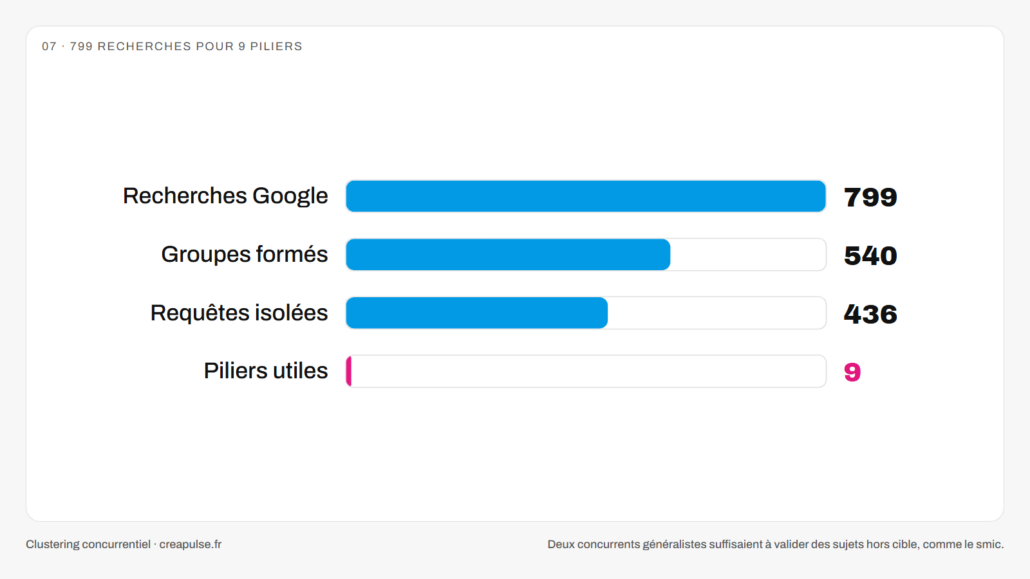
Le vrai test, c’était un cas de niche : le site d’un cabinet d’avocats spécialisé en RGPD. Et là, surprise : 799 recherches Google ne donnaient que 9 piliers. On a disséqué le run : 540 groupes formés, 436 requêtes restées isolées, 258 fusionnées, et au bout, 9 piliers. Pas terrible pour ce que ça coûte en données.
Le coupable, c’était le consensus lui-même. Des concurrents généralistes (portails publics, médias) couvrent tout ; à deux, ils validaient des sujets hors cible comme le smic, les soldes ou le permis. Pendant ce temps, de vrais sujets pointus, couverts par un seul spécialiste, disparaissaient : violation de données, AIPD, article 28. Ce qu’il faut retenir, c’est qu’un consensus ne vaut que si l’on regarde qui le forme.
Moi : Est-ce qu’on exploite vraiment ces 799 recherches, ou est-ce qu’on paie pour rien ?
Ce qui s'est dit, en résumé
Claude : Les généralistes faussent le consensus : smic et soldes passent, violation de données et AIPD disparaissent.
L'outil présélectionne les spécialistes, et le client valide lui-même ses vrais concurrents
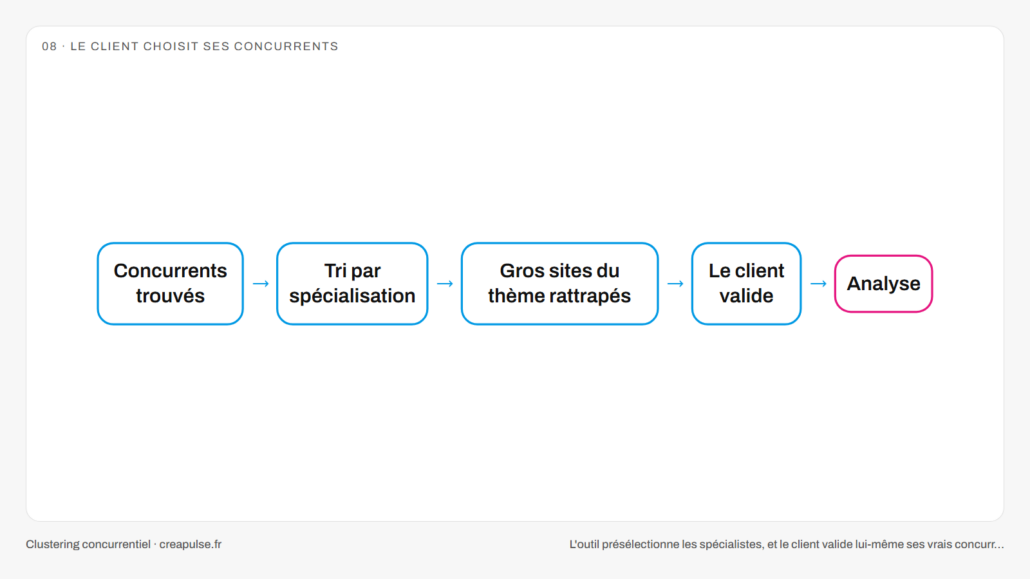
Premier correctif : trier les concurrents par spécialisation (la part de leurs mots-clés commune avec le site) plutôt que par taille. Deuxième : rattraper les gros sites du même thème, qui ont peu de recoupement en proportion mais beaucoup de contenu à étudier. Et un filtre de topicalité à trois niveaux (hors sujet, limite, cœur) pour écarter le reste.
Mais le correctif qui a fait la plus grosse différence n’est pas un filtre. C’est l’humain dans la boucle : l’outil présélectionne, et c’est vous qui cochez vos vrais concurrents, avec un minimum de six pour garantir la qualité. Sur le cabinet d’avocats, le portail juridique généraliste classé premier est sorti, au profit de spécialistes RGPD. Après un run à 11 concurrents validés, mon constat tenait en une phrase : les 11 concurrents font la différence. Personne ne connaît mieux votre marché que vous, aucun filtre automatique ne remplace ça.
Moi : On présélectionne, mais c’est le client qui valide ou choisit ses concurrents.
Ce qui s'est dit, en résumé
Claude : Présélection par spécialisation, gros sites thématiques rattrapés, puis un écran de validation avant l’analyse.
Un pilier se nomme d'après son thème central ; son volume sert seulement à prioriser
Dernier détour, et pas le moins drôle : le code nommait chaque pilier d’après sa requête la plus cherchée. Résultat, un pilier « google lens » sur un site d’agence SEO. Holà. Une page pilier ne cible pas un mot-clé unique, elle cible tout un champ de requêtes.
Le nom du pilier devient donc le centre thématique de son groupe, raccourci en vrai nom de rubrique (« rgpd », « données personnelles », « cnil »), et le volume, cumulé sur toutes les requêtes du pilier, n’est plus qu’une colonne de priorité. C’est la même logique que dans un audit sémantique : on travaille un corpus, pas un mot-clé.
Moi : Qui a dit que le pilier doit cibler le terme le plus demandé ? Une page cible plusieurs expressions.
Ce qui s'est dit, en résumé
Claude : Juste : le nom devient le centre thématique du groupe, et le volume une colonne de priorité.
En quinze minutes : piliers, sous-sujets, angle et plan H2, à partir de vos vrais concurrents
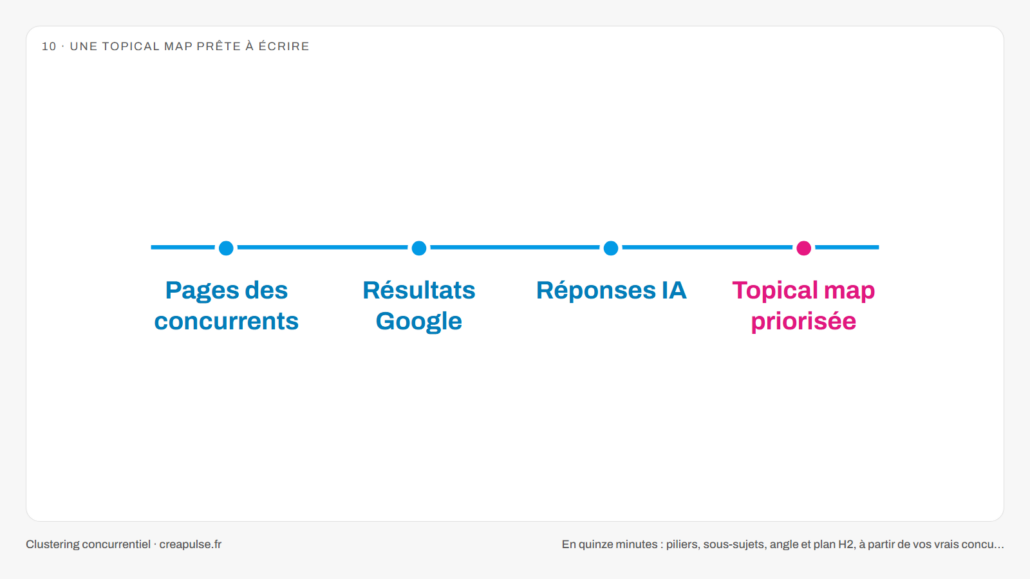
Au bout de ces six semaines, le labo est devenu un outil en ligne. Il enchaîne les pages de vos concurrents, les résultats Google et leurs réponses IA, et vous livre une topical map priorisée : les piliers, leurs sous-sujets, l’angle de chacun et son plan H2. Une analyse complète dure 10 à 15 minutes. L’outil fonctionne en crédits (1 crédit couvre 6 concurrents), et 2 crédits sont offerts à l’inscription pour un premier essai.
Ce qu'il faut retenir
- Pour regrouper des requêtes en pages, demandez à Google : celles qui partagent les mêmes URL dans le top 10 relèvent d’une même page. La ressemblance des mots ne le garantit pas.
- Pour trouver ce qui manque à un site, lisez les pages de ses concurrents plutôt que de soustraire des listes de mots-clés.
- Les sections des réponses IA de Google sont une carte des sous-intentions d’un sujet ; celles qui ne méritent pas une page font le plan H2 de celles qui la méritent.
- Un consensus concurrentiel ne vaut que par ceux qui le forment : laissez l’expert valider ses concurrents, ça améliore plus la sortie que n’importe quel filtre.
Questions fréquentes
C'est quoi, le clustering concurrentiel ?
C’est le regroupement des requêtes sur lesquelles vos concurrents se positionnent, en groupes qui correspondent chacun à une page à écrire. L’outil Clustering concurrentiel de creapulse.fr le fait à partir des pages réelles de vos concurrents, des résultats Google et de ses réponses IA, et livre une topical map priorisée.
Pourquoi regrouper les mots-clés par les résultats Google plutôt que par leur sens ?
Parce que les méthodes par le sens (LLM, embeddings) ont produit des groupes fourre-tout sur le banc d’essai, en fusionnant des intentions différentes. Deux requêtes dont le top 10 Google partage au moins 4 pages peuvent être satisfaites par la même page : c’est Google lui-même qui le dit.
À quoi servent les réponses IA de Google dans l'outil ?
Leurs sections révèlent comment Google découpe un sujet. L’outil en tire jusqu’à trois sous-sujets par pilier, chacun digne d’un article, et recycle les sections trop étroites en titres H2 (3 à 6 par sous-sujet).
Pourquoi dois-je valider mes concurrents moi-même ?
Parce que des concurrents généralistes faussent l’analyse : sur un site de niche, ils validaient des sujets hors cible pendant que de vrais sujets pointus disparaissaient. L’outil présélectionne les spécialistes, vous cochez ceux que vous reconnaissez, six au minimum.
Combien de temps dure une analyse, et combien ça coûte ?
10 à 15 minutes. L’outil fonctionne en crédits : 1 crédit couvre 6 concurrents, et 2 crédits sont offerts à l’inscription pour un premier essai.
Et maintenant ?
L’outil est en ligne, et il va continuer d’évoluer : chaque nouvelle étape viendra compléter cet article, avec la date et ce qui a changé. En attendant, le meilleur moyen de juger, c’est de le lancer sur votre propre site. Et vous, comment construisez-vous votre topical map aujourd’hui : par les mots, ou par les résultats de Google ?

Consultant SEO / GEO spécialisé en audits SEO avancés, stratégie de contenu automatisé et optimisé (avec relecture humaine), création d’outils sur mesures, analyse des brevets et algorithmes Google liés au SEO et à la recherche générative et domaines impactant le SEO: UX, social media, autorité de la marque, …
Visibilité dans les réponses IA (GEO)
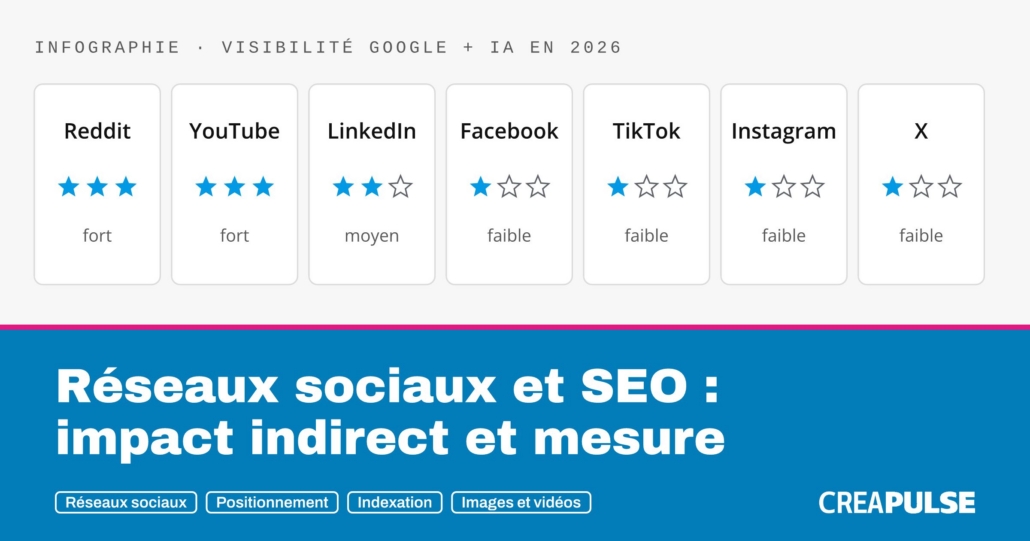
Influence des reseaux sociaux sur le SEO et GEO [Infographie]
Les réseaux sociaux ne font pas ranker une page, mais ils la font connaître. Quels réseaux ressortent dans Google et...
Clustering concurrentiel : la topical map que dessinent Google et ses réponses IA
Clustering concurrentiel lit les pages de vos vrais concurrents, regroupe les requêtes par les résultats Google et tire de ses...
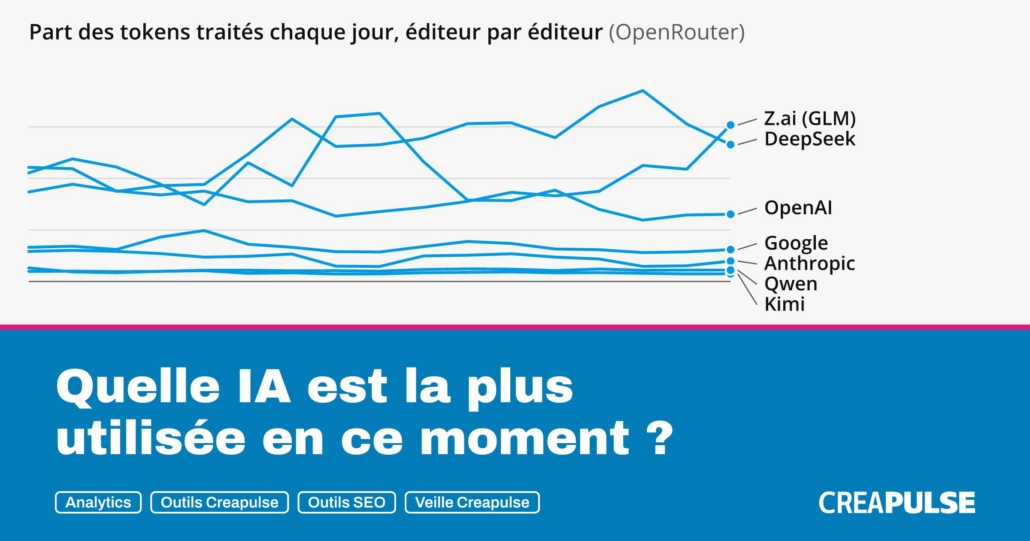
Quelle IA est la plus utilisée en ce moment ? Stats mises à jour chaque jour
Classement quotidien des IA les plus utilisées (OpenAI, Anthropic, Google, DeepSeek, GLM, Kimi, Qwen) d'après les tokens réellement traités par...
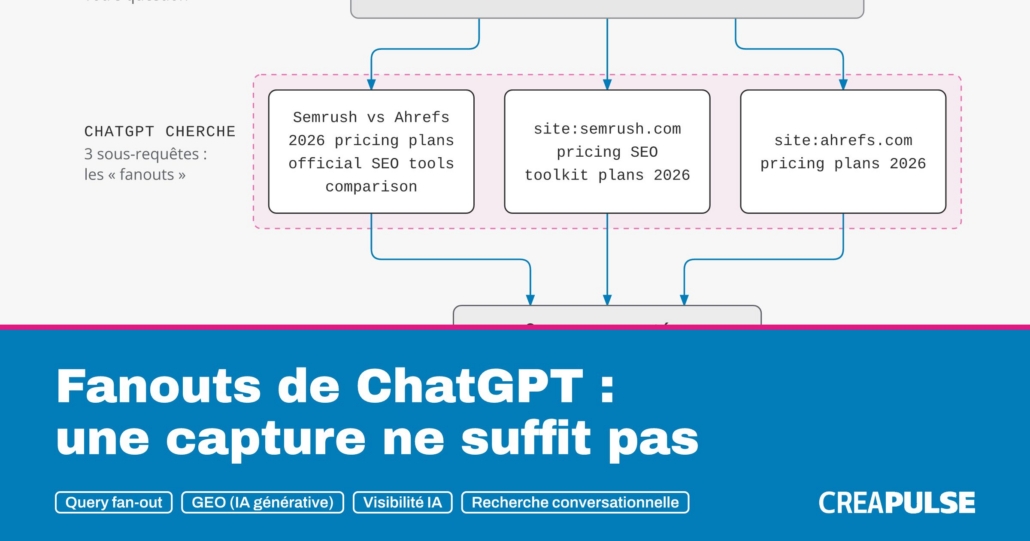
Fanouts de ChatGPT: Une capture ne suffit pas
J'ai capté 30 fois les sous-requêtes que ChatGPT lance en coulisses. Une seule paire de runs identique sur 60 :...


Laisser un commentaire
Rejoindre la discussion?N’hésitez pas à contribuer !