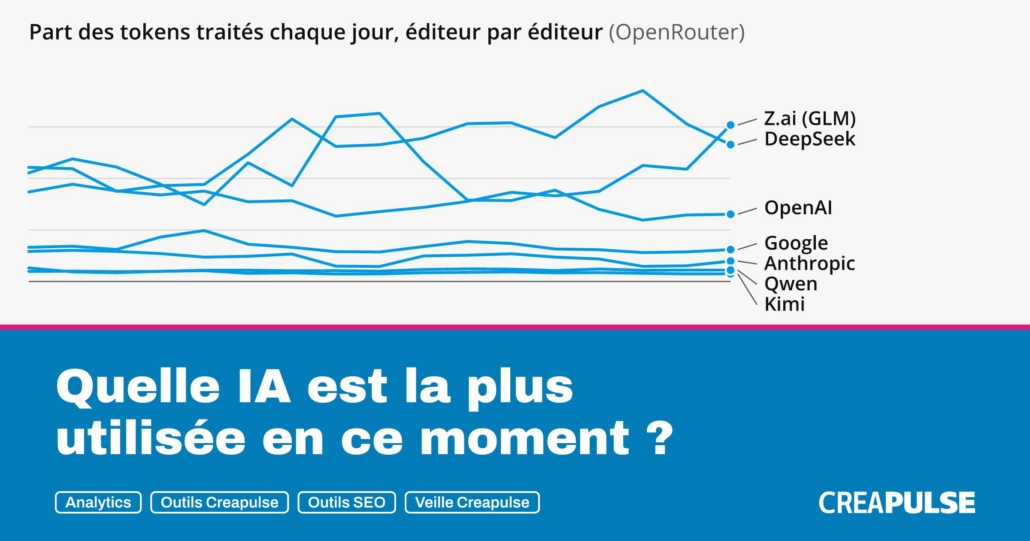
Quelle IA est la plus utilisée en ce moment ? Stats mises à jour chaque jour
En bref
Article mis à jour le
Au 2 novembre 2026 : modèle le plus utilisé, DeepSeek V4.1 Flash 1017 (DeepSeek) ; éditeur le plus utilisé, DeepSeek. Chiffres OpenRouter de la veille, mis à jour chaque matin.
- Cette page mesure l'usage réel des modèles d'IA : les tokens qui passent chaque jour par l'API OpenRouter, éditeur par éditeur. Pas un sondage, pas un benchmark, de la consommation constatée.
- Les chiffres, graphes et tableaux se mettent à jour automatiquement tous les matins avec la dernière journée complète.
- Le plus utilisé n'est pas le meilleur : en volume, ce sont les modèles rapides et pas chers (les « flash ») qui raflent la mise, pas les modèles frontière.
- Pour chaque éditeur suivi (OpenAI, Anthropic, Google, DeepSeek, Z.ai, Moonshot, Alibaba) : son classement du jour, son modèle phare, ses prix au million de tokens et pourquoi il monte.
Données OpenRouter du 2 novembre 2026 (dernière journée complète), page mise à jour le 3 novembre 2026. Mesure : tokens traités via l’API OpenRouter, tous fournisseurs et toutes variantes confondus.
Bon, la question revient tout le temps, chez mes clients comme dans mes propres projets : « C’est laquelle, l’IA la plus utilisée en ce moment ? ». Et à chaque fois, on se retrouve avec des réponses au doigt mouillé, des classements de benchmarks (qui mesurent la performance, pas l’usage) ou des études de trafic sur les applis grand public. Rien qui dise ce que les gens consomment réellement quand ils branchent une IA dans un outil, un site ou un agent.
Je vais ici tenter une autre approche, purement mécanique : prendre les tokens réellement traités chaque jour par OpenRouter, la plateforme qui donne accès à plus de 400 modèles via une seule API, et les faire parler. C’est une source biaisée (on y reviendra, je vous cache rien), mais c’est de la donnée d’usage, fraîche, et surtout comparable d’un éditeur à l’autre. Comme à mon habitude, je vais essayer de vulgariser au maximum : si le mot « token » vous échappe encore, disons que c’est l’unité de facturation des IA, en gros trois quarts de mot en anglais, un peu moins en français.
Le principe de la page est simple : un robot récupère les chiffres tous les matins, redessine les graphes, recalcule les tableaux, et je ne touche à rien. Les textes d’analyse par éditeur, eux, ne bougent que lorsque le modèle phare change. Vous avez donc sous les yeux la photo de la dernière journée complète, pas un article figé qui date de six mois.
Quelle IA est la plus utilisée aujourd'hui, tous éditeurs confondus ?
Le 2 novembre 2026, 30,54 billions de tokens ont transité par OpenRouter. Le modèle le plus utilisé est DeepSeek V4.1 Flash 1017 (DeepSeek) avec 7,79 billions de tokens, soit 25,5 % du total. L’éditeur le plus utilisé est DeepSeek (37,3 % des tokens, tous modèles confondus).
DeepSeek V4.1 Flash 1017 est un modèle sparse mixture-of-experts, snapshot du 17 octobre 2026, servi par DeepSeek sous le nom d’API deepseek-flash. Son contexte de 1 048 576 tokens et son architecture allégée le rendent efficace pour les tâches à haut volume : agents, traitement de documents longs, code. Côté tarifs, il affiche 0,30 $ par million de tokens en entrée et 1,20 $ en sortie, un positionnement très agressif qui explique son attractivité pour les développeurs cherchant du débit à moindre coût.
Ce qui explique son score du jour (6,00 billions de tokens, 26,2 % du trafic OpenRouter), c’est la conjonction d’un prix cassé et d’un contexte géant, qui en fait un choix naturel pour les intégrations automatisées à grande échelle plutôt que pour l’usage grand public. Attention, il s’agit d’un snapshot récent, pas forcément la version la plus stable à long terme, et OpenRouter ne capte qu’une partie de l’usage réel de DeepSeek, largement consommé en direct via son API ou en self-hosting en Chine.
Top 10 des modèles IA les plus utilisés
Classement détaillé : tokens, part de marché et prix
| # | Modèle | Éditeur | Tokens / jour | Part | Prix ($/M) | Intelligence | Code | Agentique |
|---|---|---|---|---|---|---|---|---|
| 1 | DeepSeek V4.1 Flash 1017 | DeepSeek | 7,79 T | 25,5 % | 0,30 / 1,20 | 28,5 | — | — |
| 2 | GLM 5.3 Flash | Z.ai (GLM) | 2,59 T | 8,5 % | 0,03 / 0,09 | 27,8 | 71,5 | 50,9 |
| 3 | DeepSeek V4.1 Flash | DeepSeek | 2,41 T | 7,9 % | 0,04 / 0,50 | — | — | — |
| 4 | Hy4 preview | Tencent | 1,58 T | 5,2 % | 0,83 / 2,50 | — | — | — |
| 5 | GPT-5.6 Luna | OpenAI | 1,32 T | 4,3 % | 0,20 / 1,20 | — | 71,4 | 42,1 |
| 6 | GPT-6 Luna | OpenAI | 1,13 T | 3,7 % | 0,10 / 0,50 | 27,8 | — | — |
| 7 | Step 5 Preview | Stepfun | 1,01 T | 3,3 % | 1,00 / 2,70 | 28,5 | — | — |
| 8 | Claude Opus 5.5 | Anthropic | 979 Md | 3,2 % | 4,00 / 20,00 | 58,4 | — | — |
| 9 | MiniMax M3.1 Flash | MiniMax | 906 Md | 3,0 % | 0,15 / 0,60 | 28,9 | — | — |
| 10 | Kimi K3.1 Pro | Moonshot AI (Kimi) | 720 Md | 2,4 % | 2,00 / 10,00 | 46,0 | — | — |
Intelligence, Code et Agentique : indices Artificial Analysis (0 à 100), repris de l’API OpenRouter ; tiret = modèle non évalué. Prix en $ par million de tokens, entrée / sortie.
Top 10 des éditeurs IA par volume de tokens
Comment lire ces chiffres sans leur faire dire n'importe quoi ?
Avant de vous jeter sur les classements, quelques précautions, parce que ces courbes sont trompeuses si on les lit trop vite. Un token n’est pas un utilisateur. Un seul agent de code qui tourne toute la nuit peut consommer plus qu’un millier de personnes qui posent trois questions dans un chat. Le volume mesure une intensité d’usage, pas une popularité.
- OpenRouter, c'est le monde des développeurs et des produits qui appellent une API. Les usages grand public (l'appli ChatGPT, Gemini dans Android, Claude sur le web) n'y passent pas. Anthropic et OpenAI sont donc largement sous-estimés ici par rapport à leur usage réel via leurs API directes ou les clouds (Bedrock, Vertex, Azure).
- Les modèles pas chers gonflent mécaniquement les volumes : à 0,05 $ le million de tokens, on laisse tourner sans compter. À 25 $ le million en sortie, on réfléchit à deux fois. C'est pour ça que les « flash » dominent.
- Je regroupe les variantes (standard, batch, gratuite) d'un même modèle et je classe par éditeur, c'est-à-dire par celui qui a entraîné le modèle, pas par celui qui l'héberge. Les pages « provider » d'OpenRouter, elles, comptent par hébergeur : c'est une autre lecture, souvent trompeuse (Alibaba Cloud y sert par exemple les modèles GLM de Z.ai).
- Les données sont celles de la dernière journée complète (J-1). Le jour en cours est partiel, donc jamais affiché.
Ce qu’il faut retenir, c’est que ces chiffres répondent à une question précise : quels modèles les développeurs choisissent-ils réellement quand ils paient au token ? C’est un signal très utile pour choisir un modèle dans un projet, beaucoup moins pour savoir qui « gagne la course à l’IA ».
DeepSeek : quel modèle est le plus utilisé ?
DeepSeek est le 1er éditeur le plus utilisé sur OpenRouter le 2 novembre 2026, avec 11,40 billions de tokens (37,3 % du total). Son modèle phare du moment est DeepSeek V4.1 Flash 1017 : 7,79 billions de tokens, 1er modèle tous éditeurs confondus, facturé 0,30 $ par million de tokens en entrée et 1,20 $ en sortie, contexte de 1 048 576 tokens.
DeepSeek V4.1 Flash est un modèle de type mixture-of-experts, pensé pour allier rapidité et coût contenu sur des tâches de code, d’agents et de raisonnement à grande échelle. Avec un contexte XXL de 1 048 576 tokens, il peut ingérer des bases de code entières ou de longs documents. Côté tarif, comptez 0,30 $ par million de tokens en entrée et 1,20 $ en sortie, un positionnement clairement orienté volume.
Ce qui explique son score du jour (6,00 billions de tokens, 26,2 % du trafic OpenRouter, 1e place tous éditeurs confondus) : son prix agressif combiné à ce contexte massif, qui en fait un choix naturel pour les usages API intensifs. Attention, OpenRouter ne reflète qu’une partie de l’usage réel de DeepSeek, beaucoup de trafic passant par leur API directe en Chine. A noter que ce snapshot du 17 octobre 2026 n’est pas annoncé comme une simple preview, mais les détails techniques complets restent peu documentés publiquement à ce stade.
| # | Modèle | Tokens / jour | Part chez DeepSeek | Rang global | Prix ($/M) | Intelligence | Code | Agentique |
|---|---|---|---|---|---|---|---|---|
| 1 | DeepSeek V4.1 Flash 1017 | 7,79 T | 68,3 % | 1er | 0,30 / 1,20 | 28,5 | — | — |
| 2 | DeepSeek V4.1 Flash | 2,41 T | 21,2 % | 3e | 0,04 / 0,50 | — | — | — |
| 3 | DeepSeek V4 Flash 0731 | 571 Md | 5,0 % | 11e | 0,06 / 0,30 | — | 69,1 | 41,0 |
| 4 | DeepSeek V4 Flash 0423 | 356 Md | 3,1 % | 20e | 0,09 / 0,18 | — | 56,2 | 22,2 |
| 5 | DeepSeek V4 Pro 0423 | 104 Md | 0,9 % | 34e | 1,60 / 3,20 | — | 59,4 | 26,3 |
Intelligence, Code et Agentique : indices Artificial Analysis (0 à 100), repris de l’API OpenRouter ; tiret = modèle non évalué. Prix en $ par million de tokens, entrée / sortie.
OpenAI : quel modèle GPT est le plus utilisé ?
OpenAI est le 2e éditeur le plus utilisé sur OpenRouter le 2 novembre 2026, avec 3,67 billions de tokens (12,0 % du total). Son modèle phare du moment est GPT-5.6 Luna : 1,32 billions de tokens, 5e modèle tous éditeurs confondus, facturé 0,20 $ par million de tokens en entrée et 1,20 $ en sortie, contexte de 1 050 000 tokens.
GPT-5.6 Luna est la version rapide et économique de la série GPT-5.6 d’OpenAI, pensée pour les tâches à fort volume et sensibles à la latence : chat, classification, workflows agentiques légers. Son raisonnement reste correct sans viser la performance maximale. Comptez 0,20 $ par million de tokens en entrée et 1,20 $ en sortie, pour un contexte qui grimpe à 1 050 000 tokens, ce qui en fait un choix pertinent pour des applications qui traitent beaucoup de texte à moindre coût.
Ce positionnement tarifaire très agressif, combiné à un contexte généreux, explique sans doute son adoption rapide depuis sa sortie récente. Avec 1,32 billion de tokens traités en une journée, il se hisse au 5e rang tous éditeurs confondus, et OpenAI reste 2e éditeur sur OpenRouter avec 12,0 % des tokens. Attention toutefois : OpenRouter ne capte qu’une partie de l’usage réel, l’essentiel du trafic OpenAI passant par son API directe. Ceci dit, la tendance semble réelle.
| # | Modèle | Tokens / jour | Part chez OpenAI | Rang global | Prix ($/M) | Intelligence | Code | Agentique |
|---|---|---|---|---|---|---|---|---|
| 1 | GPT-5.6 Luna | 1,32 T | 35,9 % | 5e | 0,20 / 1,20 | — | 71,4 | 42,1 |
| 2 | GPT-6 Luna | 1,13 T | 30,8 % | 6e | 0,10 / 0,50 | 27,8 | — | — |
| 3 | GPT-6.1 Sol | 551 Md | 15,0 % | 12e | 2,00 / 10,00 | 54,5 | — | — |
| 4 | GPT-6.1 Terra | 123 Md | 3,4 % | 31e | 1,00 / 5,00 | 51,0 | — | — |
| 5 | GPT-6 Luna Pro | 94 Md | 2,6 % | 37e | 0,10 / 0,50 | — | — | — |
Intelligence, Code et Agentique : indices Artificial Analysis (0 à 100), repris de l’API OpenRouter ; tiret = modèle non évalué. Prix en $ par million de tokens, entrée / sortie.
Z.ai (GLM) : quel modèle est le plus utilisé ?
Z.ai (GLM) est le 3e éditeur le plus utilisé sur OpenRouter le 2 novembre 2026, avec 3,30 billions de tokens (10,8 % du total). Son modèle phare du moment est GLM 5.3 Flash : 2,59 billions de tokens, 2e modèle tous éditeurs confondus, facturé 0,03 $ par million de tokens en entrée et 0,09 $ en sortie, contexte de 1 048 576 tokens.
Z.ai (l’ex-Zhipu AI, éditeur de la famille GLM) place en tête GLM 5.3 Flash, un modèle multimodal natif sorti fin août 2026, conçu pour le code efficace et les agents qui travaillent longtemps sur une même tâche. Son architecture d’attention hybride (une partie « sparse », une partie linéaire) lui permet de rester précis sur des contextes très longs sans exploser les coûts.
Il est tendance pour une raison simple : à environ 0,07 $ le million de tokens en entrée et 0,25 $ en sortie, il joue dans la même cour que DeepSeek V4 Flash, avec la multimodalité en plus. Les développeurs qui font tourner des agents de code à la chaîne y trouvent un moteur bon marché. Petite subtilité pour lire les chiffres d’OpenRouter : GLM est souvent servi par des hébergeurs tiers, dont Alibaba Cloud, d’où le fait qu’il apparaisse sur la page « provider » d’Alibaba alors que ce n’est pas un modèle Alibaba.
| # | Modèle | Tokens / jour | Part chez Z.ai (GLM) | Rang global | Prix ($/M) | Intelligence | Code | Agentique |
|---|---|---|---|---|---|---|---|---|
| 1 | GLM 5.3 Flash | 2,59 T | 78,3 % | 2e | 0,03 / 0,09 | 27,8 | 71,5 | 50,9 |
| 2 | GLM 5.3 | 532 Md | 16,1 % | 13e | 0,08 / 3,60 | 31,7 | 74,8 | 53,1 |
| 3 | GLM 5.2 | 136 Md | 4,1 % | 30e | 0,01 / 6,80 | — | 68,8 | 38,4 |
| 4 | GLM 5.3 FlashX | 24 Md | 0,7 % | 73e | 0,37 / 1,25 | — | — | — |
| 5 | GLM 5 | 5,2 Md | 0,2 % | 124e | 1,00 / 3,20 | — | — | — |
Intelligence, Code et Agentique : indices Artificial Analysis (0 à 100), repris de l’API OpenRouter ; tiret = modèle non évalué. Prix en $ par million de tokens, entrée / sortie.
Google : quel modèle Gemini est le plus utilisé ?
Google est le 10e éditeur le plus utilisé sur OpenRouter le 2 novembre 2026, avec 970 milliards de tokens (3,2 % du total). Son modèle phare du moment est Gemini 3.8 Flash : 249 milliards de tokens, 24e modèle tous éditeurs confondus, facturé 0,83 $ par million de tokens en entrée et 4,13 $ en sortie, contexte de 1 048 576 tokens.
Chez Google, le modèle phare du moment est Gemini 3.8 Flash, sorti le 2 septembre 2026. Google le présente comme son Flash le plus intelligent, avec des gains notables sur l’ingénierie logicielle, les tâches agentiques et le raisonnement multi-étapes. Contexte d’un million de tokens, multimodal, et un tarif intermédiaire : environ 0,75 $ le million de tokens en entrée, 3,75 $ en sortie.
Pourquoi il monte ? Parce que c’est tout neuf, tout simplement : à chaque nouvelle version Flash, les développeurs migrent en quelques jours, ce qui explique que la version précédente (3.7 Flash) décroche aussi vite. Google joue la carte du « bon partout, pas cher, gros contexte », très efficace en volume. À noter que l’usage de Gemini via Google AI Studio ou Vertex directement n’apparaît pas ici : la part réelle de Google est donc plus élevée que ce que montre OpenRouter.
| # | Modèle | Tokens / jour | Part chez Google | Rang global | Prix ($/M) | Intelligence | Code | Agentique |
|---|---|---|---|---|---|---|---|---|
| 1 | Gemini 3.8 Flash | 249 Md | 25,7 % | 24e | 0,83 / 4,13 | 30,5 | 76,3 | 40,2 |
| 2 | Gemini 4 Argon | 160 Md | 16,5 % | 28e | 2,00 / 10,00 | 50,4 | — | — |
| 3 | Gemini 3 Flash Preview | 91 Md | 9,4 % | 38e | 0,50 / 3,00 | — | — | — |
| 4 | Gemini 3.1 Flash Lite | 85 Md | 8,7 % | 40e | 0,25 / 1,50 | — | — | — |
| 5 | Gemma 4 31B | 69 Md | 7,1 % | 44e | 0,20 / 0,40 | — | 43,4 | 4,2 |
Intelligence, Code et Agentique : indices Artificial Analysis (0 à 100), repris de l’API OpenRouter ; tiret = modèle non évalué. Prix en $ par million de tokens, entrée / sortie.
Anthropic : quel modèle Claude est le plus utilisé ?
Anthropic est le 5e éditeur le plus utilisé sur OpenRouter le 2 novembre 2026, avec 1,96 billions de tokens (6,4 % du total). Son modèle phare du moment est Claude Opus 5.5 : 979 milliards de tokens, 8e modèle tous éditeurs confondus, facturé 4,00 $ par million de tokens en entrée et 20,00 $ en sortie, contexte de 1 000 000 tokens.
Claude Opus 5.5 est le modèle haut de gamme d’Anthropic, pensé pour le raisonnement complexe, le code et les tâches agentiques qui s’étalent sur de longues séquences d’actions. Il excelle sur les modifications multi-fichiers dans de grosses bases de code, avec un contexte d’un million de tokens qui lui permet d’ingérer des projets entiers. Comptez 4,00 $ par million de tokens en entrée et 20,00 $ en sortie, un tarif qui reste dans la fourchette haute du marché.
Succédant à Claude Opus 5, ce modèle capitalise sur la réputation d’Anthropic en coding agentique pour s’imposer rapidement auprès des développeurs. Avec 655 milliards de tokens traités en une journée sur OpenRouter, il se classe 8e tous éditeurs confondus, et Anthropic reste 4e éditeur avec 6,1 % des tokens. Attention, ces chiffres ne reflètent qu’une partie de l’usage réel : une bonne part du trafic Anthropic passe par son API directe ou par des outils comme Claude Code, hors du radar d’OpenRouter.
| # | Modèle | Tokens / jour | Part chez Anthropic | Rang global | Prix ($/M) | Intelligence | Code | Agentique |
|---|---|---|---|---|---|---|---|---|
| 1 | Claude Opus 5.5 | 979 Md | 49,9 % | 8e | 4,00 / 20,00 | 58,4 | — | — |
| 2 | Claude Haiku 5.5 | 356 Md | 18,1 % | 21e | 0,10 / 0,50 | 36,2 | — | — |
| 3 | Claude Sonnet 5.5 | 339 Md | 17,3 % | 22e | 2,00 / 10,00 | 54,2 | — | — |
| 4 | Claude Sonnet 5 | 81 Md | 4,1 % | 41e | 2,00 / 10,00 | — | 71,5 | 43,6 |
| 5 | Claude Fable 5.1 | 46 Md | 2,4 % | 51e | 10,00 / 50,00 | 49,7 | 80,7 | 57,2 |
Intelligence, Code et Agentique : indices Artificial Analysis (0 à 100), repris de l’API OpenRouter ; tiret = modèle non évalué. Prix en $ par million de tokens, entrée / sortie.
Moonshot AI (Kimi) : quel modèle est le plus utilisé ?
Moonshot AI (Kimi) est le 9e éditeur le plus utilisé sur OpenRouter le 2 novembre 2026, avec 1,01 billions de tokens (3,3 % du total). Son modèle phare du moment est Kimi K3.1 Pro : 720 milliards de tokens, 10e modèle tous éditeurs confondus, facturé 2,00 $ par million de tokens en entrée et 10,00 $ en sortie, contexte de 1 048 576 tokens.
Kimi K3.1 Pro est le modèle phare de Moonshot AI, un modèle de raisonnement multimodal en poids ouverts, pensé pour le code sur de longs horizons et les tâches complexes type génération 3D. Son contexte atteint 1 048 576 tokens, ce qui permet d’avaler des bases de code entières. Côté tarif, comptez 2,00 $ par million de tokens en entrée et 10,00 $ en sortie, un positionnement intermédiaire plutôt agressif face aux modèles fermés équivalents.
Ce pic d’usage s’explique par une adoption rapide depuis sa sortie fin octobre 2026 : 572 milliards de tokens traités en une journée, soit 2,5 % du volume total d’OpenRouter et la 9e place de Moonshot AI parmi tous les éditeurs. Son ouverture en poids ouverts et son rapport prix/contexte séduisent les développeurs pour des usages agentiques et de codage long. Ceci dit, ces chiffres ne reflètent qu’une partie de l’usage réel : beaucoup de trafic passe par l’API directe de Moonshot AI ou des clouds chinois, invisibles ici.
| # | Modèle | Tokens / jour | Part chez Moonshot AI (Kimi) | Rang global | Prix ($/M) | Intelligence | Code | Agentique |
|---|---|---|---|---|---|---|---|---|
| 1 | Kimi K3.1 Pro | 720 Md | 71,3 % | 10e | 2,00 / 10,00 | 46,0 | — | — |
| 2 | Kimi K3 | 261 Md | 25,8 % | 23e | 0,19 / 15,00 | 17,4 | 72,0 | 29,3 |
| 3 | Kimi K2.6 | 19 Md | 1,8 % | 79e | 0,65 / 3,41 | — | 61,8 | 20,5 |
| 4 | Kimi K2.7 Code | 6,7 Md | 0,7 % | 112e | 0,60 / 3,50 | — | 60,8 | 21,0 |
| 5 | Kimi K2.5 | 3,3 Md | 0,3 % | 147e | 0,50 / 2,50 | — | 46,8 | — |
Intelligence, Code et Agentique : indices Artificial Analysis (0 à 100), repris de l’API OpenRouter ; tiret = modèle non évalué. Prix en $ par million de tokens, entrée / sortie.
Alibaba (Qwen) : quel modèle est le plus utilisé ?
Alibaba (Qwen) est le 14e éditeur le plus utilisé sur OpenRouter le 2 novembre 2026, avec 444 milliards de tokens (1,5 % du total). Son modèle phare du moment est Qwen3.8 27B : 105 milliards de tokens, 33e modèle tous éditeurs confondus, facturé 0,15 $ par million de tokens en entrée et 1,88 $ en sortie, contexte de 1 024 000 tokens.
Qwen3.8 27B est un modèle dense vision-langage à poids ouverts signé Alibaba, pensé pour le code, les workflows professionnels, la recherche et les tâches d’agents longue durée, avec un mode de raisonnement activable selon la complexité de la demande. Il traite aussi bien du texte que des images, ce qui en fait un choix pertinent pour des usages multimodaux. Son prix reste très accessible : 0,15 $ en entrée et 1,88 $ en sortie par million de tokens, pour un contexte qui grimpe jusqu’à 1 000 000 de tokens.
Sa popularité tient surtout à un positionnement tarifaire agressif face à des modèles fermés bien plus chers, combiné à une fenêtre de contexte rare à ce prix. L’ouverture des poids facilite aussi son adoption par les développeurs qui veulent l’héberger ou le fine-tuner. Avec 126 milliards de tokens traités ce jour-là, il reste cependant un modèle de niche sur OpenRouter (0,6 % du trafic global), loin derrière les leaders. Attention, ce chiffre ne reflète qu’une partie de l’usage réel de Qwen, largement déployé en direct via l’API Alibaba Cloud en Chine.
| # | Modèle | Tokens / jour | Part chez Alibaba (Qwen) | Rang global | Prix ($/M) | Intelligence | Code | Agentique |
|---|---|---|---|---|---|---|---|---|
| 1 | Qwen3.8 27B | 105 Md | 23,6 % | 33e | 0,15 / 1,88 | 20,1 | 68,1 | 45,8 |
| 2 | Qwen3.7 Flash | 73 Md | 16,4 % | 42e | 0,03 / 0,13 | — | — | — |
| 3 | Qwen3.8 Flash | 64 Md | 14,4 % | 45e | 0,15 / 0,47 | — | — | — |
| 4 | Qwen3.8 Max (0902) | 33 Md | 7,5 % | 63e | 2,00 / 6,00 | 33,6 | 76,2 | 56,0 |
| 5 | qwen3-embedding-8b | 31 Md | 6,9 % | 65e | — | — | — | — |
Intelligence, Code et Agentique : indices Artificial Analysis (0 à 100), repris de l’API OpenRouter ; tiret = modèle non évalué. Prix en $ par million de tokens, entrée / sortie.
Comment cette page est-elle fabriquée ?
Pour ceux qui aiment savoir ce qu’il y a sous le capot (et parce que je préfère montrer la mécanique plutôt que vous demander de me croire sur parole), voici le pipeline, en gros :
- Chaque matin, un workflow n8n interroge le classement OpenRouter (celui qui alimente la page Rankings) et récupère, modèle par modèle, les tokens traités la veille, toutes variantes confondues.
- Les prix et fiches des modèles viennent de l'API publique d'OpenRouter (celle des modèles), donc les tarifs affichés sont ceux facturés le jour même.
- Le tout est agrégé par modèle puis par éditeur (préfixe du modèle : openai/, anthropic/, google/…), et archivé dans une table pour construire les courbes de tendance jour après jour.
- Les graphes sont dessinés en SVG directement par le workflow, sans outil externe : ils se mettent à jour dans la page et s'ouvrent en grand au clic.
- Les textes d'analyse par éditeur sont régénérés uniquement quand le modèle phare change, avec une recherche web pour comprendre pourquoi. Le reste du temps, seuls les chiffres bougent.
Aucun chiffre n’est retouché à la main. Si un jour une courbe vous paraît bizarre, c’est probablement OpenRouter qui a eu un hoquet, ou un modèle gratuit qui a fait un pic : ça arrive, et je préfère l’afficher que le lisser.
Ce qu'il faut retenir
L’IA la plus utilisée, c’est presque toujours la moins chère qui fait le job. Les modèles frontière font les gros titres, les modèles « flash » font les gros volumes. Si vous choisissez un modèle pour un projet, cette page vous dit où va l’argent des développeurs qui paient au token, et à quel prix. Ce qu’elle ne dit pas, c’est lequel est le meilleur pour votre cas : ça, il faut le tester.
Je fais tourner cette page comme un tableau de bord public, et je compte l’enrichir (part de dépense, et pas seulement de tokens ; évolution sur 90 jours ; peut-être d’autres sources que OpenRouter). Vous en pensez quoi, de cette lecture par les tokens ? Un éditeur que vous voudriez voir suivi ici ? Dites-le moi en commentaire.
Questions fréquentes
Quelle est l'IA la plus utilisée dans le monde ?
Ça dépend de ce qu’on mesure. En nombre d’utilisateurs grand public, ChatGPT reste largement devant. En volume de tokens consommés par les développeurs via une API multi-modèles comme OpenRouter, la tête du classement change presque chaque semaine : les modèles économiques (DeepSeek V4 Flash, GPT-5.6 Luna, GLM 5.3 Flash, Hy4) se disputent la première place. Cette page vous donne le classement de la veille, mis à jour chaque jour.
Pourquoi utiliser OpenRouter comme source et pas les éditeurs eux-mêmes ?
Parce que les éditeurs ne publient pas leurs volumes, et que quand ils le font, ce n’est pas comparable. OpenRouter est le seul endroit où plus de 400 modèles de tous les éditeurs sont consommés au même endroit, mesurés de la même façon et publiés ouvertement. C’est un échantillon biaisé (développeurs, API, sensibilité au prix), mais c’est un échantillon honnête.
Un token, c'est quoi exactement ?
C’est l’unité de découpage du texte par un modèle de langue, et donc l’unité de facturation. En pratique, un token vaut à peu près trois quarts d’un mot en anglais, un peu moins en français (nos accents et nos mots longs coûtent plus cher). Mille milliards de tokens, c’est environ l’équivalent de plusieurs millions de livres traités dans la journée.
Le modèle le plus utilisé est-il le meilleur ?
Non, et c’est même souvent l’inverse. Les modèles les plus consommés sont ceux qui offrent le meilleur rapport qualité/prix pour des tâches répétitives : extraction, classification, agents de code. Les modèles les plus performants sur les benchmarks (Claude Opus, GPT-6, Gemini Pro) sont plus chers, donc utilisés avec parcimonie, sur les tâches qui le méritent.
À quelle fréquence les chiffres sont-ils mis à jour ?
Tous les matins, avec les données de la dernière journée complète (J-1). Les courbes de tendance se construisent au fil des jours de collecte, et les textes d’analyse par éditeur sont réécrits automatiquement quand le modèle phare change.
Vous voulez mesurer votre propre visibilité dans les réponses des IA, ou brancher ce type de tableau de bord sur vos données ? On en parle.

Consultant SEO / GEO spécialisé en audits SEO avancés, stratégie de contenu automatisé et optimisé (avec relecture humaine), création d’outils sur mesures, analyse des brevets et algorithmes Google liés au SEO et à la recherche générative et domaines impactant le SEO: UX, social media, autorité de la marque, …
Visibilité dans les réponses IA (GEO)
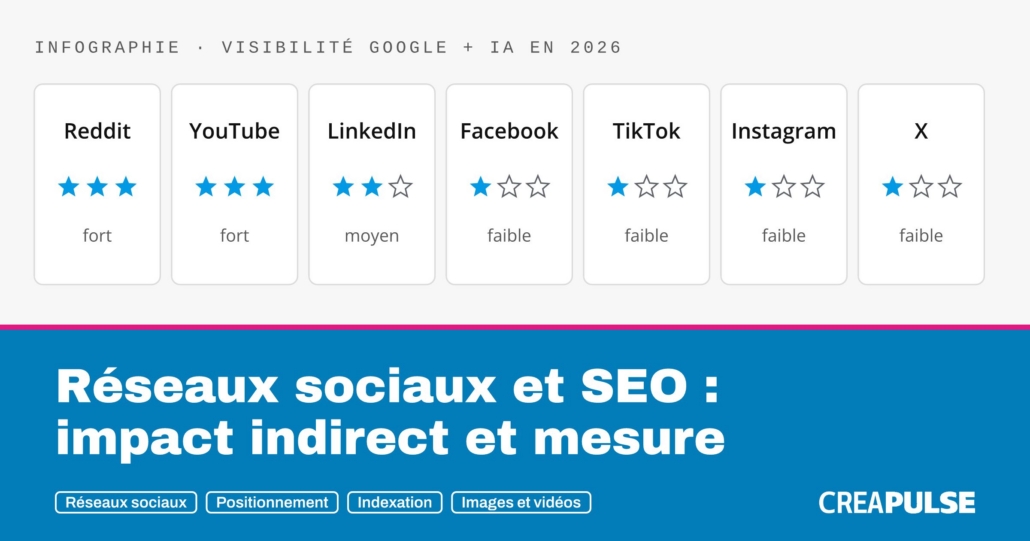
Influence des reseaux sociaux sur le SEO et GEO [Infographie]
Les réseaux sociaux ne font pas ranker une page, mais ils la font connaître. Quels réseaux ressortent dans Google et...
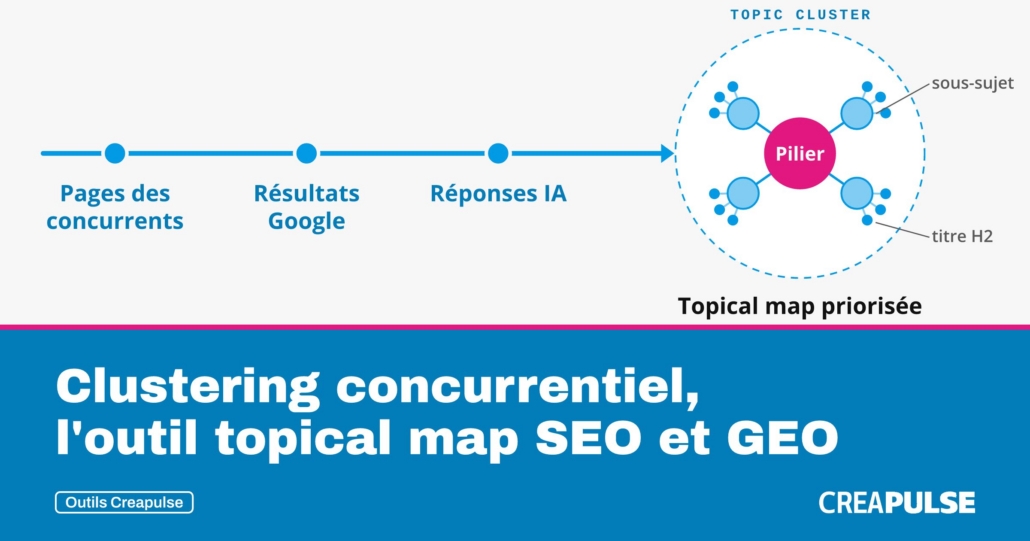
Clustering concurrentiel : la topical map que dessinent Google et ses réponses IA
Clustering concurrentiel lit les pages de vos vrais concurrents, regroupe les requêtes par les résultats Google et tire de ses...
Quelle IA est la plus utilisée en ce moment ? Stats mises à jour chaque jour
Classement quotidien des IA les plus utilisées (OpenAI, Anthropic, Google, DeepSeek, GLM, Kimi, Qwen) d'après les tokens réellement traités par...
Fanouts de ChatGPT: Une capture ne suffit pas
J'ai capté 30 fois les sous-requêtes que ChatGPT lance en coulisses. Une seule paire de runs identique sur 60 :...


Laisser un commentaire
Rejoindre la discussion?N’hésitez pas à contribuer !