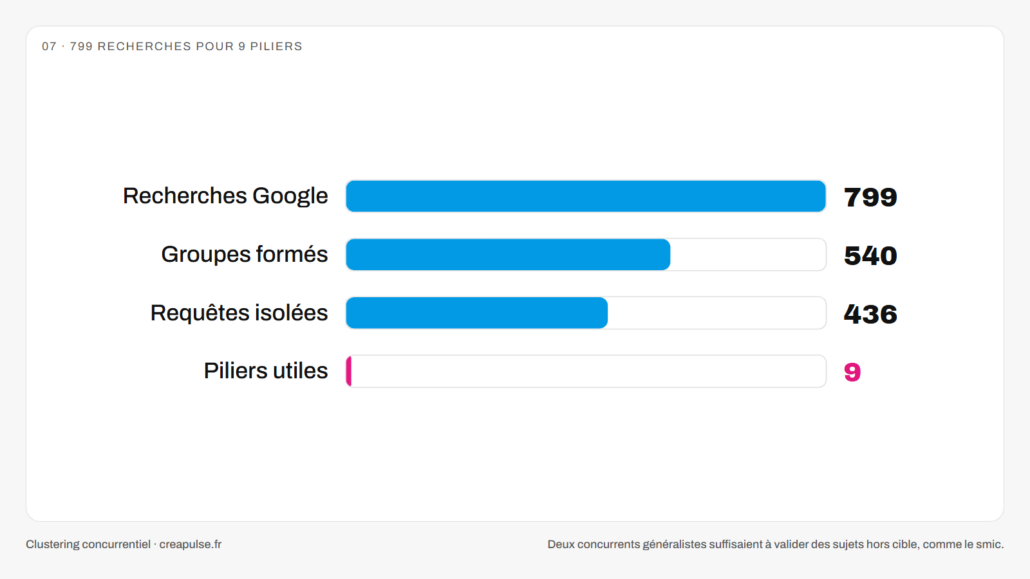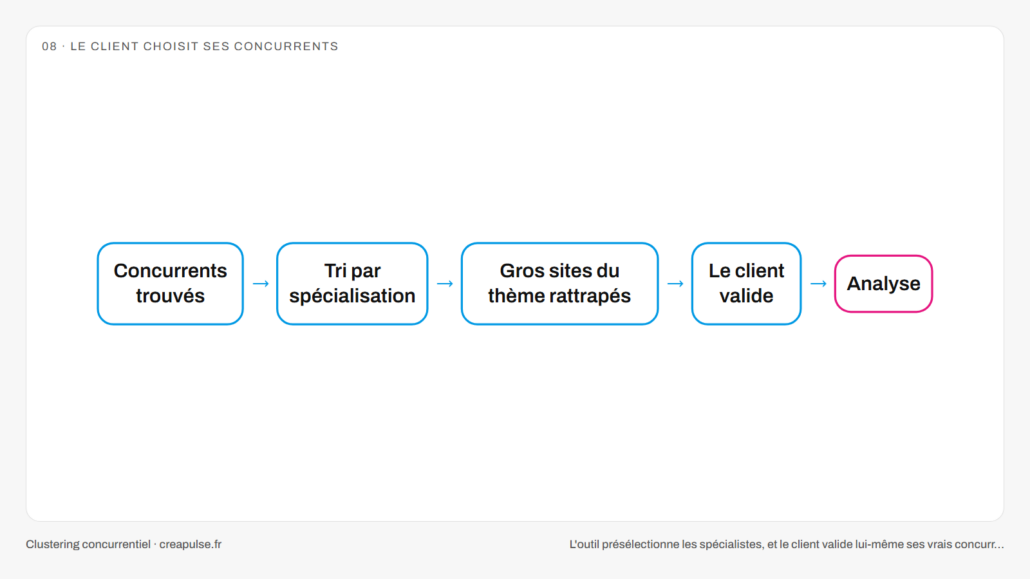
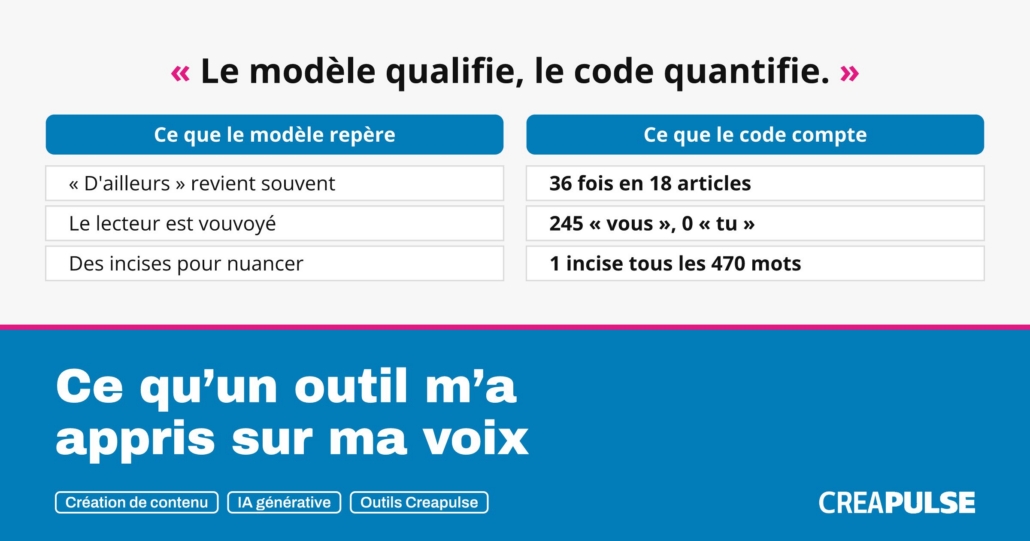
Schéma : « Le modèle qualifie, le code quantifie ». Le même trait de voix, repéré par le modèle et compté par le code.

En bref

  • Un outil gratuit qui tire votre voix d’auteur de trois de vos articles, construit et mis en ligne en deux jours.
  • Testé sur ma propre voix, il a révélé le vrai défaut : on donne des traits de style aux IA sans jamais leur dire combien de fois les employer.
  • Une IA repère très bien un trait, elle ne sait pas estimer sa fréquence : le modèle qualifie, le code quantifie.
  • Une règle de voix se mesure avant de s’écrire : une règle qui interdit ce que personne n’écrit ne sert à rien.

Article fil rouge, statut : en cours. Ce qui a changé : 24 octobre 2026, première publication.

Cet article raconte la fabrication d’un outil gratuit de Creapulse : un générateur qui extrait la voix d’un auteur à partir de trois de ses articles, et la rend prête à donner à n’importe quelle IA. Construit et mis en ligne en deux jours, il m’a surtout servi de miroir. En le testant sur ma propre voix, j’ai compris pourquoi les IA caricaturent un style, et ce qu’il faut leur donner pour qu’elles arrêtent.

Je reprends ici les huit moments qui ont compté, avec les vrais chiffres, erreurs comprises. Chaque section se termine par l’échange qui l’a déclenchée, résumé, entre Claude (l’IA avec laquelle j’ai construit l’outil) et moi.

Trois articles collés, et l'outil rend votre voix d'auteur, prête pour n'importe quelle IA
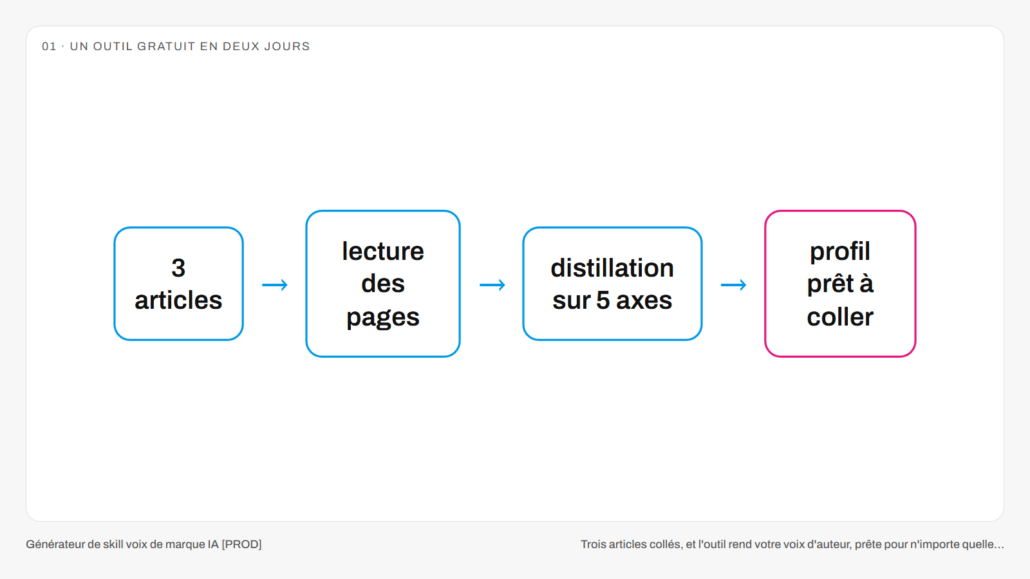
Les quatre étapes de l'outil : trois articles, lecture des pages, distillation sur cinq axes, profil prêt à coller

Le principe tient en une ligne. Vous donnez les adresses de trois de vos articles, l’outil les lit, en tire un profil de votre style sur cinq axes (ton, phrase, vocabulaire, déroulé, principes), et vous le rend sous deux formes : un bloc à coller dans ChatGPT ou Claude, et un skill à importer dans Claude.

La commande est partie un soir de septembre, et l’outil répondait en production le lendemain : une première génération sur deux articles a pris 21 secondes. Au passage, j’ai posé une règle pour tous mes outils à venir : ils vivent sous creapulse.fr/outils, jamais sur un sous-domaine chacun. Sinon, on n’a pas fini.

L’échange, résumé. Moi : je veux un outil gratuit sur mon site qui transforme quelques articles en profil de voix réutilisable. Claude : l’outil lit les pages, fait distiller la voix par un modèle, puis met le résultat en forme sans IA.

« Zéro mot exploitable » sur de vrais articles : le coupable n'était pas celui qu'on croyait
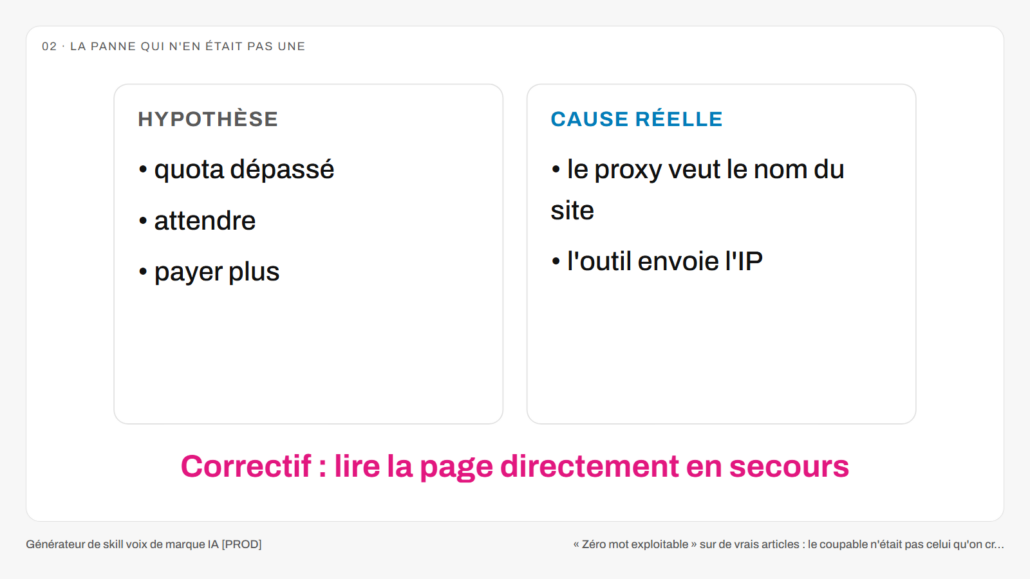
Hypothèse et cause réelle de la panne : le proxy voulait le nom du site, l'outil envoyait l'adresse IP

Le lendemain de la mise en ligne, l’outil s’est mis à répondre qu’il ne trouvait aucun mot exploitable sur des articles pourtant longs. Au même moment, le fournisseur du proxy, l’intermédiaire réseau qui sert à lire les pages, envoyait une alerte qui ressemblait furieusement à un dépassement de quota.

Ce n’en était pas un. Ce type de proxy veut connaître le nom du site visité, et l’outil ne lui donnait que son adresse IP. Plutôt que de dépendre d’un intermédiaire dont je ne maîtrise pas le protocole, l’outil lit désormais la page directement quand il échoue. Un outil public ne doit pas dépendre d’un maillon qu’on ne contrôle pas.

L’échange, résumé. Moi : l’outil me dit zéro mot exploitable, et j’ai reçu une alerte de quota du fournisseur de proxy. Claude : ce n’est pas un quota, le proxy veut le nom du site, on ne lui donne que l’adresse IP.

Le guide de voix pesait 70 % des consignes, et les articles ressemblaient à des check-lists
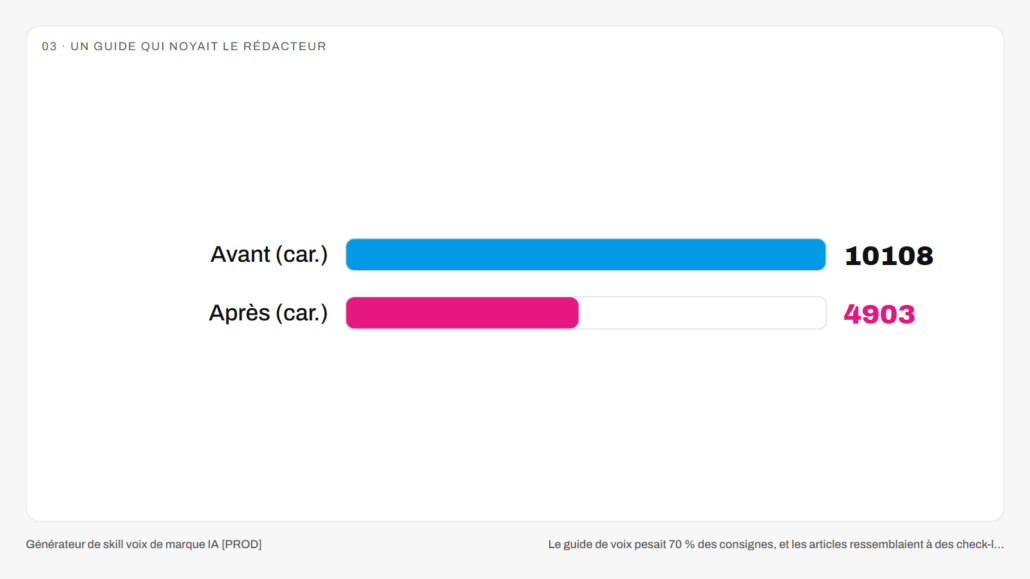
Taille du guide de voix avant et après : 10 108 puis 4 903 caractères

Un guide de voix, c’est le document qui dit à une IA comment sonne un auteur. Le mien, tiré de mes propres articles, sert à tous mes outils de rédaction. Problème : il faisait plus de 10 000 caractères, soit 70 % des consignes de mon rédacteur d’articles. Et il ne décrivait pas que la voix, il décrivait aussi la mise en page : sommaire, listes, gras, liens internes. Résultat, les articles produits ressemblaient à des check-lists.

En gros, on l’a coupé de moitié, en ne gardant que la façon dont ça sonne. La même discipline vaut pour l’outil public : un profil trop long noie le modèle qui l’applique, donc sa longueur est plafonnée, et c’est le programme qui garantit ce plafond, pas une consigne donnée au modèle. Un guide de voix qui décide de la mise en page n’est plus un guide de voix.

L’échange, résumé. Moi : mon guide de voix fait 70 % des consignes du rédacteur, il noie le plan, allège-le. Claude : on garde ce qui décrit le son, on sort tout ce qui décide la mise en page.

L'IA multipliait les « Bon, » ; l'auteur, lui, l'écrit moins d'une fois tous les deux articles
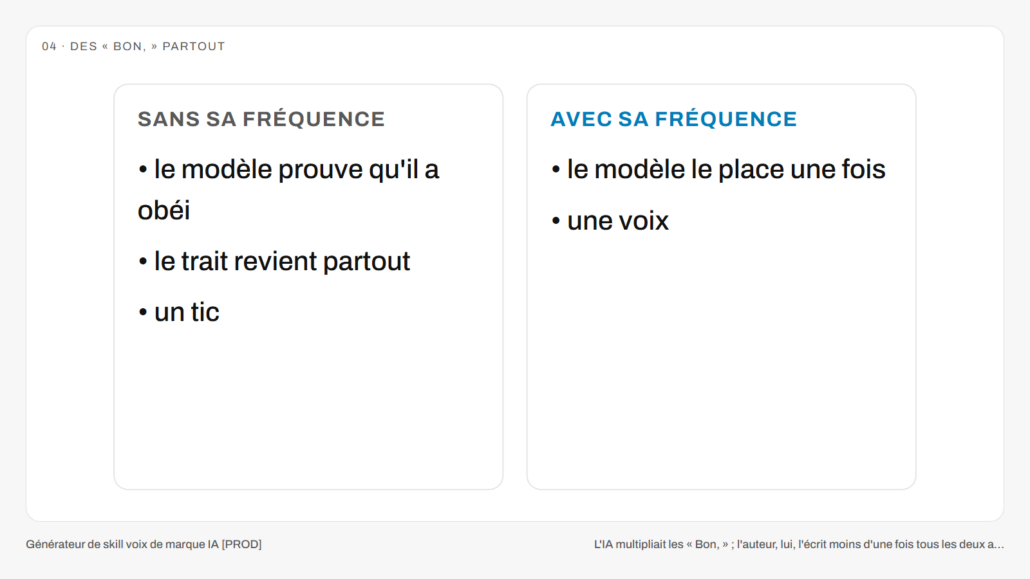
Le même trait sans sa fréquence devient un tic, avec sa fréquence il reste une voix

En relisant des textes générés pour moi, je tombais sur des « Bon, » et des « mécaniquement » bien plus souvent que je ne les écris. Chaque tournure était bien la mienne, mais à cette fréquence, c’étaient devenus des tics.

La cause était dans le guide. Il listait mes tournures sans dire à quelle fréquence je les emploie, et les présentait comme « à réemployer ». Or un modèle à qui on donne une consigne cherche à prouver qu’il l’a suivie, et le plus sûr moyen de le prouver, c’est de rendre le trait visible. Partout. Ce que je voyais comme une description, le modèle l’a lu comme un ordre.

L’échange, résumé. Moi : pourquoi y a-t-il autant de tics dans mes textes générés ? Montre-moi d’où ça vient. Claude : le guide nomme les tournures sans leur dose, et les dit « à réemployer » ; le modèle obéit trop.

Demander à l'IA d'estimer la fréquence d'un trait : zéro réponse sur vingt-cinq

Le modèle qualifie, le code quantifieLe même trait de voix vu par le modèle et par le code. Le modèle repère que « D’ailleurs » revient souvent, le code compte 36 occurrences en 18 articles. Le modèle repère que le lecteur est vouvoyé, le code compte 245 « vous » et aucun « tu ». Le modèle repère des incises pour nuancer, le code en compte une tous les 470 mots.« Le modèle qualifie, le code quantifie. »Ce que le modèle repèreCe que le code compte« D’ailleurs » revient souvent36 fois en 18 articlesLe lecteur est vouvoyé245 « vous », 0 « tu »Des incises pour nuancer1 incise tous les 470 motsRelevé par script sur les 18 articles publiés de Serge Esteves, en octobre 2026.

Pour donner la dose, la solution la plus simple semblait de demander au modèle de l’estimer lui-même, en même temps qu’il repère les traits. On a essayé deux formulations, dont une avec un format imposé et un exemple. Résultat : zéro trait annoté sur 25.

Le modèle repère très bien un style, il n’en mesure pas la densité. Compter, en revanche, c’est exactement ce que sait faire un programme : le rappel de dosage de l’outil est donc écrit par le code, pas demandé au modèle. Ce qu’il faut retenir tient en une phrase : le modèle qualifie, le code quantifie.

L’échange, résumé. Moi : peut-on demander au modèle de noter la fréquence de chaque trait qu’il trouve ? Claude : essayé deux fois, zéro trait annoté sur 25 ; le modèle qualifie, le code quantifie.

Trois règles proposées pour le guide : deux déplacées, une annulée trois minutes après son ajout
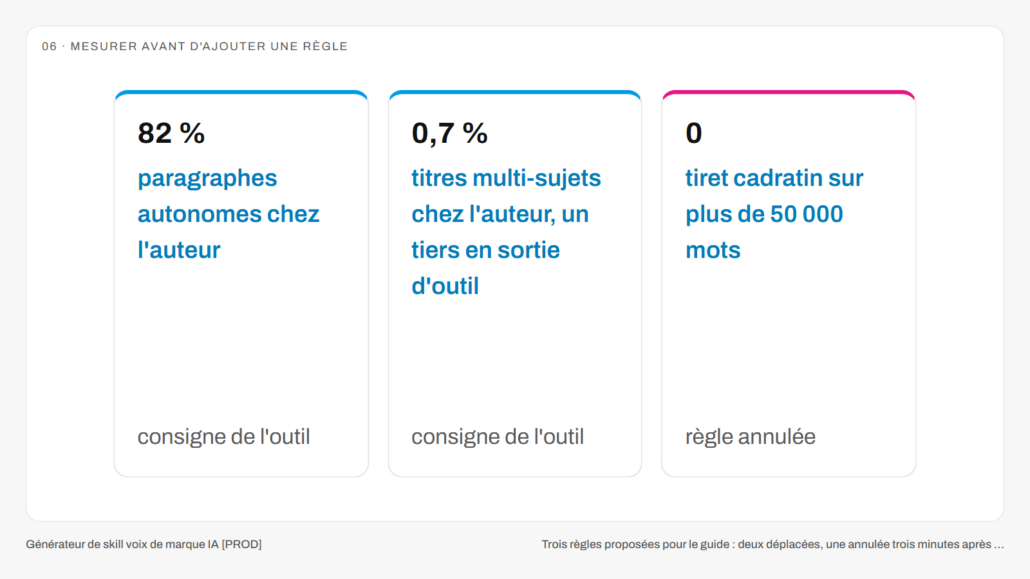
Trois règles mesurées : 82 % de paragraphes autonomes, 0,7 % de titres multi-sujets, zéro tiret cadratin

Plus tard, une autre session de Claude, celle qui rédige mes articles, m’a proposé trois règles à ajouter au guide : des paragraphes qui se comprennent seuls, un seul sujet par titre, jamais de tiret cadratin. Vous me direz : plus de règles, plus de garanties. Pas forcément. Avant d’en accepter une, on l’a comptée sur mes articles publiés.

82 % de mes paragraphes se comprennent déjà seuls, et 0,7 % de mes titres mélangent plusieurs sujets, contre environ un tiers en sortie de mon outil d’enrichissement. Ces deux défauts viennent de l’outil, pas de ma voix : les règles vont donc dans les consignes de l’outil. Le tiret cadratin, lui, n’apparaît jamais dans mes articles. J’ai d’abord validé la règle, puis je l’ai fait retirer trois minutes plus tard : une règle qui interdit ce que personne n’écrit n’apporte rien.

L’échange, résumé. Moi : jamais de tiret cadratin dans mes textes, ajoute-le au guide. Claude : ajouté. Puis j’annule : je n’en écris jamais, la règle n’apporte rien.

245 « vous », zéro « tu » : une voix d'auteur mesurée sur 18 articles
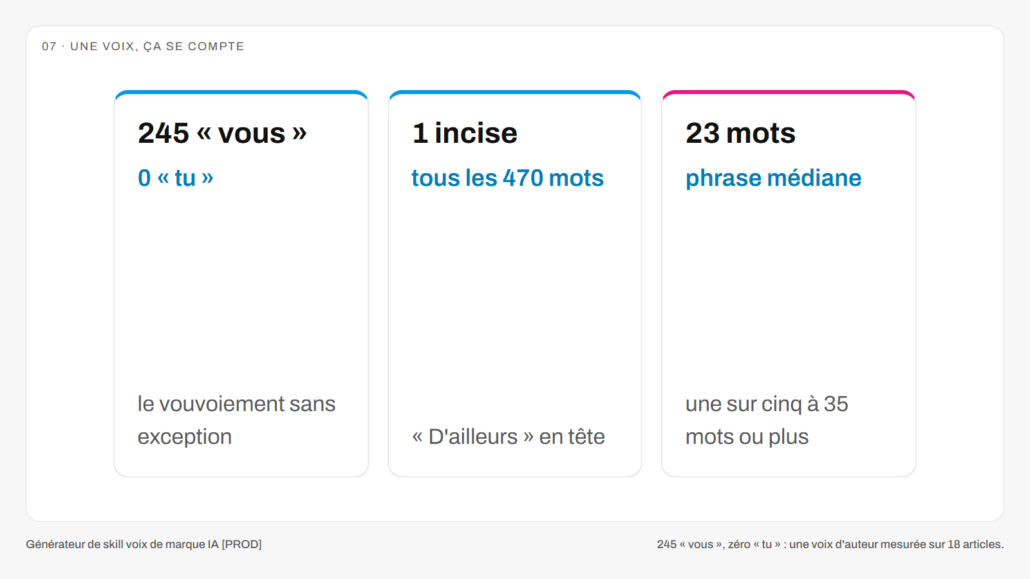
Trois mesures de ma voix : 245 vous et 0 tu, une incise tous les 470 mots, une phrase médiane de 23 mots

Pour l’article de lancement de l’outil, plutôt que de décrire ma voix avec des adjectifs, je l’ai fait compter sur mes 18 articles publiés : pronoms, incises, longueur des phrases. 245 « vous » et pas un seul « tu ». Une incise tous les 470 mots. Une phrase médiane de 23 mots, alors que mes textes aérés donnent une impression de phrases courtes.

Ces chiffres disent mieux qu’un brief comment j’écris, et ils ont une autre vertu : on ne peut pas les inventer. Chaque chiffre de l’article vient du relevé, et l’article lui-même a été relu contre les faits : deux anecdotes inventées par le premier jet ont été retirées avant publication. Tout est détaillé dans l’article Votre voix de marque est déjà dans vos articles publiés.

L’échange, résumé. Moi : écris l’article toi-même, dans ma voix, avec mes vrais chiffres. Claude : tout est relevé par script sur tes 18 articles, et chaque chiffre publié vient de ce relevé.

Une image à la une tirée d'un détail fait croire que l'article se résume à ce détail
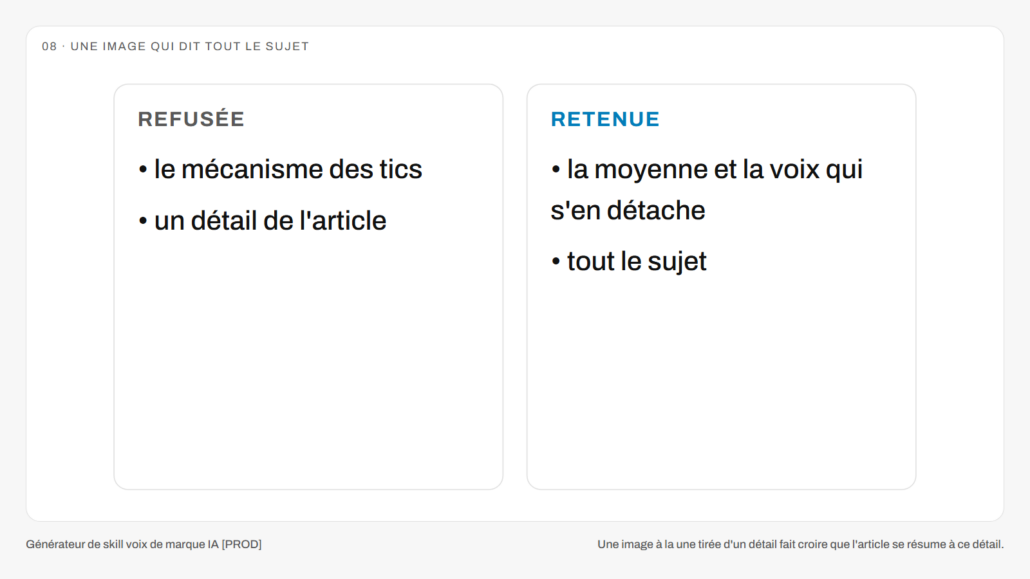
L'image refusée montrait un détail, l'image retenue montre tout le sujet

Dernier épisode, d’ailleurs pas le moins utile. La première image à la une de l’article de lancement reprenait le schéma des tics. Je l’ai refusée : elle réduisait l’article à un seul de ses mécanismes, alors que le sujet, c’est la voix tout entière.

La version retenue montre la masse des contenus qui se ressemblent, et une voix qui s’en détache. Une image à la une doit dire le sujet, pas un de ses détails.

L’échange, résumé. Moi : cette image est réductrice, elle doit représenter l’article dans son ensemble. Claude : nouvelle carte, tirée du schéma « La moyenne n’a la voix de personne ».

Ce qu'il faut retenir

  • Quand vous donnez un trait de style à une IA, donnez aussi sa fréquence : sans dose, elle l’applique partout pour prouver qu’elle a obéi.
  • Laissez l’IA repérer les traits, et comptez-les vous-même : elle qualifie très bien, elle ne quantifie pas.
  • Mesurez une règle sur vos textes avant de l’écrire : si vous ne produisez jamais le défaut, la règle n’a pas d’objet.
  • Gardez votre guide de voix court et centré sur le son : la mise en page se décide ailleurs.

Questions fréquentes

À quoi sert un générateur de voix de marque ?

À donner à une IA une description précise de votre façon d’écrire, tirée de vos propres textes, pour que ce qu’elle rédige sonne comme vous plutôt que comme la moyenne.

Combien d'articles faut-il pour extraire sa voix ?

Trois au minimum, cinq au plus. En dessous de trois, une tournure propre à un seul texte passe facilement pour un trait de voix.

Pourquoi une IA exagère-t-elle certains traits de style ?

Parce qu’on les lui donne sans fréquence. Un modèle cherche à montrer qu’il a suivi la consigne, et il place le trait aussi souvent qu’il le peut.

L'outil est-il gratuit ?

Oui. Une première génération est possible sans compte, puis avec un compte gratuit sur creapulse.fr.

Et maintenant ?

L’outil est en ligne et gratuit. Il reste une ligne de mon guide de voix à corriger : elle affirme une proportion que je n’ai pas réussi à retrouver en comptant, et elle n’a donc rien à faire dans un guide qui se veut mesuré. Je compléterai cet article à chaque nouvelle étape.

Extrayez votre voix de marque à partir de trois de vos articles, gratuitement.

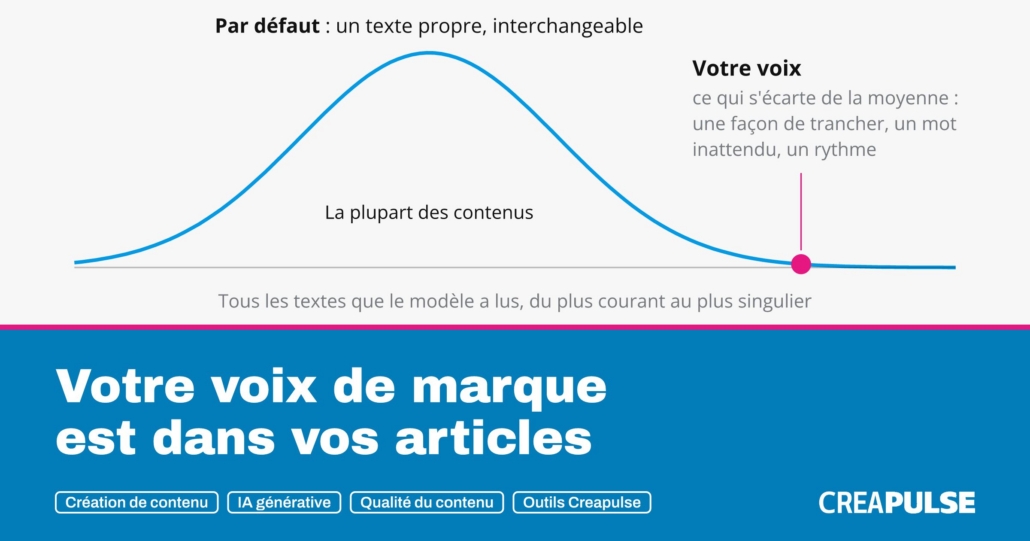
Schéma : sur la courbe de tous les textes qu’un modèle a lus, le texte par défaut est au sommet, la voix de l’auteur se distingue loin de la moyenne.

En bref

  • Votre voix de marque n’est pas à inventer : elle se lit dans vos articles publiés, sous forme de régularités qu’on peut compter.
  • Un brief de ton décrit n’importe qui, et peut même être faux sur vous : mes phrases font 23 mots en médiane, alors que mes textes paraissent faits de phrases courtes.
  • Chaque trait a une fréquence. Donné sans sa dose, un trait est sur-appliqué par l’IA et devient un tic.
  • L’IA repère les traits, elle n’estime pas leur densité : le modèle qualifie, le code quantifie.
  • La méthode tient en quatre étapes : trois à cinq textes représentatifs, lus en entier, distillés par axe avec des citations, puis comptés.

Une voix de marque, c’est la façon dont une marque sonne quand elle écrit : ses tournures, son rythme, ses mots, et ce qu’elle refuse d’écrire. Avec l’IA qui rédige une part croissante des contenus, c’est la première chose qu’on perd, et la plus difficile à décrire dans un prompt. La bonne nouvelle, c’est que vous n’avez pas à l’inventer : elle existe déjà, noir sur blanc, dans ce que vous avez publié.

Je m’en suis rendu compte en construisant le guide de voix qu’utilisent mes outils de rédaction IA. Un guide tiré de mes propres articles, avec des citations à l’appui. Tout y était juste, et pourtant les textes produits forçaient le trait.

Alors j’ai fait ce que je fais sur un site quand quelque chose cloche : j’ai mesuré. J’ai passé mes 18 articles publiés, un peu plus de 50 000 mots, dans des scripts de comptage, et j’ai regardé ce qui revenait vraiment.

Dans cet article, je vous montre ce que ça donne avec mes vrais chiffres, pas avec un cas d’école, puis comment refaire l’exercice sur vos propres textes. Le sujet est plus technique qu’il n’en a l’air, mais je vais rester au plus près du concret.

Pourquoi vos contenus IA se ressemblent

La moyenne n’a la voix de personneSchéma de principe, sans échelle. Une courbe en cloche représente tous les textes qu’un modèle a lus. À son sommet, là où se trouvent la plupart des contenus, le texte que le modèle écrit par défaut : propre, interchangeable. Loin dans la queue de la courbe, la voix de l’auteur, ce qui s’écarte de la moyenne : une façon de trancher, un mot inattendu, un rythme.La moyenne n’a la voix de personneCe qu’un modèle écrit sans indication, et ce qui se remarquePar défaut : un texte propre, interchangeableLa plupart des contenusVotre voixce qui s’écarte de la moyenne :une façon de trancher, un motinattendu, un rythmeTous les textes que le modèle a lus, du plus courant au plus singulierSchéma de principe, sans échelle.

Demandez à n’importe quel modèle d’écrire un article sur votre sujet : il vous rendra un texte propre, structuré, sans faute. Et parfaitement interchangeable. Ce n’est pas un défaut du modèle, c’est sa nature : sans autre indication, il écrit comme la moyenne des textes qu’il a lus, et la moyenne n’a la voix de personne.

Le problème, c’est que votre lecteur lit lui aussi la moyenne, toute la journée. Ce qui le fait rester sur une page, revenir sur un site ou reconnaître un auteur dans son fil d’actualité, c’est précisément ce qui s’en écarte : une façon de trancher, un mot qu’on n’attendait pas, un rythme. Un contenu sans voix n’est pas mauvais, il est oubliable.

L’enjeu dépasse d’ailleurs le confort de lecture. Dès que vous publiez beaucoup, avec plusieurs outils ou plusieurs rédacteurs, la voix devient ce qui relie vos contenus entre eux. C’est elle qui fait qu’on reconnaît la marque d’un texte à l’autre. Sans elle, chaque contenu vit sa vie, et votre site finit par ressembler à une collection de textes signés par personne.

Vous me direz : il suffit d’indiquer à l’IA quel ton employer. C’est justement là que ça coince.

Un brief de ton ne décrit rien

La plupart des briefs de ton se ressemblent : « professionnel mais accessible », « expert et chaleureux », « un style vivant, des phrases percutantes ». Relisez-les en pensant à trois marques concurrentes de votre secteur : ils leur vont à toutes les trois. C’est le problème du portrait-robot. « Taille moyenne, cheveux bruns », ça décrit la moitié de la rue.

Plus gênant, un brief de ton peut être faux sur vous-même. On décrit sa voix d’après l’impression qu’elle laisse, et l’impression trompe. Voici ce qu’un brief aurait pu dire de mes articles, face à ce qu’ils contiennent réellement.

Ce que dirait un brief de tonCe que disent mes 18 articles
« Un ton proche du lecteur »245 « vous » et pas un seul « tu » : proche, mais vouvoyé
« Des phrases courtes et percutantes »Une phrase médiane de 23 mots, et une phrase sur cinq qui atteint 35 mots ou plus
« Un ton conversationnel »« c’est pas » 10 fois, contre « ce n’est pas » 26 fois : l’oral reste l’exception
« Un style vivant »Une incise tous les 470 mots, avec « D’ailleurs » loin devant
« Des titres accrocheurs »Des titres de 5 mots en médiane, dont moins d’un sur dix en forme de question

La deuxième ligne est la plus instructive. Mes paragraphes sont courts et mes textes aérés, ce qui laisse une impression de phrases courtes. C’est l’inverse : j’écris surtout des phrases longues qui empilent les précisions, avec de temps en temps une phrase sèche pour asséner.

Seules 3 % de mes phrases font 8 mots ou moins. Ce qui fait mon rythme, ce n’est pas la brièveté, c’est l’alternance. Un brief qui aurait réclamé « des phrases courtes » à une IA lui aurait fait écrire quelqu’un d’autre que moi.

Ma voix, en chiffres

Concrètement, j’ai pris mes 18 articles publiés, sur creapulse.fr et en tribune sur le Journal du Net, dont une tribune parue en 2014. J’en ai retiré le code, les liens et les métadonnées, puis j’ai compté. Pas d’IA pour juger, pas d’impression : des scripts qui comptent des pronoms, des tournures, des longueurs de phrase et des débuts de paragraphe. Tous les chiffres de cet article viennent de ce relevé, fait en octobre 2026.

Ce qui est mesuréSur quoiRésultat
Volume du corpus18 articles50 711 mots
Adresse au lecteur« vous », « votre », « vos »245 occurrences, et 0 « tu »
L’auteur qui parle« je », « j’ »202 occurrences
Le raisonnement partagé« on »367 occurrences, le pronom le plus fréquent
Incises du répertoire13 tournures suivies108 occurrences, une tous les 470 mots
Longueur de phrase1 329 phrases de prose23 mots en médiane, 19 % à 35 mots ou plus
Paragraphes autonomes498 paragraphes de 25 mots et plus409 se comprennent lus seuls, soit 82 %
Titres de section273 titres de niveau 2 à 45 mots en médiane
Marqueur rare« mécanique », « mécaniquement »8 occurrences en tout
Tiret cadratinTout le corpus0

Trois choses sautent aux yeux.

D’abord, c’est le « on » qui domine, avec 367 occurrences. C’est le pronom du raisonnement qu’on déroule ensemble : « on va voir que », « on comprend mieux ». Le « je » intervient pour le terrain, quand je raconte ce que j’ai constaté sur un site client, et le « vous » pour interpeller le lecteur. Trois pronoms, trois fonctions, et c’est leur dosage qui fait le ton, bien plus qu’un adjectif dans un brief.

Ensuite, les traits les plus fiables d’une voix sont souvent des absences. Zéro « tu » en plus de 50 000 mots, zéro tiret cadratin : ce sont des règles sans exception, donc les plus sûres à transmettre. Pourtant, on pense rarement à les écrire, parce qu’on ne remarque pas ce qu’on ne fait jamais.

Les titres, eux, disent le registre mieux qu’un long discours. Les miens font 5 mots en médiane, et ils sonnent souvent comme une phrase qu’on dirait à voix haute : « C’est quoi des logs ? », « Ce qui a changé », « Ce qui ne marche plus ». Pas de titre à rallonge bourré de mots-clés, pas d’énumération : sur 273 titres, deux seulement enchaînent plusieurs sujets.

Enfin, et c’est le point le plus important, chaque trait a une fréquence. Une incise tous les 470 mots, ce n’est pas « des incises » : c’est cinq ou six dans un article de fond, pas une par paragraphe. Huit occurrences de « mécanique » en 18 articles, ce n’est pas un mot fétiche, c’est un marqueur rare, qui fonctionne justement parce qu’il est rare. On y reviendra, parce que c’est exactement là que les IA dérapent.

De quoi une voix est faite

Pour qu’une voix soit utilisable, par une IA ou par un rédacteur qui arrive dans l’équipe, il faut la ranger. J’utilise cinq axes, qui couvrent à peu près tout ce qui fait qu’on reconnaît un auteur. Chacun se mesure à sa façon.

De quoi une voix de marque est faiteCinq axes d’une voix de marque, avec pour chacun ce qui se compte et la valeur relevée sur les 18 articles publiés de Serge Esteves. Ton : 245 vous et aucun tu. Style de phrase : une incise tous les 470 mots. Vocabulaire : mécanique 8 fois. Déroulé : 82 pour cent de paragraphes autonomes. Principes édito : aucun tiret cadratin sur 50 711 mots.De quoi une voix de marque est faiteCinq axes, et ce qui se compte dans chacunAXE ET CE QUI SE COMPTERELEVÉ SUR 18 ARTICLESTonLes pronoms d’adresse245 « vous »et pas un seul « tu »Style de phraseLa fréquence des incises1 incise tous les 470 mots« D’ailleurs » en tête, 36 foisVocabulaireLes marqueurs rares« mécanique » 8 foismoins d’une fois par articleDérouléLes paragraphes qui tiennent seuls82 % autonomes409 paragraphes sur 498Principes éditoCe qui n’apparaît jamais0 tiret cadratinsur 50 711 motsRelevé par script sur les 18 articles publiés, en octobre 2026.
  • Le ton, c’est qui parle, et à qui. Il se lit dans les pronoms, dans le registre (vouvoiement ou tutoiement, oral ou écrit) et dans la façon de prendre position.
  • Le style de phrase, c’est la construction : la longueur, le rythme, les incises, la ponctuation.
  • Le vocabulaire, ce sont les mots qui reviennent parce qu’ils portent le sens (chez moi, « pertinence » apparaît 27 fois, dans 10 articles sur 18), et ceux qui jugent au lieu de décrire, comme du crawl « gaspillé » ou un effet « néfaste ».
  • Le déroulé, c’est la façon d’ouvrir un texte, de l’illustrer et de le conclure. Chez moi, une intro qui pose le contexte et une promesse, des cas concrets, et une conclusion qui se termine sur une question. Il se mesure aussi : 82 % de mes paragraphes se comprennent lus seuls, sans s’appuyer sur celui d’avant.
  • Les principes, enfin, c’est ce qu’on défend et ce qu’on refuse : pas de superlatif creux, pas de promesse miracle. Ils se lisent autant dans ce qui manque que dans ce qui est écrit.

Le répertoire d’incises montre bien ce que le comptage apporte. Ce sont les petites tournures qui servent à alerter, nuancer ou simplifier. J’en ai relevé 13 qui reviennent dans mes textes, et voici leur fréquence réelle :

TournureOccurrences dans 18 articles
« D’ailleurs »36
« En fait »12
« Ceci dit »10
« Là aussi »8
« Imaginez »7
« Bon, »7
« En gros »7
« A noter que »4
« Vous me direz »4
« Ce qu’il faut retenir »4
« Autant dire »3
« Attention, »3
« Pour faire simple »3

À lui seul, « D’ailleurs » pèse un tiers du total. Les douze autres sont des épices : présentes, reconnaissables, mais à petite dose.

« Bon, » apparaît 7 fois en plus de 50 000 mots, soit moins d’une fois tous les deux articles. Imaginez maintenant une IA à qui l’on dit simplement : « Serge emploie “Bon,” ». Combien de fois va-t-elle le placer dans un seul article ?

Le piège : un trait sans sa dose

Quand j’ai confié ma voix à mes outils de rédaction, la première version de mon guide listait mes tournures, mes mots-signature, mes marqueurs. Tout était juste, tout était tiré de mes textes. Et pourtant, dans les articles générés, j’ai vu revenir « Bon, » et « mécaniquement » bien plus souvent que je ne les écris. Chaque trait était bien le mien, mais à cette fréquence, c’étaient devenus des tics.

Pourquoi ? Parce qu’un modèle à qui on donne une consigne cherche à montrer qu’il l’a suivie, et le moyen le plus sûr de le montrer, c’est de rendre le trait visible. Si le guide dit « l’auteur emploie “mécaniquement” » sans dire combien de fois, le modèle le placera dès qu’il le peut : chaque occurrence est une preuve d’obéissance.

Mon guide disait même de mes tournures qu’elles étaient « à réemployer ». Pour moi, c’était une description. Pour le modèle, c’était un ordre.

Pourquoi un trait de voix devient un ticUne consigne nomme un trait de voix. Sans sa fréquence, le modèle rend le trait visible pour prouver qu’il a obéi, le place à chaque section, et le trait devient un tic. Avec sa fréquence, le modèle le place une fois et le trait reste une voix.Pourquoi un trait de voix devient un ticLe même trait, selon que la consigne dit sa fréquence ou nonLa consigne nomme un trait« Employez : mécanique, déséquilibre »Sans sa fréquenceLe modèle rend le trait visiblepour prouver qu’il a obéi, doncle place à chaque sectionUn ticAvec sa fréquenceLe modèle le place une fois,comme la consigne l’indiqueUne voixDans les 18 articles publiés de Serge Esteves, « mécanique » apparaît 8 fois,soit moins d’une fois par article. Relevé en octobre 2026.

C’est un peu comme le sel dans une recette. « Mettez du sel » et « une pincée de sel » ne donnent pas le même plat, et pourtant les deux consignes sont justes. Un trait de voix sans sa dose n’est plus une voix, c’est une caricature.

J’ai essayé de faire préciser cette dose par l’IA elle-même, au moment où elle extrait la voix d’un texte. Échec complet. Avec deux formulations différentes, dont une avec un format imposé et un exemple, le modèle a annoté la fréquence de zéro trait sur 25.

Il repère très bien les traits, il n’estime pas leur densité. Ça tombe bien : compter, c’est exactement ce que sait faire un script.

Ce qu’il faut retenir, c’est cette répartition des rôles : le modèle qualifie, le code quantifie. Laissez l’IA repérer ce qui fait votre voix, puis comptez vous-même combien de fois chaque trait revient. Dans mon guide, la consigne sur les incises est devenue : environ une tous les 500 mots, en variant, soit cinq ou six différentes dans un article de fond. Ce n’est plus une liste de tics à placer, c’est une dose.

Comment sortir la vôtre de vos textes

La méthode tient en quatre étapes. Aucune n’est compliquée, mais la dernière est celle que tout le monde saute.

1. Choisir trois à cinq textes vraiment représentatifs. Pas forcément vos plus récents, ni vos plus lus : ceux où vous vous reconnaissez le plus. Écartez les contenus réécrits par d’autres, les communiqués, les fiches produits. Et variez les sujets : si vos cinq textes traitent du même thème, vous extrairez un thème, pas une voix.

Pourquoi trois au minimum ? Parce qu’en dessous, une tournure propre à un seul texte passe facilement pour un trait de voix.

2. Travailler sur les textes entiers, pas sur un résumé. C’est l’erreur la plus courante : demander à une IA de résumer le style d’un texte. Un résumé garde le sujet et jette la voix, puisque la voix se trouve précisément dans ce qu’un résumé supprime : les incises, les digressions, la ponctuation, les petites prises de position en passant. Il faut le texte intégral, mot pour mot.

3. Distiller par axe, avec des citations. Pour chacun des cinq axes, notez les traits qui reviennent, et pour chaque trait, une citation exacte tirée de vos textes. La citation est le garde-fou.

Un trait qu’on ne peut pas illustrer par une phrase réellement écrite est un trait qu’on s’invente. « Ton direct » ne vaut rien ; « on tranche : “adieu le PR sculpting” » vaut quelque chose, parce qu’un modèle peut s’en servir.

Pour les traits qui se déclinent en variantes, comme les incises ou les formules d’ouverture, notez-en au moins cinq. Avec une liste de deux ou trois, le modèle les recycle en boucle, et vous retombez dans le tic. Si vos textes n’en fournissent pas assez, vous pouvez compléter par des tournures proches, à condition de les marquer comme des suggestions à valider : ce ne sont pas encore les vôtres.

4. Compter, pour fixer les doses. Une fois les traits repérés, comptez-les sur l’ensemble de vos textes et notez la fréquence à côté de chacun. Pensez aussi à ce qui n’apparaît jamais : une absence mesurée sur des dizaines de milliers de mots est une règle d’une fiabilité rare. C’est l’étape la plus fastidieuse à la main, et c’est elle qui fait la différence entre une voix et une imitation.

Attention, ces absences se transmettent mieux en positif. Plutôt que « jamais de tutoiement », écrivez « le lecteur est vouvoyé » ; plutôt qu’une liste d’expressions interdites, décrivez comment vous formulez une incise. Une consigne positive dit au modèle quoi faire. Un interdit lui dit seulement quoi éviter, et lui en parle quand même.

Et si vous n’avez pas encore trois articles publiés ? Prenez ce que vous avez écrit d’autre, à une condition : que ce soit vous qui l’ayez écrit. Une newsletter, de longs posts, la transcription d’une conférence font l’affaire. Ce qui ne fait pas l’affaire, ce sont les textes relus et réécrits par quelqu’un d’autre, parce qu’ils portent déjà deux voix.

Un dernier conseil : gardez le résultat court. Mon propre guide de voix pesait au départ plus de 10 000 caractères, soit 70 % des consignes de mon outil de rédaction. Il décrivait la voix, mais aussi la structure des articles : sommaire, listes, gras, maillage.

Résultat, les articles produits ressemblaient à des check-lists. Je l’ai ramené à moins de 6 000 caractères, en n’y laissant que la façon dont ça sonne. La voix dit comment ça sonne ; le plan de l’article, lui, se décide ailleurs.

Où la mettre une fois extraite

Une fois votre voix écrite, la tentation est de la recopier dans chaque outil : un bout dans le prompt de ChatGPT, une variante dans votre outil de rédaction, une autre dans les consignes d’un rédacteur freelance. Au bout de quelques mois, vous avez trois voix qui divergent, et plus aucune ne vous ressemble tout à fait. En gros, gardez-en une seule version, dans un seul document, et faites-la lire telle quelle par tous vos outils. Le jour où vous ajustez un trait, il change partout à la fois.

Un simple document texte suffit, du moment que vos outils le lisent tel quel. Évitez surtout qu’un outil le résume avant de s’en servir : un résumé de votre voix, c’est l’étape 2 à l’envers, on y perd exactement ce qu’on avait gagné.

Pour conclure

Votre voix de marque n’est pas un exercice de style à faire en atelier, avec des post-it et des adjectifs. Elle est déjà là, dans vos textes publiés, sous forme de régularités que vous pouvez compter : vos pronoms, votre rythme, vos tournures, et surtout ce que vous n’écrivez jamais. Ce qui manque à une IA pour écrire comme vous, ce n’est pas du talent. C’est cette description précise, avec ses doses.

Et vous, si vous passiez vos propres articles au crible, quel trait pensez-vous découvrir ?

Si vous voulez faire l’exercice sans écrire une ligne de script, j’ai construit un outil qui s’occupe des étapes 2 et 3 : vous lui donnez trois à cinq adresses de vos articles, il les lit (pas un résumé, le texte) et vous rend votre voix rangée en cinq axes, ses traits appuyés par des citations de vos textes, avec un rappel de dosage. Vous la récupérez sous deux formes : un bloc à coller dans n’importe quel assistant (ChatGPT, Claude, Mistral…) et un skill prêt à importer dans Claude. Le comptage de l’étape 4 reste de votre ressort : c’est là que votre relecture fait la différence. L’outil est gratuit.

Extrayez votre voix de marque à partir de trois de vos articles, gratuitement.

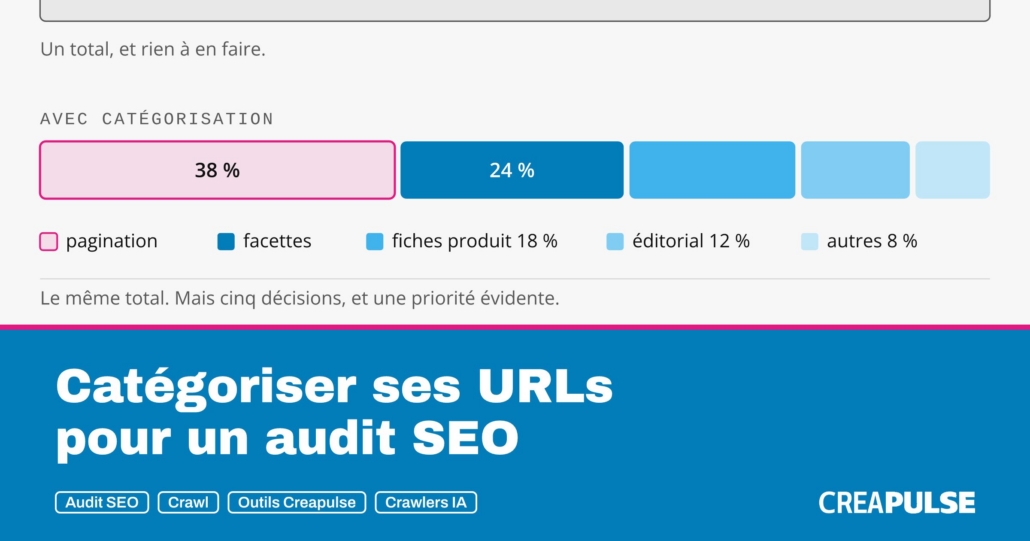
Un crawl de 100 000 URLs affiché comme une seule barre, puis la même largeur découpée par groupe : la catégorisation fait apparaître une répartition là où il n'y avait qu'un total.

En bref

  • Un crawl de 100 000 URLs ne dit rien tant qu’elles ne sont pas rangées : la question utile, c’est « combien de pages de quoi ? ».
  • Deux axes valent mieux qu’un arbre unique : la structure (parent > groupe) et le thème (univers), indépendants l’un de l’autre.
  • Une fois les URLs rangées, toutes vos métriques deviennent lisibles par groupe , et le croisement qui rapporte le plus, c’est crawl contre visites.
  • À peu près toute source d’URLs se catégorise : export de crawl, logs Googlebot, logs des bots IA, Search Console, sitemap.
  • Le vrai piège n’est pas la règle fausse, c’est la règle éclipsée : elle décrit les bonnes URLs, mais une règle placée plus haut les a déjà prises.
  • Et à la fin de l’article un lien vers l’outil URLCAT qui permet de catégoriser soi meme n’importe quelle liste d’urls

Bon, on va parler d’une étape que presque tout le monde saute, et qui décide pourtant de la qualité de tout ce qui suit : ranger ses URLs par catégorie avant de les analyser.

Comme à mon habitude, je vais essayer de vulgariser au maximum. À la fin, vous saurez pourquoi on catégorise, ce que ça fait apparaître, sur quelles sources de données ça marche, comment s’écrit une règle, et où les expressions régulières deviennent vraiment utiles — sans avoir à en devenir spécialiste.

Petite précision avant de commencer : les chiffres des schémas qui suivent sont des exemples, pas les relevés d’un site réel. Ils servent à montrer une forme de lecture.

Pourquoi ranger ses URLs avant de les analyser ?

Prenez un crawl de 100 000 URLs. Vous avez un tableau de 100 000 lignes, un taux de pages en erreur, une profondeur moyenne, un joli camembert de codes HTTP. Et vous ne savez toujours rien du site.

Parce que la question qui compte n’est jamais « combien de pages ? ». C’est « combien de pages de quoi ? ». Un site à 40 000 URLs de pagination et 2 000 fiches produit n’est pas le même site que l’inverse, et il n’appelle pas le même audit — alors que les deux rendent exactement le même tableau de bord.

Un total d’URLs, puis le même total réparti par groupeExemple. En haut, un crawl de 100 000 URLs affiché comme une seule barre : il ne porte qu’un total. En bas, la même largeur découpée en cinq groupes — pagination 38 pour cent, facettes 24, fiches produit 18, éditorial 12, autres 8 — ce qui rend la composition du site lisible et désigne la pagination comme le premier poste à traiter.SANS CATÉGORISATION100 000 URLs crawléesUn total, et rien à en faire.AVEC CATÉGORISATION38 %24 %paginationfacettesfiches produit 18 %éditorial 12 %autres 8 %Le même total. Mais cinq décisions, et une priorité évidente.
Exemple. Le total ne bouge pas : c’est sa composition qui devient lisible, et la pagination qui devient le premier poste à traiter.

Ranger les URLs, c’est ce qui transforme un tableau en diagnostic. Vous passez de « la profondeur moyenne est correcte » à « elle est correcte partout, sauf sur les fiches produit ». De « Googlebot crawle beaucoup » à « Googlebot dépense l’essentiel de son budget sur des URLs à paramètres ». De « le trafic stagne » à « le trafic ne vient que de deux groupes sur onze ».

Aucune de ces trois phrases n’est possible sans catégorisation. Et ce sont les trois seules qui mènent à une action. Si le vocabulaire du crawl vous manque, j’en ai fait un glossaire.

Quelles URLs peut-on catégoriser ?

N’importe quelle liste, en fait. Un catégoriseur ne crawle rien : il range ce qu’on lui donne. C’est pour ça que la même méthode, et le même fichier de règles, servent sur des sources qui n’ont rien à voir entre elles — et c’est en les croisant que ça devient intéressant.

SourceCe qu’elle contientCe que la catégorisation révèle
Export de crawl (Screaming Frog, Sitebulb…)les URLs que le site exposequels groupes pèsent, où se cache la profondeur
Logs Googlebotles URLs que Google visite vraimentoù part le budget de crawl
Logs des bots IA (GPTBot, ClaudeBot, PerplexityBot…)ce que les moteurs génératifs lisent chez vouss’ils lisent votre contenu utile ou vos pages techniques
Export Search Consoleles URLs qui ramènent des clicsquels groupes travaillent vraiment
Sitemap XMLles URLs que vous déclarezl’écart entre ce que vous déclarez et ce qui existe

Le cas des logs mérite une précision, parce qu’il change les comptages. Sur un log, la même URL revient des dizaines de fois : Googlebot repasse. Il faut donc compter les occurrences d’un côté, et classer chaque URL unique une seule fois de l’autre. Sur un échantillon que j’ai passé à la machine, 105 630 lignes de log ne faisaient que 14 777 URLs distinctes.

Et les deux poids ne racontent pas la même histoire : un groupe peut ne contenir qu’une seule URL et concentrer un millier de passages de crawl. Invisible dans un décompte d’URLs, énorme dans un décompte d’occurrences. J’ai détaillé la lecture d’un log dans L’analyse de logs, ce qu’il faut savoir.

Les deux axes : la structure et le thème

Une erreur classique, c’est de vouloir tout faire tenir dans un seul arbre. Ça ne marche pas, parce qu’une URL porte deux informations indépendantes.

L’axe structurel dit où vit la page : fiche produit, page de devis, article, pagination, panier. On le hiérarchise en parent > groupe, parce qu’on veut pouvoir replier « tout le site inutile » d’un côté et « tout le site utile » de l’autre. L’axe thématique — l’univers — dit de quoi elle parle : assurance auto, habitation, santé. Un seul niveau suffit.

Les deux axes de classement d’une URLUne grille croise l’axe structurel en lignes — fiches produit, pages de devis, éditorial, pagination — et l’axe thématique en colonnes — assurance auto, habitation, santé. Chaque URL occupe une seule case, à l’intersection d’un groupe et d’un univers ; la case mise en avant montre qu’une fiche produit de l’univers assurance auto est repérée par les deux axes à la fois, ce qu’un classement à un seul niveau perdrait.UNIVERSSTRUCTUREassurance autohabitationsantéfiches produitcette URLpages de deviséditorialpaginationUne URL occupe une seule case : un groupe, et un univers.Un classement à un seul niveau n’en garderait qu’une des deux coordonnées.
Les deux axes se croisent, et c’est l’intersection qui répond à « quel univers est mal servi par la structure du site ? ».

Pourquoi les séparer ? Parce qu’une fiche produit et un article de blog peuvent très bien parler du même univers tout en vivant à deux endroits qui n’ont rien à voir. Les mélanger, c’est perdre l’un des deux — et c’est justement le croisement des deux qui permet la question intéressante.

Quel type d’informations la catégorisation fait apparaître ?

C’est là que ça devient concret. La catégorisation ne produit aucune donnée nouvelle : elle rend lisibles celles que vous avez déjà. Toute métrique attachée à une URL devient une métrique par groupe, et par univers.

Ce qu’on croise avec les groupesLa question à laquelle ça répond
Passages de Googlebot (logs)Où part le budget de crawl ?
Clics et impressions (Search Console)Quels groupes travaillent vraiment ?
Pages indexées contre pages excluesQuel groupe Google refuse-t-il d’indexer ?
Profondeur de clicQuel groupe est enterré trop loin de l’accueil ?
Temps de réponse serveurQuel groupe coûte cher à crawler ?
Passages des bots IAQu’est-ce que les moteurs génératifs lisent chez moi ?

Chacune de ces lignes donne une répartition, et une répartition se regarde très bien en camembert — c’est ce que j’utilise le plus souvent dans mes audits pour montrer où part le crawl ou d’où viennent les visites. Mais le vrai rendement n’est pas dans une répartition seule : il est dans deux répartitions mises côte à côte.

Part du crawl Googlebot contre part des visites, par groupeExemple de lecture. Pour cinq groupes d’URLs, un point plein donne la part du crawl de Googlebot et un point creux la part des visites, sur une même échelle de 0 à 50 pour cent. La pagination reçoit 38 pour cent du crawl pour 2 pour cent des visites et les facettes 24 pour 1, tandis que l’éditorial ne reçoit que 12 pour cent du crawl pour 45 pour cent des visites : le crawl se dépense massivement là où le trafic n’est pas.pagination238facettes124fiches produit1834éditorial1245autres81801020304050PART DU TOTAL, EN %part du crawl Googlebotpart des visites
Exemple de lecture. La pagination prend 38 % du crawl pour 2 % des visites ; l’éditorial fait exactement l’inverse. Sans catégorisation, cet écart n’est tout simplement pas visible.

Un conseil de forme, appris à mes frais : le camembert est très bien pour une répartition, lue d’un coup d’œil, à six parts au maximum. Dès qu’il s’agit d’en comparer deux, il devient illisible — l’œil ne sait pas mettre deux angles en rapport. Deux barres, ou la forme ci-dessus avec un point par série, montrent l’écart immédiatement.

Et c’est cet écart qui vaut de l’argent. Un groupe qui absorbe le crawl sans ramener de visites, c’est du budget de crawl à redéployer. Un groupe qui ramène des visites sans être crawlé, c’est du maillage interne à refaire. Les deux se voient en trois secondes sur ce genre de figure, et pas du tout dans un tableau de 100 000 lignes.

Comment s’écrit une règle

Un fichier de règles est un fichier texte. Pas de base de données, pas d’interface : du texte qu’on relit, qu’on versionne et qu’on rejoue. Voici le minimum vital.

[crawl:categories]

@names
100	site
200	inutile

@
path /offers/*
+	/fr/offers/*
name fiches-offers
parent-id	100

@
path *utm_*
name inutiles-tracking
parent-id	200

@names déclare la table des parents. Chaque @ ouvre une règle : path porte le motif principal, + ajoute des motifs alternatifs (un OU), name donne le nom du groupe, et parent-id le rattache — il est facultatif, une règle peut n’avoir aucun parent.

Deux choses à savoir avant d’écrire le premier motif, parce qu’elles expliquent la quasi-totalité des surprises :

  1. Le premier motif qui correspond gagne, dans l’ordre du fichier. L’ordre des règles est donc une décision, pas un détail.
  2. Le motif porte sur le chemin ET la query string, pas sur le chemin seul. Sans ça, un motif comme *utm_* n’attraperait jamais rien.

Le motif le plus simple est un glob : * est le seul joker, et le motif est ancré aux deux bouts. Pas de correspondance par préfixe, donc pas de surprise :

Motif (glob)AttrapeN’attrape pas
/offers/offers/offers/, /offers/42
/offers/*/offers/42, /offers/a/b/offers
*utm_*/blog/a?utm_source=x/blog/a

Et oui : /offers et /offers/* sont bien deux règles distinctes. C’est déroutant cinq minutes, puis c’est reposant — on sait exactement ce qu’une règle attrape, sans avoir à le tester.

Les regex, le minimum qui suffit

Le glob couvre l’essentiel. Les expressions régulières servent quand il faut dire quelque chose que le glob ne sait pas exprimer : « un nombre », « l’une de ces trois langues », « seulement si ça se termine là ».

On préfixe alors le motif par rx:, et c’est une vraie regex, en recherche non ancrée — autrement dit le motif porte son ^ lui-même quand il veut démarrer au début de l’URL. Quatre ou cinq briques couvrent la quasi-totalité des cas réels :

BriqueCe que ça veut direRègle d’exemple
^début de l’URLrx:^/blog/
$fin de l’URLrx:^/offers/[0-9]+$
[0-9]+un ou plusieurs chiffresrx:/page/[0-9]+
(fr|en|de)l’un de ces choixrx:^/(fr|en|de)/
\?un point d’interrogation littéralrx:\?.*utm_
\.un point littéralrx:\.pdf$

Avec ça, vous isolez déjà vos pages de pagination, vos fiches à identifiant numérique, vos préfixes de langue, vos PDF et vos URLs taguées. C’est la moitié d’un fichier de règles réel.

Et le piège à connaître, celui qui passe inaperçu pendant des mois : le point non échappé. Dans une regex, . ne veut pas dire « un point », il veut dire « n’importe quel caractère ». Du coup rx:^/www.* n’attrape pas ce que vous croyez : il attrape /www suivi de n’importe quoi, /wwwarchive compris. Pour un point littéral, c’est \. — et c’est exactement le genre de chose qu’un outil doit vous signaler plutôt que vous laisser deviner.

Si les regex sont un terrain neuf pour vous, deux ressources suffisent. RegexOne est le plus efficace pour démarrer : les briques une par une, avec un exercice à chaque fois. Et regex101 pour tester un motif en direct, avec l’explication de chaque morceau — pensez à choisir la saveur Python dans la colonne de gauche, c’est celle que la plupart des catégoriseurs utilisent.

Pour une référence en français, le guide des expressions régulières de Python fait le travail, et il va bien plus loin que ce dont vous aurez besoin ici.

Dans mes audits, je catégorise très finement

C’est la première chose que je fais sur un audit, avant de regarder quoi que ce soit d’autre. Et je ne lésine pas : sur un gros site, ça monte vite à une trentaine de règles.

Pourquoi aussi fin ? Parce qu’un groupe trop large cache précisément ce qu’on cherche. « Pages produit », c’est confortable — et ça mélange les fiches en stock, les fiches épuisées, les fiches sans avis et les variantes de couleur qui dupliquent la fiche mère. Les quatre n’ont ni le même problème, ni la même valeur, ni la même action. Tant qu’elles sont dans le même sac, la moyenne les écrase toutes.

À mon sens, la catégorisation fine est ce qui sépare un audit « avancé » d’un audit qui récite les alertes d’un crawler. Les alertes, l’outil les sort tout seul. Ce qu’il ne sortira jamais tout seul, c’est quelle famille d’URLs mérite qu’on s’en occupe en premier. J’ai décrit cette façon de travailler plus largement dans ma méthodologie d’audit technique.

Il y a un effet de bord auquel je ne m’attendais pas, et qui est devenu la vraie raison de tout ça : le fichier de règles se rejoue. L’audit suivant sur le même site, je repars du même fichier, je l’ajuste, et je compare deux photos prises avec le même cadrage. Au bout de quelques passages, ce fichier vaut bien plus que n’importe quel outil : c’est de la connaissance du site, écrite, versionnée, transmissible.

Le piège : la règle qui ne gagne jamais

Voilà le défaut le plus coûteux, et le plus silencieux. Vous écrivez une règle juste, qui décrit exactement les bonnes URLs. Elle ne classe rien. Pas une erreur, pas un avertissement : zéro URL, et rien pour vous dire pourquoi.

La raison est mécanique. Puisque le premier motif qui correspond l’emporte, une règle placée plus haut a pu prendre ses URLs au passage — souvent par un * un peu large qui avale aussi la query string.

Premier motif gagnant et règle éclipséeUne URL est confrontée aux règles d’un fichier de catégorisation dans l’ordre. La règle 8 ne correspond pas, la règle 12 correspond et emporte le classement, et le balayage s’arrête là : la règle 27, qui correspondrait aussi, n’est jamais atteinte et ne classe donc aucune URL.LE SCAN S’ARRÊTEMATCHE AUSSIL’URL à classer/en/offer_collections/tech?set_locale=enRÈGLE 8/agencies/*→ groupe agencesPAS DE MATCHRÈGLE 12/en/offer_collections/*→ groupe collections1er MATCHRÈGLE 27*set_locale=*→ groupe inutiles-locale0 URLRETENUcollectionschemin suivi par l’URLrègle qui ne gagne jamais
Le premier motif qui correspond l’emporte : la règle 12 classe l’URL, le balayage s’arrête là, et la règle 27 — qui correspondrait pourtant — ne classe jamais rien.

Dans un tableur, ce défaut est invisible : rien ne vous dira qu’une de vos formules est morte. C’est pour ça qu’un catégoriseur doit savoir nommer la règle qui a volé les URLs, dire combien elle en a pris, et en montrer une. À partir de là, c’est à vous d’arbitrer — remonter la règle éclipsée, ou resserrer celle du dessus.

Et pendant qu’on y est, deux autres signaux valent le détour : la règle sans objet (aucune URL du corpus ne la touche : motif faux, ou règle périmée depuis une refonte) et l’hôte non déclaré (vos règles ont été écrites pour le staging, votre liste vient de la prod).

Questions fréquentes

Faut-il savoir coder pour écrire un fichier de règles ?

Non. Un fichier de règles, c’est une suite de lignes « ce motif → ce groupe », et le glob (* comme seul joker) suffit pour la majorité des règles. Les regex ne deviennent utiles que sur les cas que le glob ne sait pas dire, et quatre briques couvrent déjà presque tout.

Camembert ou barres pour présenter ces répartitions ?

Camembert pour une répartition lue d’un coup d’œil, six parts au maximum — au-delà, les parts voisines se confondent. Barres, ou un point par série sur une même échelle, dès qu’il s’agit d’en comparer deux : mettre deux angles en rapport est un exercice que l’œil rate, mettre deux longueurs en rapport est immédiat.

Combien de groupes faut-il viser ?

Autant qu’il y a de familles d’URLs qui appellent une action différente — pas une de plus, pas une de moins. Le bon test : si vous ne savez pas quoi faire de différent entre deux groupes, fusionnez-les ; si une moyenne à l’intérieur d’un groupe vous paraît suspecte, coupez-le en deux.

Puis-je réutiliser mes règles d’un site à l’autre ?

Les motifs, rarement : ils collent aux URLs d’un site. La structure, tout le temps : les parents « site utile » et « inutile », les groupes de pagination, de facettes, de paramètres de tracking se retrouvent partout. En pratique, on garde un squelette et on réécrit les motifs.

Glob ou regex, comment choisir ?

Glob par défaut : il se relit à voix haute, et un motif ancré aux deux bouts ne surprend personne six mois plus tard. Regex dès qu’il faut exprimer une quantité (« un nombre »), un choix (« fr, en ou de ») ou une fin stricte. Si vous hésitez, écrivez le glob : vous le remplacerez le jour où il ne suffira plus.

Les URLs des bots IA se lisent-elles comme celles de Googlebot ?

La méthode est la même — on filtre le log sur le user-agent, on en tire les URLs, on les classe avec le même fichier de règles. Ce qui change, c’est la lecture : sur Googlebot on cherche où part le budget de crawl, sur GPTBot ou ClaudeBot on cherche si ce qu’ils lisent est bien le contenu qu’on voudrait voir cité. Mêmes groupes, deux questions différentes.

Vous avez une liste d’URLs et un fichier de règles ? urlcat les classe par groupe et par univers, et vous dit lesquelles de vos règles ne gagnent jamais.

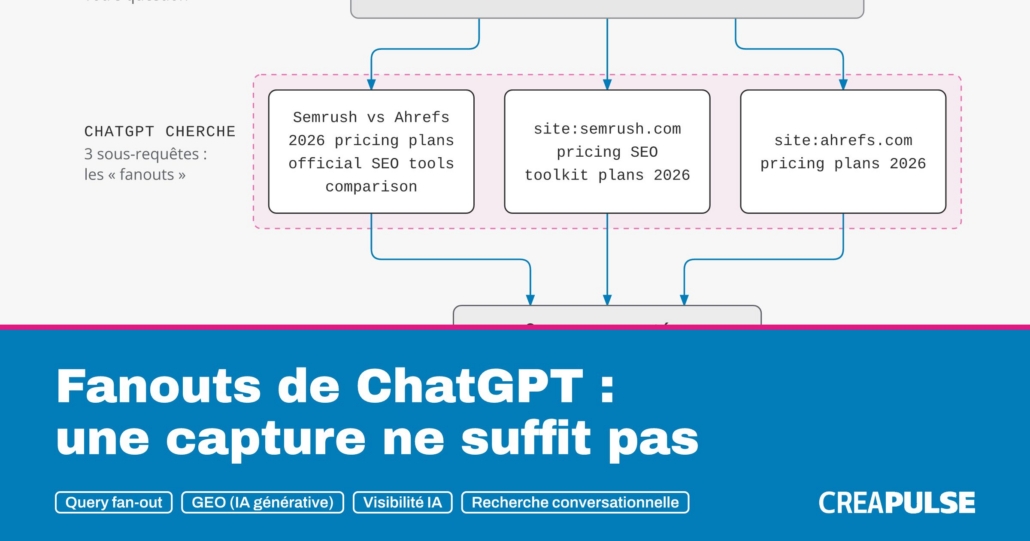
Schéma : de la question « Semrush ou Ahrefs pour une PME française ? » aux trois sous-requêtes lancées par ChatGPT, puis aux 8 pages lues et aux 2 sites cités.

Ce qu’il faut retenir

  • Les fanouts sont les sous-requêtes que ChatGPT lance quand il cherche sur le web. J’en ai capté 30 séries, sur 6 prompts SEO, le 12 octobre 2026.
  • Sur 60 comparaisons entre deux runs du même prompt, une seule paire contient exactement les mêmes sous-requêtes.
  • Sur un prompt commercial, 5 runs remontent 48 domaines différents, dont un seul commun aux cinq.
  • 42 sous-requêtes sur 53 sont en anglais, pour des prompts posés en français.
  • Derrière 24 formulations différentes, il n’y a que 3 intentions. C’est elles qu’il faut regarder.

Quand ChatGPT va chercher sur le web pour vous répondre, il ne tape pas votre question dans un moteur. Il la découpe en plusieurs sous-requêtes, qu’on appelle des fanouts, et c’est avec elles qu’il trouve les pages qu’il lit et qu’il cite. Voir ces fanouts, c’est voir ce que l’IA cherche vraiment.

J’ai voulu regarder ça de près sur des prompts SEO, et pas une fois : 30 fois, dans des conditions propres. Je vais tenter ici d’expliquer ce que j’ai vu, sachant que le sujet bouge vite (le format des données a changé entre le 1er et le 12 octobre, c’est dire). Comme à mon habitude, je vais vulgariser au maximum.

C’est quoi, un fanout ?

Pour faire simple : vous posez une question, le modèle la transforme en requêtes de recherche, il lit les résultats, puis il rédige sa réponse en citant quelques sources.

Un exemple réel. À la question « Semrush ou Ahrefs pour une PME française ? », ChatGPT a lancé ces trois recherches :

  • Semrush vs Ahrefs 2026 pricing plans official SEO tools comparison
  • site:semrush.com pricing SEO toolkit plans 2026
  • site:ahrefs.com pricing plans 2026
Le trajet d’un fanout, de la question aux sources citéesÀ partir de la question « Semrush ou Ahrefs pour une PME française ? », ChatGPT lance trois sous-requêtes (les fanouts), lit 8 pages venues de 5 sites, puis cite 2 sites : semrush.com et ahrefs.com.VOUS DEMANDEZCHATGPT CHERCHEIL LITIL CITEvotre question3 sous-requêtes :les « fanouts »les pages remontéesquelques sources« Semrush ou Ahrefs pour une PME française ? »Semrush vs Ahrefs2026 pricing plansofficial SEO toolscomparisonsite:semrush.compricing SEOtoolkit plans 2026site:ahrefs.compricing plans 20268 pages remontées5 sites différents2 sites citéssemrush.com · ahrefs.com
Sur ce run du 12 octobre 2026 : trois sous-requêtes, 8 pages lues sur 5 sites, 2 sites cités.

Vous me direz : il suffit de lui demander ce qu’il a cherché. J’ai essayé, six fois, juste après sa réponse. Il ne sait pas vous les redonner. Il répond qu’il n’a pas accès à l’historique de ses recherches, et c’est plutôt honnête de sa part : il n’a rien inventé. Mais du coup, il faut aller les chercher soi-même.

Comment on capte les fanouts de ChatGPT ?

Les sous-requêtes circulent dans les données que ChatGPT envoie à votre navigateur pendant qu’il répond. Il « suffit » de les lire au passage.

Deux façons de faire. La première, c’est l’extension Search & fan-out capture de RESONEO, gratuite, qui fait ça très bien. La seconde, c’est un petit script collé dans la console du navigateur. J’ai utilisé les deux sur les mêmes runs : 7 sous-requêtes sur 7 identiques. Et pour être honnête, leur capture est plus complète que mon script, qui avait raté une partie des pages remontées avant que je le corrige.

Reste à ne pas mesurer n’importe quoi. Mon protocole tient en quatre lignes :

  • un chat temporaire en mode « Non personnalisé » ;
  • un chat neuf à chaque run ;
  • le même prompt, au caractère près ;
  • le modèle réellement servi, noté à chaque fois.

À noter que le premier point est un piège. Par défaut, le chat temporaire de ChatGPT est « Personnalisé » : il lit votre mémoire et vos instructions. J’ai vérifié en posant la même question dans les deux modes : ChatGPT déclare avoir accès à 8 éléments de mémoire dans l’un, à 0 dans l’autre. Si vous mesurez en mode personnalisé, vous mesurez votre compte autant que le modèle.

Avec ça, j’ai lancé 6 prompts SEO, 5 fois chacun, le 12 octobre 2026 : le meilleur outil pour suivre sa visibilité dans les IA, Semrush ou Ahrefs, une agence SEO à Lyon, le prix d’un audit SEO, l’utilité du fichier llms.txt, et comment apparaître dans ChatGPT. Soit 30 runs et 53 sous-requêtes.

Le même prompt, cinq fois : qu’est-ce qui change ?

À peu près tout. Et à chaque étage.

Les requêtes

Sur les 60 comparaisons possibles entre deux runs d’un même prompt, une seule paire est identique. Sur 53 sous-requêtes, 49 formulations différentes.

Prenez le prix d’un audit SEO. Trois runs, trois recherches :

  • prix audit SEO France 2026 tarifs agence freelance audit technique sémantique
  • prix audit SEO France 2026 tarif agence freelance audit technique éditorial
  • prix audit SEO France tarifs agence consultant 2026

C’est la même idée, mais c’est jamais la même chaîne.

Les pages remontées

C’est là que ça se corse. Des requêtes presque identiques ne ramènent pas les mêmes résultats.

PromptDomaines différents sur 5 runsCommuns aux 5 runs
Meilleur outil de visibilité IA481
Utilité du fichier llms.txt502
Apparaître dans ChatGPT293
Semrush ou Ahrefs163
Prix d’un audit SEO141
Agence SEO à Lyon158

Sur le prompt commercial, le recouvrement moyen entre deux runs est de 11 %. Seul le prompt local est stable : à Lyon, 8 domaines reviennent à tous les coups.

Les sources citées

Être remonté ne veut pas dire être cité. À Lyon justement, 8 domaines sont présents dans les 5 runs… et aucun n’est cité dans les 5. Le plus régulier l’est 4 fois, le suivant 3.

Sur le prompt commercial, 21 domaines différents ont été cités au fil des 5 runs, aucun à chaque fois.

Les seules sources vraiment stables sont les sites officiels : la documentation d’OpenAI citée 5 fois sur 5 quand on demande comment apparaître dans ChatGPT, semrush.com et ahrefs.com 5 fois sur 5 sur le comparatif.

Une capture, c’est un tirage. Un peu comme un lancer de dés : vous voyez un résultat, pas la loi qui est derrière.

Qu’est-ce qu’une seule capture vous fait croire ?

J’ai fait le test avec l’extension de RESONEO : le même prompt (« Semrush ou Ahrefs pour une PME française ? »), capté deux fois à 45 secondes d’écart.

Capture 1Capture 2En commun
Sous-requêtes330
Pages remontées333416
Domaines8148
Pages affichées en citation300

Avec la première capture, vous concluez que ChatGPT cite trois pages de Semrush et d’Ahrefs. Avec la seconde, qu’il n’en met aucune en avant. Les deux sont vraies. Les deux sont incomplètes.

La variabilité elle-même n’est pas la faute de l’outil, c’est mécanique : c’est ChatGPT qui se comporte comme ça. Le souci, c’est que rien ne vous le dit. Ni la page de présentation de l’extension ni son tableau de bord ne préviennent que deux captures du même prompt peuvent n’avoir aucune requête en commun. Vous regardez une capture, vous la prenez pour la réponse.

Ce que fait cette extension, et elle le fait bien, c’est lister : chaque conversation, ses requêtes, ses pages. Elle n’est pas pensée pour comparer plusieurs runs d’un même prompt. J’ai essayé quand même, en rangeant mes deux captures dans un projet (version 6.0.1). Les requêtes s’empilent dans une liste à plat, où trois formulations de la même idée comptent pour trois. Et le compteur du haut additionne au lieu de dédoublonner : 22 « domaines détectés » pour 14 réellement distincts. Il y a bien une colonne qui indique dans combien de conversations un domaine apparaît, mais rien qui dise, côté requêtes, ce qui revient et ce qui est un accident.

Ce qui ne change pas : les intentions

Bon, si tout bouge, on fait quoi ?

On regarde autrement. D’un run à l’autre, les sous-requêtes d’un même prompt partagent 55 à 78 % de leurs mots. Les formulations changent, le sujet cherché, lui, reste.

J’ai donc regroupé les sous-requêtes par intention : celles qui cherchent la même chose vont ensemble, quelle que soit leur formulation ou leur langue. Sur « Semrush ou Ahrefs », j’ai 10 runs (les 5 de la série, plus 5 runs de contrôle), qui ont produit 24 formulations différentes. Regroupées, ça donne ça :

Ce que l’IA chercheFormulationsPrésent dans
Quels sont les tarifs de Semrush et d’Ahrefs ?1410 runs sur 10
Semrush ou Ahrefs : lequel choisir ?910 runs sur 10
Quelles fonctionnalités propose Semrush ?11 run sur 10

24 lignes d’un côté, 3 de l’autre. Et surtout une information qu’une liste ne donne pas : les deux premières intentions sont là à chaque fois, la troisième est un accident.

Même chose sur le prompt commercial : 22 formulations, 5 intentions, dont une seule présente dans les 10 runs.

C’est ça, la donnée utile : les questions que l’IA se pose à tous les coups, celles qu’elle se pose une fois sur dix, et pas la formulation exacte du jour.

Qu’est-ce qu’on voit quand on regroupe ?

Trois choses, que je n’aurais pas vues sur une capture isolée.

Elle cherche souvent en anglais. 42 sous-requêtes sur 53 sont en anglais, pour des prompts posés en français. Le français n’apparaît que quand le prompt contient un ancrage géographique (« à Lyon », « en France »). Pourquoi ? Personne ne le sait vraiment : OpenAI ne documente pas le choix de la langue. Je ne suis pas le seul à le voir, Peec AI a mesuré la même chose en février 2026 sur plus de 10 millions de prompts : 43 % des fanouts de prompts non anglais partent en anglais. Attention à ne pas en tirer trop : la langue d’une sous-requête ne dit pas quelles sources l’IA retiendra.

Elle choisit ses marques avant de chercher. À la question du meilleur outil de visibilité IA, mon prompt ne cite aucun nom. Pourtant Profound, Peec et Otterly sont écrits dans les sous-requêtes de 4 runs sur 5. Le modèle sait déjà qui il va regarder. Si votre marque n’est pas dans ce lot, le problème n’est pas votre contenu, c’est votre notoriété.

Elle va parfois directement sur un site. Dans 3 runs sur 30, tous sur le prompt qui nomme deux marques, ChatGPT a utilisé l’opérateur site: pour aller lire la page de tarifs de chacune. Et ça, sans aucune personnalisation du compte.

Notre approche : répéter, regrouper, noter la fiabilité

Vous l’aurez compris, je ne crois plus à la capture unique. L’outil que j’ai construit part de trois principes :

  • répéter : plusieurs passes par prompt, systématiquement ;
  • regrouper : des intentions rédigées en clair, avec les sous-requêtes qui les composent ;
  • noter la fiabilité : « présent dans 3 passes sur 3 » ne vaut pas « 1 sur 3 ».
Une captureNotre approche
Ce que vous lisezune liste de requêtesdes intentions
Les variantes d’une même idéecomptées séparémentregroupées
Ce qui est stableimpossible à direnoté, passe par passe
Les marques et les sites visésà repérer à l’œilsignalés

Voici ce que sort le prototype sur « Semrush ou Ahrefs » : les tarifs d’Ahrefs et de Semrush dans 3 passes sur 3, le comparatif dans 2 sur 3, les données de mots-clés pour la France dans 1 sur 3. Avec un signal en plus : l’IA va lire directement ahrefs.com et semrush.com.

L’outil va un cran plus loin : il dit pour chaque intention si elle mérite une page dédiée ou une simple section, avec un titre appuyé sur ce que Google affiche déjà.

Envie de voir ce que l’IA cherche sur vos sujets ? Fanouts IA répète votre question, regroupe les fanouts par intention de recherche et vous dit s’il faut une page dédiée ou une section. 2 analyses complètes offertes.

Conclusion

Ce qu’il faut retenir c’est que les fanouts de ChatGPT ne sont pas une liste à collectionner. Les requêtes changent à chaque run, les pages remontées encore plus, les sources citées aussi. Ce qui tient, ce sont les intentions, et il faut plusieurs passes pour les voir.

J’espère ne pas vous avoir perdu en route 😉

Et vous, quand vous regardez ce que ChatGPT dit de votre marque, vous le faites sur un run, ou sur plusieurs ?

Questions fréquentes

Quelle différence entre un fanout et une requête ?

La requête, c’est ce que vous tapez. Les fanouts sont les sous-requêtes que le modèle en tire pour interroger un moteur : entre 1 et 4 par réponse dans mes captures.

Combien de fois faut-il répéter un prompt ?

Plus d’une, c’est le minimum. Dans mes captures, les intentions principales revenaient à chaque run et les secondaires une fois sur dix : quelques passes suffisent pour voir les premières. Pour les pages remontées, c’est une autre histoire : sur un sujet commercial, 5 runs n’en font pas le tour (48 domaines différents).

L’outil lit-il ma session ChatGPT ?

Non. Il interroge les modèles plusieurs fois par leur API, sans toucher à votre compte. Ce n’est pas exactement le produit que vous utilisez, alors je le contrôle contre des captures réelles : sur mes 6 prompts, 8 des 9 intentions les plus fréquentes dans ChatGPT sont retrouvées en 3 passes.

Faut-il un compte payant pour capter ses fanouts ?

Non, tout a été fait sur un compte gratuit. Sachez juste qu’il change de modèle après quelques messages (de gpt-6 à gpt-6-mini au bout de 5 dans mon cas). Sur les deux prompts que j’ai comparés, les deux modèles se comportent de la même façon.

Et Gemini ?

Sur mes 6 prompts, Gemini reformule très peu : aucune recherche pour deux d’entre eux, la question reprise telle quelle pour trois, deux sous-requêtes pour un seul. C’est une observation sur 6 cas, pas une étude.


Méthode et limites. Mesures du 12 octobre 2026 : un seul compte (gratuit), un seul jour, une connexion hors de France, 5 runs par prompt sur le modèle gpt-6-mini. Le format des données lues n’est pas documenté par OpenAI et change régulièrement.

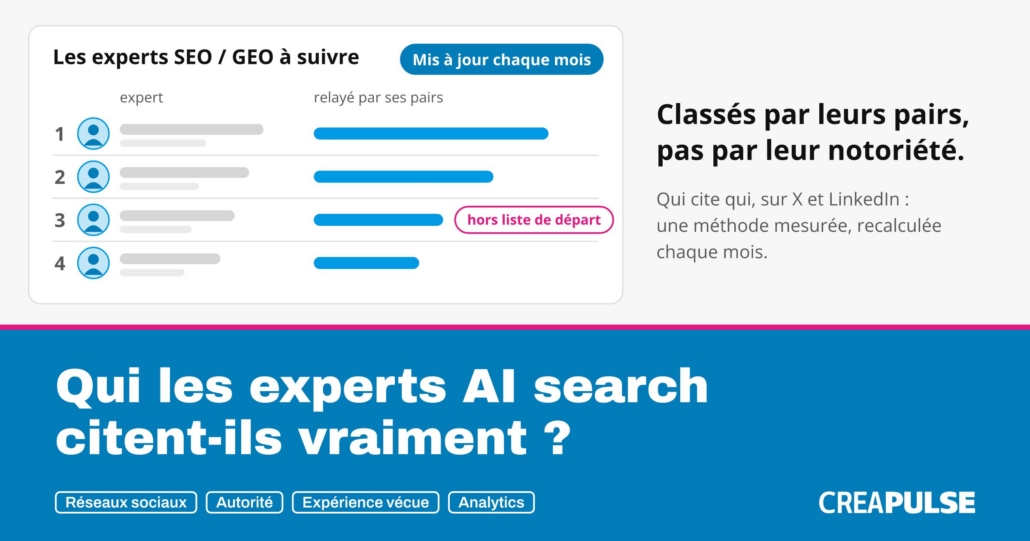
Une liste curée d'experts SEO / GEO à suivre, classés par leurs pairs et non par leur notoriété, mise à jour chaque mois.

En bref

  • Une liste de 28 « experts AI search » publiée par un blog a été confrontée aux citations réelles entre ses membres, sur trente jours, sur X puis sur LinkedIn.
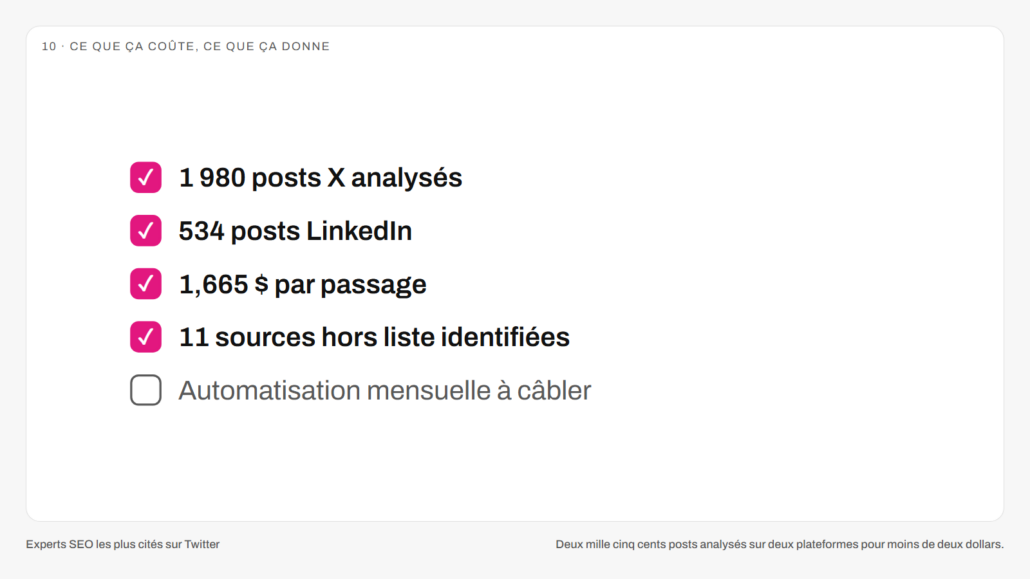
  • 2 514 posts analysés (1 980 sur X, 534 sur LinkedIn) pour 1,665 $ de données au total.
  • Le compte le plus relayé par ces experts ne figure pas dans la liste : 125 citations, par 13 des 20 comptes actifs.
  • LinkedIn ne permet pas de classer qui que ce soit par citations, mais il réhabilite deux personnes que X faisait passer pour inactives.
  • La décision la plus rentable n’était pas technique : « aucun paramètre chiffré en dur ». Elle a révélé un calcul faux en dix minutes.

Article fil rouge — dernière mise à jour : 12 octobre 2026 · statut : mesure faite, automatisation mensuelle à câbler. Ce qui a changé : première publication.

Pourquoi j'ai refusé de croire une liste d'experts

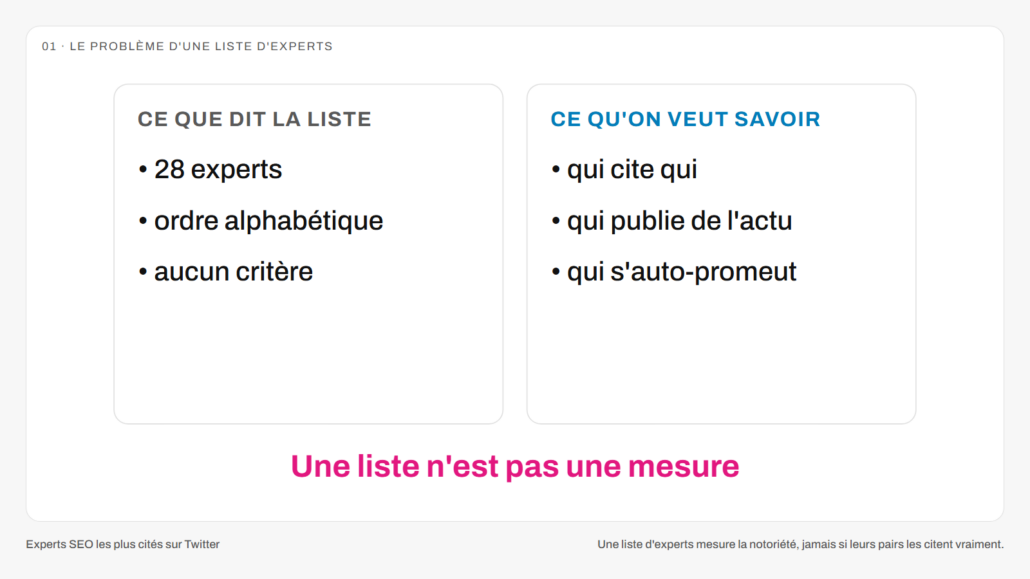
Bon, je vais être direct : une liste de « X experts à suivre », ça mesure la notoriété de ceux qui y figurent, et c’est à peu près tout. Ça ne dit pas qui est réellement lu par ses pairs, ni qui publie de l’information plutôt que sa propre promotion.

Le point de départ, c’est un article d’iloveseo.net qui liste 28 spécialistes de la recherche par IA. Je voulais en ajouter quelques-uns à ma liste de veille, mais seulement ceux qui diffusent de l’actualité substantielle. Deux critères donc, à croiser : être cité par les autres, et publier autre chose que soi-même.

Plutôt que de trancher à l’intuition, on a mesuré. Je vais raconter ici comment, avec les chiffres, et surtout avec les trois endroits où la méthode s’est trompée avant de se corriger. Parce que c’est là que ça devient intéressant.

Une liste d'experts mesure la notoriété, jamais si leurs pairs les citent vraiment

Comparaison entre ce que dit la liste d'experts et ce qu'on veut réellement savoir
Une liste n'est pas une mesure.

Le premier réflexe, c’est de poser la question correctement. La liste donne 28 noms, dans l’ordre alphabétique, sans critère. Ce qu’on veut savoir, c’est qui cite qui, qui publie de l’actu, et qui s’auto-promeut.

Ce qui s’est dit — Moi : regarde ces 28 personnes, dis-moi lesquelles sont les plus citées entre elles. Claude : il faut d’abord retrouver leurs comptes, puis compter les citations réelles sur trente jours.

Pour faire simple : avant de compter quoi que ce soit, il faut un corpus. Trente jours de publications pour chacun des 28, et une définition claire de ce qu’on appelle une citation.

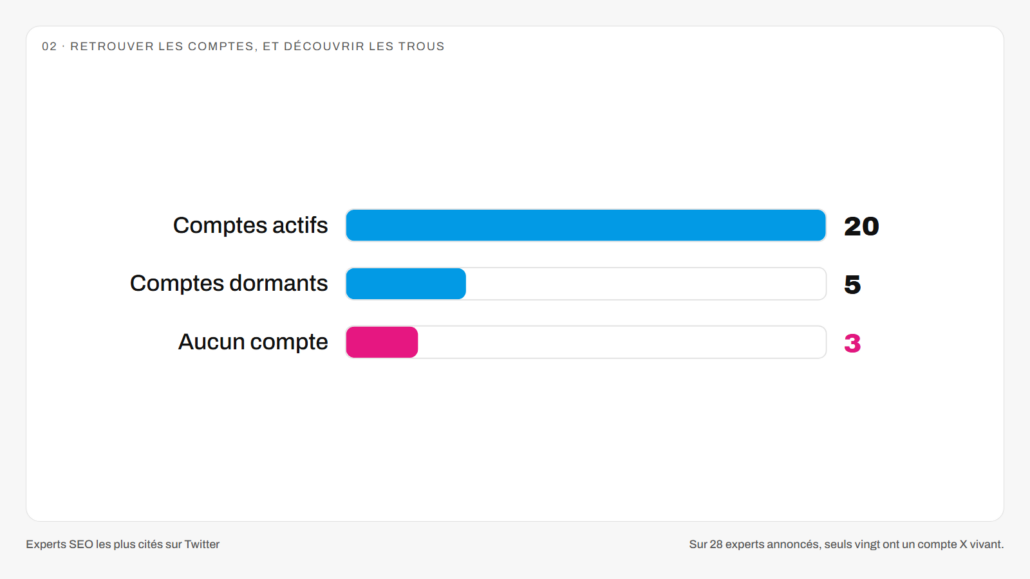
Sur 28 experts annoncés, seuls vingt ont un compte X vivant

Vingt comptes actifs, cinq comptes dormants, trois personnes sans compte X
Vingt comptes actifs, cinq dormants, trois introuvables.

Première surprise, avant même d’analyser quoi que ce soit : retrouver les comptes. La liste était bâtie sur LinkedIn, pas sur X. Une sonde automatisée à six millièmes de dollar sur 24 hypothèses de pseudos, puis onze recherches web pour les cas difficiles, et voilà le bilan : 25 comptes trouvés, 3 personnes sans aucun compte, 5 comptes abandonnés depuis des mois.

Ce qui s’est dit — Moi : cherche-les sur X et analyse leurs trente derniers jours. Claude : vingt-cinq comptes trouvés, trois introuvables, cinq dormants, le plus récent depuis janvier 2025.

À noter que l’un des experts a deux comptes, le sien et celui de son agence. Il a fallu les fusionner pour le comptage, sinon il aurait été compté deux fois, ou pas du tout.

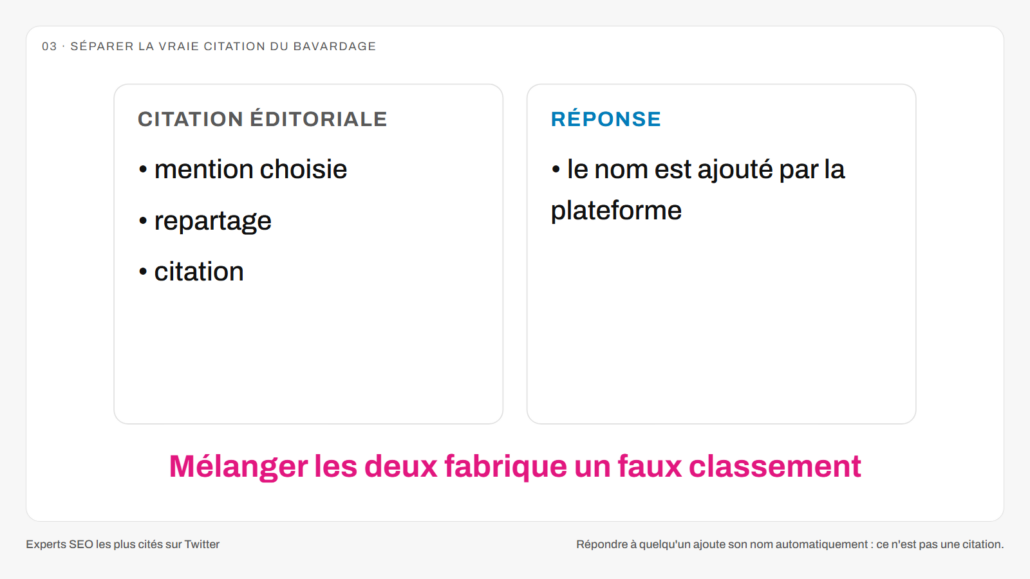
Répondre à quelqu'un ajoute son nom automatiquement : ce n'est pas une citation

Différence entre une citation éditoriale et une réponse où la plateforme ajoute le nom
Mélanger les deux fabrique un faux classement.

C’est le piège classique des comptages de mentions. Sur X, quand vous répondez à quelqu’un, son nom est inséré automatiquement dans votre message. Deux personnes qui discutent beaucoup gonflent donc leur score mutuel sans qu’aucune des deux n’ait décidé de citer l’autre.

On a donc séparé deux choses : les mentions éditoriales, celles d’un post original, d’un repartage ou d’une citation, et les réponses, où le nom est ajouté par la plateforme. Et on a ajouté un deuxième compteur, le nombre de pairs distincts : dix citations par dix personnes différentes valent plus que dix citations par une seule.

Ce qui s’est dit — Moi : je veux ceux qui balancent de l’actu intéressante, pas seulement de l’auto-promotion. Claude : alors on compte aussi les pairs distincts.

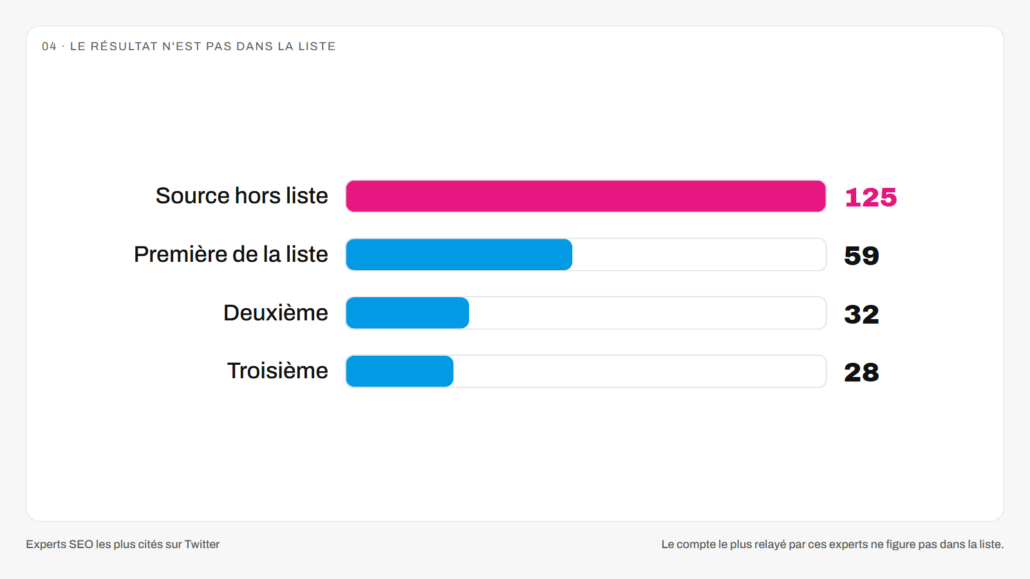
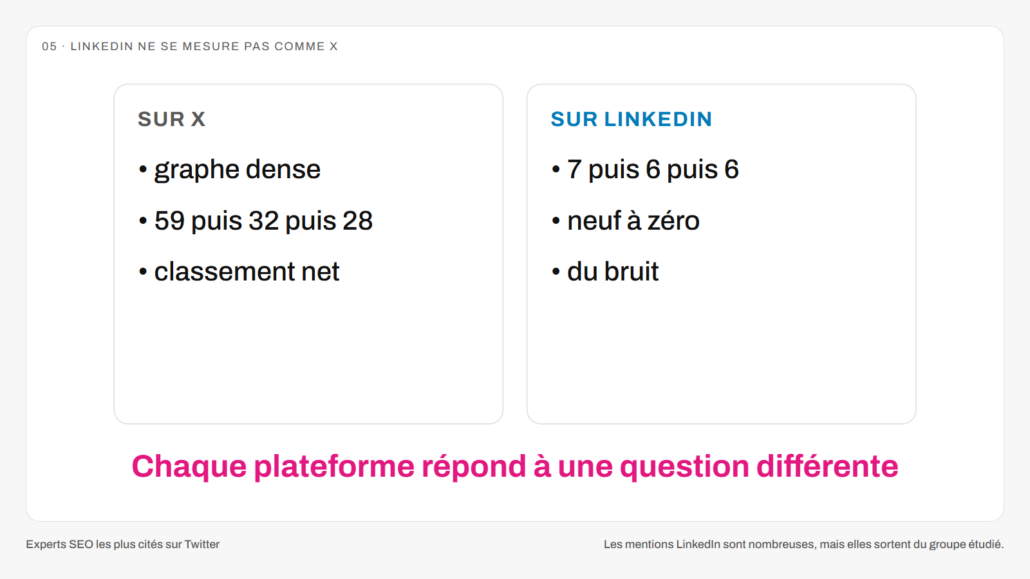
Le corpus X : 1 980 posts sur trente jours, du 12 septembre au 12 octobre 2026, pour 0,297 $. Le classement qui en sort est net, avec une vraie séparation en tête : 59 citations pour la première, puis 32, puis 28.

Le compte le plus relayé par ces experts ne figure pas dans la liste

La source hors liste reçoit 125 citations contre 59 pour la première de la liste
125 citations pour un compte absent de la sélection.

Et voilà le résultat qui justifie tout le reste. Treize des vingt comptes actifs relaient la même personne, et cette personne n’est pas dans la liste des 28. Cent vingt-cinq citations, contre 59 pour la mieux classée de la liste.

Ce qu’il faut retenir, c’est que les experts de la liste commentent l’information. Quelqu’un d’autre la produit. Si vous ne deviez ajouter qu’un compte à votre veille, ce serait celui-là, et aucune liste ne vous l’aurait donné.

Ce qui s’est dit — Moi : l’idée est de les ajouter à ma liste de veille. Claude : alors commence par celui qu’ils relaient tous, et qui n’est pas dans la liste de départ.

Les mentions LinkedIn sont nombreuses, mais elles sortent du groupe étudié

Sur X un graphe de citations dense, sur LinkedIn un graphe trop clairsemé pour classer
Chaque plateforme répond à une question différente.

La liste de départ venait de LinkedIn, donc logique d’y refaire la mesure. On s’attendait au même graphe de citations. Ça n’a pas marché, et c’est une vraie leçon.

Les mentions y sont denses, 403 pour 399 posts, mais elles pointent massivement vers l’extérieur du groupe. Entre les 28, le graphe plafonne à sept citations, avec neuf personnes à zéro. Impossible de classer qui que ce soit là-dessus. Pour faire simple, X est une clique, LinkedIn est un réseau ouvert.

Ce qui s’est dit — Moi : analyse aussi leurs profils LinkedIn, la liste vient de là. Claude : testé, les mentions sont denses mais dispersées, donc LinkedIn servira à autre chose.

Décision : deux classements, jamais fusionnés. X trié par citations reçues, LinkedIn par engagement. Un score composite aurait additionné deux signaux qui n’ont rien à voir.

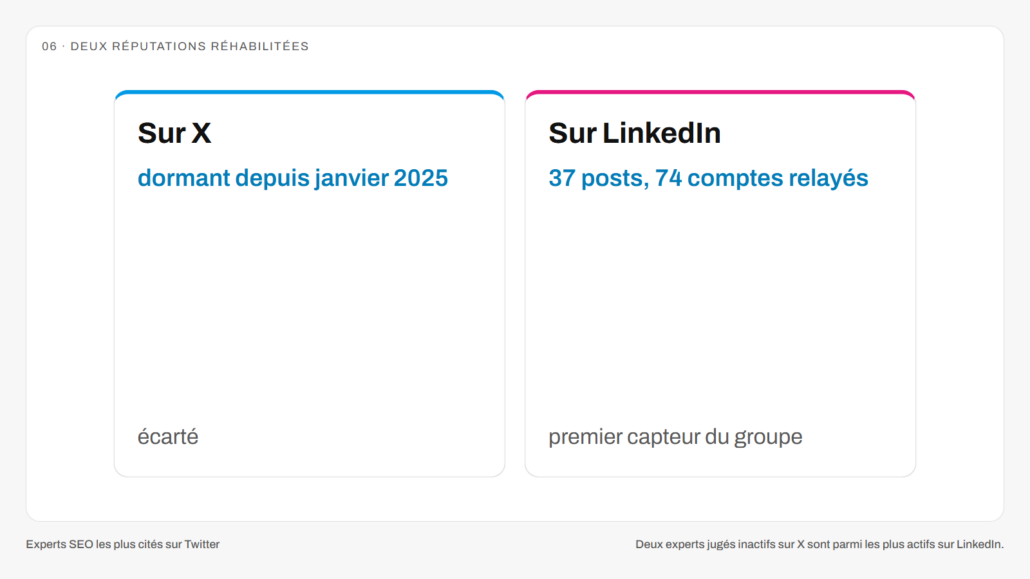
Deux experts jugés inactifs sur X sont parmi les plus actifs sur LinkedIn

Un même profil dormant sur X et premier capteur de sources sur LinkedIn
Le verdict change quand on change de plateforme.

C’est l’autre apport de LinkedIn, et il est concret. Une personne n’avait rien publié sur X depuis janvier 2025 ; sur LinkedIn, elle relaie 74 comptes par mois, ce qui en fait le premier capteur de sources neuves du groupe. Une autre, elle aussi silencieuse sur X, obtient le meilleur engagement des 28 sur LinkedIn.

Une analyse mono-plateforme les jugeait sur un terrain qu’elles avaient quitté. Vous me direz que c’est évident une fois écrit. Ça ne l’était pas avant la mesure.

Ce qui s’est dit — Moi : après tout, la liste de départ vient de LinkedIn, logique d’y mesurer leur pertinence. Claude : tu avais raison, deux profils changent complètement de verdict.

Au passage, une source neuve est apparue : citée par cinq membres distincts, soit plus que n’importe quel membre de la liste. Avec une nuance honnête, deux des cinq sont ses collègues.

Aucun paramètre chiffré en dur : tout se recalcule, sinon la mesure ment

Un paramètre dérivé mais faux est pire qu'une constante en dur, parce qu'il ne se voit pas
La consigne qui a trouvé un bug.

On arrive au moment le plus instructif. Pour passer de « combien de citations » à « quel engagement, quelle portée », il faut des seuils. La première version les posait en dur : tel pourcentage, telle valeur. J’ai refusé. Ce qui est vrai d’un domaine ne l’est pas d’un autre, donc tout doit être recalculé sur les données du mois, ou déclaré comme valeur importée avec sa provenance.

Appliquer cette règle a immédiatement révélé un calcul défaillant. L’estimation de l’âge auquel les interactions d’un post se stabilisent renvoyait « un jour ». Plausible. Faux. Une coupe transversale sur des posts différents ne peut pas mesurer une accumulation : la variance entre posts écrase tout. Et ce chiffre faux avait changé en silence un tiers du corpus analysé, 571 posts jugés exploitables au lieu de 429.

Ce qui s’est dit — Moi : aucun paramètre en dur. Claude : appliqué, et ça a attrapé un calcul faux mais plausible que rien ne signalait.

Un paramètre dérivé mais faux est pire qu’une constante en dur, parce qu’il ne se voit pas. Depuis, chaque dérivation automatique porte un test de validité et un repli déclaré. C’est écrit dans la spec, et c’est transférable bien au-delà du SEO.

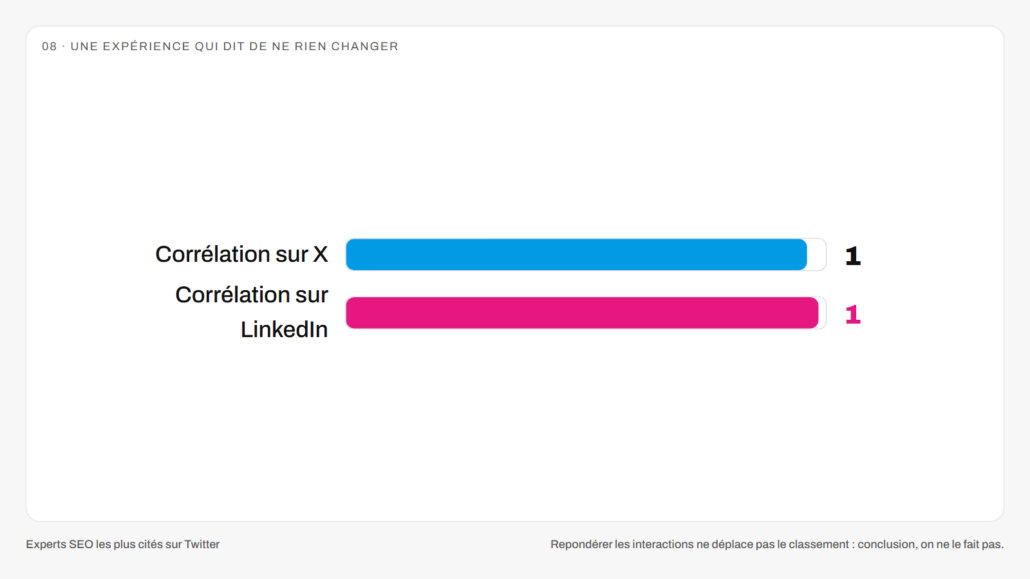
Repondérer les interactions ne déplace pas le classement : conclusion, on ne le fait pas

Corrélation de 0,96 sur X et 0,985 sur LinkedIn entre les deux variantes de poids
0,96 sur X, 0,985 sur LinkedIn.

Une autre idée séduisante : pondérer chaque type d’interaction par sa rareté, plutôt que d’utiliser des poids simples de 1, 3 et 5. Les poids dérivés sortent deux à quatre fois plus élevés. Et le classement des personnes ne bouge pas : corrélation de 0,96 sur X et 0,985 sur LinkedIn entre les deux variantes.

Ce qui s’est dit — Moi : compare la variante dérivée aux poids simples. Claude : les poids n’ont aucun effet utile sur le classement.

Les trois types d’interaction sont trop corrélés pour que la pondération compte. Donc on ne change rien, et l’idée est rangée ailleurs : qualifier la forme de l’engagement d’un post, pas classer des personnes. Une expérience qui conclut « ne touchez à rien » est une bonne expérience.

Sept zones de la page se rafraîchissent chaque mois sans toucher au texte

Pipeline de mesure d’influence X + LinkedInDeux sources, les posts X et les posts LinkedIn avec leurs abonnés, sont analysées séparément, citations croisées d’un côté et engagement de l’autre, puis un recalcul des paramètres sur le corpus du mois alimente les sept zones dynamiques d’une page WordPress dont le texte rédactionnel reste intact.UN PASSAGE MENSUEL, 1,665 $ DE DONNÉESPAGE WORDPRESS DE VEILLE1 980 POSTS534 POSTSCITATIONSENGAGEMENTCHAQUE MOISSOURCEPosts X, 30 joursscraper du Store ApifySOURCEPosts LinkedIn + abonnésposts et profilsANALYSECitations croiséesmentions, pairs distinctsANALYSEEngagement et découvertepas de classementRÈGLERecalcul des paramètressur le corpus du moisseuils en quantilesratio vues/abonnés mesuréaucun chiffre en durJAMAIS FUSIONNÉSREMPLACÉ7 zones dynamiquestableaux, scores, sourcesINTACTTexte rédactionneljamais réécritLÉGENDESource de donnéesAnalyse par plateformeRègle qui gouverne toutMis à jour chaque moisCHIFFRES MESURÉS LE 12/10/2026 · 28 EXPERTS · 1 980 POSTS X · 534 POSTS LINKEDIN
Le pipeline de mesure : deux sources analysées séparément, un recalcul des paramètres sur le corpus du mois, puis sept zones de la page remplacées sans toucher au texte rédactionnel. Mesures du 12 octobre 2026.

Une mesure faite une fois vieillit vite. La page de veille qui en est sortie est donc conçue pour être rafraîchie chaque mois : les tableaux, les scores et les sources émergentes vivent dans sept zones balisées qu’un automate remplace. Le texte rédigé, lui, reste figé.

Le piège, c’est l’ordre. Si les sections par personne étaient rangées par rang, le texte contredirait les tableaux dès la deuxième mise à jour. Elles sont donc rangées par palier de verdict, jamais par position.

Ce qui s’est dit — Moi : ça pourrait être une page dynamique mise à jour chaque mois ? Claude : oui, et le piège est l’ordre du texte, à découpler de celui des données.

Deux mille cinq cents posts analysés sur deux plateformes pour moins de deux dollars

Bilan du pipeline : posts analysés, coût du passage, sources hors liste identifiées
Ce qui est fait, ce qui reste.

Le coût total du passage : 1,665 $. Dans le détail, 0,006 $ pour résoudre les comptes, 0,297 $ pour les 1 980 posts X, 0,002 $ pour vérifier les comptes dormants, 0,180 $ pour le test LinkedIn, 1,068 $ pour les 534 posts LinkedIn, et 0,112 $ pour les abonnés. Mesuré le 12 octobre 2026.

Ce que ça produit : un classement par citations sur X, des scores d’engagement sur les deux plateformes, et surtout onze sources hors liste que les listes d’experts ne donnent jamais. Repérer une source avant qu’elle soit sur les listes, c’est exactement le différenciateur d’un service de veille.

Ce qui s’est dit — Moi : à terme, cette page pourra renvoyer vers mon service de veille d’influenceurs. Claude : c’est exactement le différenciateur.

Ce qu'il faut retenir

  • Une liste d’experts n’est pas une mesure. Les citations croisées réelles disent qui produit l’information, et la réponse peut être hors de la liste.
  • Un paramètre dérivé automatiquement est plus dangereux qu’une constante en dur quand il est faux mais plausible : il déplace tout en silence. Chaque dérivation mérite un test de validité.
  • Le graphe de citations ne se transpose pas d’une plateforme à l’autre. X est une clique, LinkedIn un réseau ouvert : mesurez chaque plateforme pour ce qu’elle sait dire.
  • « Qui on lit » n’est pas « qui on observe ». Les comptes les moins intéressants à suivre sont souvent les meilleurs capteurs de sources neuves.

Questions fréquentes

Pourquoi ne pas simplement compter les mentions ?

Parce qu’une réponse sur X insère le nom de l’interlocuteur automatiquement. Compter toutes les mentions revient à mesurer qui discute avec qui, pas qui cite qui.

Pourquoi deux classements au lieu d'un score unique ?

Parce que les deux plateformes ne mesurent pas la même chose. Sur X, le graphe de citations est dense et séparant. Sur LinkedIn, il est trop clairsemé pour classer, mais l’engagement y est riche. Additionner les deux aurait fabriqué un chiffre sans signification.

Combien ça coûte de refaire la mesure ?

1,665 $ par passage pour 28 personnes sur deux plateformes, données d’octobre 2026. Les posts sont achetés à l’unité auprès de scrapers du Store Apify.

Peut-on appliquer ça à une autre liste, dans un autre secteur ?

Oui, c’est précisément pour ça qu’aucun paramètre n’est écrit en dur : seuils et quantiles se recalculent sur le corpus du mois.

Est-ce que ça remplace le jugement éditorial ?

Non. La mesure dit qui est relayé et qui publie de l’actualité. Décider qui mérite votre attention reste votre affaire, avec de meilleures cartes en main.

Et maintenant ?

La mesure est faite, la page de veille existe en brouillon, et il reste à câbler l’automatisation mensuelle qui remplacera les sept zones. Cet article suivra : à chaque étape franchie, une ligne datée en tête dira ce qui a changé.

La chaîne de l'outil Clustering concurrentiel : pages des concurrents, résultats Google et réponses IA, jusqu'à une topical map priorisée, un pilier entouré de ses sous-sujets et de leurs titres H2.

Clustering concurrentiel : la topical map que dessinent Google et ses réponses IA

En bref

  • Clustering concurrentiel est un outil d’analyse concurrentielle SEO et GEO, en ligne sur creapulse.fr : il construit votre topical map (piliers, sous-sujets, angle et plan H2) à partir de vos vrais concurrents.
  • Les requêtes sont regroupées par recoupement des résultats Google : deux requêtes vont ensemble quand leur top 10 partage au moins 4 pages. Pas par ressemblance des mots.
  • Les sous-sujets et leurs H2 sont tirés des sections des réponses IA de Google (AI Overview, AI Mode).
  • C’est vous qui validez vos concurrents : sur un site de niche, 799 recherches Google ne donnaient que 9 piliers tant que des généralistes faussaient l’analyse.
  • Une analyse dure 10 à 15 minutes, et 2 crédits sont offerts à l’inscription.

Clustering concurrentiel est le nouvel outil de creapulse.fr. Vous donnez l’adresse de votre site ; il lit les meilleures pages de vos concurrents, demande à Google quelles requêtes relèvent d’une même page, puis laisse ses réponses IA dessiner les sous-sujets et leur plan. Ce que vous récupérez, c’est une topical map : la carte des pages à écrire, classées par priorité.

Pour faire simple, je voulais un outil qui dise quoi écrire, pas un export de mots-clés de plus à trier dans Excel. Il m’a fallu six semaines d’essais pour y arriver, avec des méthodes gardées et beaucoup de méthodes jetées. Je vous raconte ici les deux, parce que c’est dans ce qui n’a pas marché qu’on comprend pourquoi le reste marche.

De vos concurrents à la topical mapLa chaîne de l’outil Clustering concurrentiel : les pages des concurrents, les résultats Google et les réponses IA aboutissent à une topical map priorisée, dessinée comme un topic cluster : un pilier, ses sous-sujets et leurs titres H2.DE VOS CONCURRENTS À LA TOPICAL MAPPages desconcurrentsRésultatsGoogleRéponses IAPilierTOPIC CLUSTERsous-sujettitre H2Topical map priorisée
La chaîne de l’outil : les pages de vos concurrents, les résultats Google et les réponses IA aboutissent à une topical map priorisée, faite de piliers entourés de leurs sous-sujets et de leurs titres H2.

Le vrai livrable n'est pas un groupe de mots-clés, mais la page à créer ou à optimiser

Trois décisions possibles pour un groupe de requêtes : créer une page, optimiser l'existante ou consolider des pages qui se concurrencent

Le projet est parti de là où partent la plupart des SEO : les requêtes Search Console d’un site, regroupées par thème. Sauf qu’un groupe de mots-clés, tout seul, ne sert à rien. Ce qui compte, c’est la décision qui va avec : créer une page parce qu’aucune ne couvre le sujet, enrichir celle qui existe, ou fusionner deux pages qui se marchent dessus (la fameuse cannibalisation).

Chaque groupe croise donc ses requêtes avec les pages du site, et reçoit une action et une priorité. Premier enseignement au passage : un premier méta-regroupement, qui rassemblait les groupes par similarité, rangeait « crawl seo » sous « migration seo ». Faux rattachement, abandonné. Règle retenue : un groupe, un pilier.

Moi : Je veux une décision par groupe : créer, optimiser ou consolider, avec l’URL concernée.
Claude : Chaque groupe croise ses requêtes avec les pages du site et reçoit une action et une priorité.

Ce qui s'est dit, en résumé

Pour trouver ce qui manque à un site, mieux vaut lire les pages de ses concurrents

Comparaison entre l'écart de mots-clés classique, bruité, et la lecture des pages concurrentes, qui fait ressortir des sujets éditoriaux réels

Chercher ce que le site ne couvre pas, c’est l’étape suivante. La méthode classique, c’est l’écart de mots-clés : on prend les mots-clés des concurrents, on retire ceux du site, et on regarde ce qui reste. En pratique, ce qui restait, c’était du bruit : des requêtes virales sans rapport, des micro-sites hors sujet. Et le peu qui tenait debout recoupait les piliers qu’on avait déjà.

Alors on a changé d’angle : lire les meilleures pages éditoriales des concurrents, une par une, et en extraire les une à trois requêtes qu’un internaute taperait vraiment pour tomber dessus. Là, on voit apparaître de vrais sujets éditoriaux. C’est à ce moment-là que l’outil « clustering concurrentiel » est né. (Si le sujet des idées de contenu vous intéresse plus largement, j’en parlais déjà dans mon guide des outils pour trouver des idées de contenu.)

Moi : Et si on lisait directement les meilleures pages des concurrents pour en tirer les sujets ?
Claude : Chaque page lue donne une à trois requêtes réelles ; l’écart de mots-clés classique est abandonné.

Ce qui s'est dit, en résumé

Regrouper par le sens des mots crée des fourre-tout ; seul Google sait ce qui va ensemble

Les méthodes testées pour regrouper les requêtes : LLM, embeddings, hybride, et recoupement des résultats Google, seule méthode retenue

Une fois les requêtes en main, il faut les regrouper, et chaque groupe doit correspondre à une seule page à écrire. J’ai mis plusieurs méthodes sur le banc d’essai, avec les mêmes requêtes : regroupement par un LLM, par embeddings (une représentation mathématique du sens des mots), par texte enrichi, découpage par LLM, et un hybride embeddings + résultats Google.

Verdict : toutes les méthodes qui regroupent « par le sens » produisent des méga-groupes fourre-tout. Un réglage de sensibilité faisait même tout basculer d’un coup en un seul groupe. Et l’hybride, loin d’additionner les qualités, se dégradait. La seule méthode qui capte l’intention de recherche, c’est le recoupement des résultats Google. Et c’est assez logique quand on y pense : c’est Google lui-même qui dit quelles requêtes une même page peut satisfaire, puisqu’il leur montre les mêmes pages.

Moi : Quelle méthode regroupe vraiment les requêtes qu’une seule page peut satisfaire ?
Claude : Le recoupement des résultats Google : les autres méthodes fusionnent des intentions différentes.

Ce qui s'est dit, en résumé

Deux requêtes vont ensemble quand Google leur montre au moins quatre pages communes

Deux requêtes dont les top 10 Google partagent au moins 4 URL forment un même pilier, validé par au moins 2 concurrents

Concrètement, l’outil compare le top 10 Google de chaque requête. À partir de quatre URL communes, une même page peut satisfaire les deux requêtes : elles rejoignent le même pilier. Le seuil était à trois au départ ; il est passé à quatre après une fusion abusive repérée à la relecture. Un point de plus, et deux sujets distincts cessaient de se coller.

Deuxième garde-fou, le consensus : un pilier n’est gardé que si au moins deux concurrents distincts le travaillent. Un sujet que personne ne traite n’est pas une opportunité prouvée, c’est un pari. Même logique entre pilier et sous-sujet : on les considère en doublon dès qu’ils partagent au moins 2 URL dans le top 5, ou 3 dans le top 10 (un seuil calibré sur de vraies SERP françaises, pas au doigt mouillé).

Moi : Comment l’outil décide-t-il que deux requêtes différentes appartiennent au même pilier ?
Claude : Quatre URL communes dans le top 10, et au moins deux concurrents distincts qui couvrent le sujet.

Ce qui s'est dit, en résumé

Les sections des réponses IA de Google révèlent les sous-intentions d'un sujet

Du pilier aux sous-sujets : les réponses IA de Google sont lues section par section pour en tirer 3 sous-sujets dignes d'un article

Un pilier, c’est une page de fond. Mais autour, il faut des sous-sujets qui méritent chacun leur page. Les suggestions génériques (les « autres questions posées », les recherches associées) donnaient des sous-sujets trop plats. L’idée qui a tout changé : interroger chaque pilier dans les réponses IA de Google, l’AI Overview (la réponse générée en haut des résultats) et l’AI Mode, avec 2 à 4 formulations.

Leurs sections montrent comment Google découpe un sujet, autrement dit les sous-intentions qu’il y associe. Un LLM les regroupe ensuite en trois sous-sujets maximum, avec un test simple : un rédacteur écrirait-il un article complet dessus ? Au départ, l’outil en proposait cinq, trop pointus, au niveau d’un simple H2. Sur un run de contrôle, une réponse IA a été trouvée pour 17 piliers sur 17. C’est là que l’outil devient aussi un outil GEO : vous n’écrivez pas ce qu’un modèle imagine sur votre marché, vous écrivez ce que Google affiche déjà à vos lecteurs.

Moi : Les sections des réponses IA pourraient devenir de nouvelles pages, donc de nouveaux sous-sujets, non ?
Claude : Oui : on les regroupe en trois sous-sujets maximum, chacun assez riche pour un article complet.

Ce qui s'est dit, en résumé

Les sections trop étroites pour une page deviennent le plan H2 d'un sous-sujet

Pilier, sous-sujet et structure : chaque sous-sujet reçoit 3 à 6 titres H2 tirés des réponses IA de Google

Et les sections trop petites pour mériter une page ? Plutôt que de les jeter, on les recycle : elles deviennent les titres H2 du sous-sujet auquel elles se rattachent. Chaque sous-sujet reçoit ainsi 3 à 6 H2, soit un mini-brief lisible d’un coup d’œil.

Dernière règle, et pas la moins importante : anti-cannibalisation. Deux sous-sujets ne doivent jamais pouvoir se positionner sur la même page de résultats. Sinon, vous écrivez deux articles qui se disputent la même place, et aucun des deux ne la prend. Sous-sujets et structure ont été jugés de qualité livrable dès le run du 2 septembre.

Moi : On garde les sections trop petites comme H2 des sous-sujets, pour avoir un brief rapide ?
Claude : Chaque sous-sujet reçoit 3 à 6 titres H2, et deux sous-sujets ne visent jamais la même SERP.

Ce qui s'est dit, en résumé

Deux concurrents généralistes suffisaient à valider des sujets hors cible, comme le smic

Sur un site de niche : 799 recherches Google, 540 groupes formés, 436 requêtes isolées et seulement 9 piliers utiles

Le vrai test, c’était un cas de niche : le site d’un cabinet d’avocats spécialisé en RGPD. Et là, surprise : 799 recherches Google ne donnaient que 9 piliers. On a disséqué le run : 540 groupes formés, 436 requêtes restées isolées, 258 fusionnées, et au bout, 9 piliers. Pas terrible pour ce que ça coûte en données.

Le coupable, c’était le consensus lui-même. Des concurrents généralistes (portails publics, médias) couvrent tout ; à deux, ils validaient des sujets hors cible comme le smic, les soldes ou le permis. Pendant ce temps, de vrais sujets pointus, couverts par un seul spécialiste, disparaissaient : violation de données, AIPD, article 28. Ce qu’il faut retenir, c’est qu’un consensus ne vaut que si l’on regarde qui le forme.

Moi : Est-ce qu’on exploite vraiment ces 799 recherches, ou est-ce qu’on paie pour rien ?
Claude : Les généralistes faussent le consensus : smic et soldes passent, violation de données et AIPD disparaissent.

Ce qui s'est dit, en résumé

L'outil présélectionne les spécialistes, et le client valide lui-même ses vrais concurrents

Sélection des concurrents : tri par spécialisation, rattrapage des gros sites du thème, puis validation par le client avant l'analyse

Premier correctif : trier les concurrents par spécialisation (la part de leurs mots-clés commune avec le site) plutôt que par taille. Deuxième : rattraper les gros sites du même thème, qui ont peu de recoupement en proportion mais beaucoup de contenu à étudier. Et un filtre de topicalité à trois niveaux (hors sujet, limite, cœur) pour écarter le reste.

Mais le correctif qui a fait la plus grosse différence n’est pas un filtre. C’est l’humain dans la boucle : l’outil présélectionne, et c’est vous qui cochez vos vrais concurrents, avec un minimum de six pour garantir la qualité. Sur le cabinet d’avocats, le portail juridique généraliste classé premier est sorti, au profit de spécialistes RGPD. Après un run à 11 concurrents validés, mon constat tenait en une phrase : les 11 concurrents font la différence. Personne ne connaît mieux votre marché que vous, aucun filtre automatique ne remplace ça.

Moi : On présélectionne, mais c’est le client qui valide ou choisit ses concurrents.
Claude : Présélection par spécialisation, gros sites thématiques rattrapés, puis un écran de validation avant l’analyse.

Ce qui s'est dit, en résumé

Un pilier se nomme d'après son thème central ; son volume sert seulement à prioriser

Citation : une page peut cibler plusieurs expressions, même si elle reste centrée sur un thème principal

Dernier détour, et pas le moins drôle : le code nommait chaque pilier d’après sa requête la plus cherchée. Résultat, un pilier « google lens » sur un site d’agence SEO. Holà. Une page pilier ne cible pas un mot-clé unique, elle cible tout un champ de requêtes.

Le nom du pilier devient donc le centre thématique de son groupe, raccourci en vrai nom de rubrique (« rgpd », « données personnelles », « cnil »), et le volume, cumulé sur toutes les requêtes du pilier, n’est plus qu’une colonne de priorité. C’est la même logique que dans un audit sémantique : on travaille un corpus, pas un mot-clé.

Moi : Qui a dit que le pilier doit cibler le terme le plus demandé ? Une page cible plusieurs expressions.
Claude : Juste : le nom devient le centre thématique du groupe, et le volume une colonne de priorité.

Ce qui s'est dit, en résumé

En quinze minutes : piliers, sous-sujets, angle et plan H2, à partir de vos vrais concurrents

La chaîne de l'outil : pages des concurrents, résultats Google, réponses IA, puis topical map priorisée

Au bout de ces six semaines, le labo est devenu un outil en ligne. Il enchaîne les pages de vos concurrents, les résultats Google et leurs réponses IA, et vous livre une topical map priorisée : les piliers, leurs sous-sujets, l’angle de chacun et son plan H2. Une analyse complète dure 10 à 15 minutes. L’outil fonctionne en crédits (1 crédit couvre 6 concurrents), et 2 crédits sont offerts à l’inscription pour un premier essai.

Ce qu'il faut retenir

  • Pour regrouper des requêtes en pages, demandez à Google : celles qui partagent les mêmes URL dans le top 10 relèvent d’une même page. La ressemblance des mots ne le garantit pas.
  • Pour trouver ce qui manque à un site, lisez les pages de ses concurrents plutôt que de soustraire des listes de mots-clés.
  • Les sections des réponses IA de Google sont une carte des sous-intentions d’un sujet ; celles qui ne méritent pas une page font le plan H2 de celles qui la méritent.
  • Un consensus concurrentiel ne vaut que par ceux qui le forment : laissez l’expert valider ses concurrents, ça améliore plus la sortie que n’importe quel filtre.

Questions fréquentes

C'est quoi, le clustering concurrentiel ?

C’est le regroupement des requêtes sur lesquelles vos concurrents se positionnent, en groupes qui correspondent chacun à une page à écrire. L’outil Clustering concurrentiel de creapulse.fr le fait à partir des pages réelles de vos concurrents, des résultats Google et de ses réponses IA, et livre une topical map priorisée.

Pourquoi regrouper les mots-clés par les résultats Google plutôt que par leur sens ?

Parce que les méthodes par le sens (LLM, embeddings) ont produit des groupes fourre-tout sur le banc d’essai, en fusionnant des intentions différentes. Deux requêtes dont le top 10 Google partage au moins 4 pages peuvent être satisfaites par la même page : c’est Google lui-même qui le dit.

À quoi servent les réponses IA de Google dans l'outil ?

Leurs sections révèlent comment Google découpe un sujet. L’outil en tire jusqu’à trois sous-sujets par pilier, chacun digne d’un article, et recycle les sections trop étroites en titres H2 (3 à 6 par sous-sujet).

Pourquoi dois-je valider mes concurrents moi-même ?

Parce que des concurrents généralistes faussent l’analyse : sur un site de niche, ils validaient des sujets hors cible pendant que de vrais sujets pointus disparaissaient. L’outil présélectionne les spécialistes, vous cochez ceux que vous reconnaissez, six au minimum.

Combien de temps dure une analyse, et combien ça coûte ?

10 à 15 minutes. L’outil fonctionne en crédits : 1 crédit couvre 6 concurrents, et 2 crédits sont offerts à l’inscription pour un premier essai.

Et maintenant ?

L’outil est en ligne, et il va continuer d’évoluer : chaque nouvelle étape viendra compléter cet article, avec la date et ce qui a changé. En attendant, le meilleur moyen de juger, c’est de le lancer sur votre propre site. Et vous, comment construisez-vous votre topical map aujourd’hui : par les mots, ou par les résultats de Google ?

Outil de test de vitesse de chargement d’une page web

J’ai l’honneur d’accueillir Damien Jubeau, le CEO de Dareboost, un outil pour tester la vitesse de chargement et la qualité d’une page web, avec des conseils d’optimisations. Au salon Ecommerce 2014, Dareboost a gagné le premier prix dans la catégorie « Technologie ». Je commence l’article par un test de l’outil, puis par l’interview vidéo de Damien qui a accepté de répondre à quelques questions, et enfin par la transcription de la vidéo en texte, au cas où vous seriez sur mobile et que la page ne se charge pas assez rapidement 🙂

Test de Dareboost

Lancement de l’analyse


  1. On commence par entrer l’adresse de la page à analyser. Pour l’exemple, j’ai pris une page de catégorie du site leguide.com
  2. On peux choisir le navigateur: Firefox, Chrome, ou même le mobile Nexus 5. Ca simule les performances ressenties par un utilisateur sur le navigateur sélectionné.
  3. On peux choisir la résolution de l’écran. Ca peux avoir une influence sur les sites responsive. Par défaut, c’était en 1024 x 768, mais les utilisateurs aujourd’hui utilisent en majorité des résolutions plus élevées, j’ai donc changé cette valeur.
  4. On peux choisir le lieu du test. C’est vraiment bien car c’est un des seuls outils du même type qui permet de choisir le lieu et en plus situé en france.
  5. On peux choisir le débit : 3G, fibre, ADSL
  6. Il y a la possibilité de tester une page protégée par mot de passe (.Htaccess), pratique pour vérifier un site en test.
  7. On peux changer l’user-agent, c’est à dire l’entête HTTP du navigateur utilisé pour charger la page. Pour les sites qui font du cloaking sur google (Pas bien….), on peux mettre l’user-agent de googlebot.
  8. On peux même s’amuser à changer une autre entête. On peux imaginer changer la langue du navigateur, au cas où la page affiche du contenu spécifique en fonction de la langue.

On peut dire que ça commence bien, autant d’options c’est rare même si la plupart du temps on se contentera des valeurs par défaut qui sont suffisantes en général.

Résumé des performances

resume-performance-vitesse

Après l’analyse automatique de la vitesse de chargement de la page, on obtient un rapport des performances et de la qualité de la page :

  • On a un score sur 100, ici de 72, sachant que chaque point de vérification est pondéré en fonction de son importance.
  • Le temps de chargement en secondes, le poids de la page en megaoctets, le nombre de requêtes. Trois gros indicateurs qui permettent de juger de l’effort à faire pour améliorer la vitesse de chargement d’un site.
  • Concernant la validation W3C, ca a peu d’impacts directs sur le SEO mais ça peut avoir des implications sur la compatibilité et l’accessibilité.
  • On a également un aperçu des technologies utilisées. Dans cet exemple, le site utilise  apache, jquery, sitecatalyst d’omniture (pour le suivi analytics) et modernizr (une librairie javascript). D’ailleurs, pour une vue encore plus exhaustive des technos utilisés, je recommande aussi le plugin google chrome BuiltWith Technology Profiler

Résumé des conseils

conseils-vitesse-chargement

C’est sympa de voir tous ces indicateurs, mais ce qui est encore plus sympa c’est d’avoir les conseils pour améliorer la vitesse de son site. Dans cet exemple, les recommandations sont divisées en 11 rubriques (c’est variable) avec plus ou moins de conseils. Il y a même une rubrique sécurité, ce qui est assez rare pour le souligner. Il y a aussi une rubrique spécifique au référencement (SEO) qui vérifie quelques basiques comme la présence de titres H1, de alt sur les images,… Mais une grande partie des autres rubriques concerne aussi le SEO au final.

Sur la rubrique spécifique au référencement naturel, la page perd 8 points car l’url contient des underscore « _ » au lieu de tiret « – » dans l’url. En lisant l’explication, j’étais un peu chagriné car ils expliquent de remplacer l’underscore par le tiret. J’ai prévenu Damien Jubeau  pour lui expliquer que l’effet sur google serait nulle, et que dans tous les cas il faudrait faire une redirection 301. Un système de feedback permet d’alerter le support au cas où la recommandation ne serait pas assez claire. L’explication a été mise à jour.

Détails des temps de chargement

details-temps-de-chargement

En cliquant sur la partie « temps de chargement », on arrive sur une vue détaillée sur les différentes étapes de chargement de la page. Je ne vais pas expliquer chaque élément mais juste m’attarder sur le DOM (Document Object Model). Ce sont  les éléments HTML qui composent une page (TABLE, TR, TD,…). Plus une page est complexe, plus elle a d’éléments DOM, plus la construction de la page est compliquée et plus le temps de chargement est long.

Détails des requêtes

timeline-requetes-web

En cliquant sur le nombre de requêtes, on obtient une vue classique en timeline du chargement des différentes requêtes, comme on peut l’obtenir avec d’autres outils comme pingdom tools ,  firebug ou simplement via la console de son navigateur. C’est toujours intéressant de voir le chargement en parallèle ou pas des requêtes, et voir à quel moment ça bloque.

Principaux axes d’améliorations

axes-ameliorations-chargement

Puis on a accès à l’ensemble des conseils d’optimisations (il faut être connecté). Ils sont très clairs, en français, et classés par priorité. L’outil a même prévu un système de note de la recommandation afin qu’ils puissent améliorer la pertinence de leurs explications si besoin. On peut obtenir certains de ces conseils via des outils comme pagespeed insights , mais ici les explications sont bien plus exhaustives, parfois personnalisées en fonction de la plateforme utilisée sur le site et vont même plus loin que l’analyse du temps de chargement.

Les autres optimisations

optimisations-chargement


Et on la suite des 57 conseils d’optimisations, rien que ça, qui concernent à 80 % l’amélioration des temps de chargement mais aussi comme on l’a vu les critères d’accessibilité, de sécurité ou de qualité. D’ailleurs cette liste s’agrandit régulièrement comme le précise Damien dans la vidéo qui suit.

Conclusion du test

Il y a également une fonction de monitoring qui peut vous alerter lorsque le site dépasse un certain seuil de temps de réponse, renvoie une erreur, passe en dessous un score de qualité défini, et génère dans tous les cas un rapport à intervalle régulier.

Parmi les outils de test de temps de chargement d’une page web, c’est le plus complet que j’ai testé. C’est même plus que ça, c’est presque un outil de contrôle de qualité d’une page web. Presque, car les critères d’évaluation sont nettement plus nombreux et il manque l’aspect humain biensûr pour les critères subjectifs, et même pour interpréter correctement certaines données, trouver des compromis et les solutions optimales. Mais pour un outil qui automatise les recommandations, il est vraiment bien fait.

Pour chipoter, on pourrait dire que la limitation réside principalement dans le fait que l’analyse se résume à l’analyse d’une seule page web (sauf en prestation de service), et c’est vrai pour l’ensemble de ce genre d’outils de toute façon. Si l’outil pouvait ajouter le crawl d’un site entier catégorisé et ajouter une dimension plus macro, ce serait encore plus pertinent. A ma connaissance, aucun outil ne fait ça actuellement, mis à part certains outils de crawl que j’utilise lors de mes audits SEO, mais l’objectif n’est pas le même. Ceci dit, les variations sur la vitesse de chargement sont surtout visibles d’un template à un autre et pas au sein d’un même template de page en général.

Je vous recommande aussi ce dossier pour en savoir plus sur l’optimisation de la vitesse d’un site.

Vidéo Interview de Damien jubeau, CEO de Dareboost

Questions à Damien Jubeau

Peux tu te présenter aux lecteurs de Creapulse, expliquer ton parcours ?

Bonjour Serge,
Je suis passionné par le web depuis de nombreuses années, puisque j’ai mis en ligne mon premier site Internet en 1999, vers l’âge de 10 ans. Trois ans plus tard, j’ai commencé à m’intéresser réellement à la programmation, en débutant le PHP.
Cela m’a amené, une fois la majorité atteinte, a créer une micro-entreprise dédiée à la conception web, et à entamer des études supérieures en informatique.
Mes 3 dernières années d’études ont été mené en alternance, au sein d’un éditeur logiciels spécialisé dans le marketing mobile. J’ai notamment été amené à travailler sur des problématiques de performances web, sur des plate-formes utilisées par des grands comptes (banques, assurances, presse…).

Titulaire d’un diplôme d’ingénieur en Informatique, je me suis lancé fin 2013 dans l’aventure entrepreneuriale, avec 3 autres passionnés et une ambition commune : accélérer le web !

Comment t’es venue l’idée de créer Dareboost ?

DareBoost est le fruit de notre passion, de notre ambition, mais également de nombreuses rencontres. Nous avons notamment remarqué que les a priori sont nombreux quand on parle de temps de chargement. L’hébergeur, la connexion, ou bien le périphérique de l’nternaute sont souvent les sujets les plus pointés du doigt.

Même si ces aspects apportent évidemment leur lot de contraintes, nous aimons à rappeler que les clefs sont bien dans les mains des développeurs front-end, puisque c’est ici que se trouve plus de 80% du temps de chargement ressenti par un internaute ([source EN] http://www.stevesouders.com/blog/2012/02/10/the-performance-golden-rule/).

C’est donc à cet aspect que s’intéresse DareBoost en démocratisant le diagnostic et l’accès aux bonnes pratiques qui vont permettre d’accélérer de façon significative le site web.
Nous avons à coeur de réconcilier les décideurs et les développeurs, en rendant plus accessibles ces sujets techniques, et en facilitant les prises de décisions puisque l’outil est conçu pour cibler les priorités.

Comment Dareboost se différencie par rapport à d’autres outils de performance ?

Plusieurs facteurs à citer à ce niveau. Premièrement, comme expliqué dans ma réponse précédente, nous avons fait le choix de ne pas nous adresser uniquement à un public très technique. Cela se concrétise par des conseils plus détaillés que dans d’autres outils, avec également, tant que possible, un focus donné sur les enjeux.

L’élément de différenciation majeur reste notre capacité de conseil : nous avons dans notre base plus de 150 points de vérifications, et nous continuons à l’enrichir. Nous intégrons des outils reconnus comme le W3C, Google Page Speed, ou encore YSlow. Et nous rajoutons une couche de personnalisation en fonction des technologies que nous détections sur un site analysé. Par exemple, si nous détections que les images ne sont pas optimisées sur un WordPress, nous proposons des plugins pertinents pour ce CMS pour corriger le problème.
Notre outil est automatique, mais nous fournissons du sur-mesure. Et tout ça dans le temps, grâce à nos fonctionnalités de monitoring.

Autre point que nos utilisateurs nous remontent régulièrement : la clarté de notre interface, ce qui rejoint notre volonté de faciliter l’accès à ces sujets techniques, avec notamment un effort pour la représentation graphique des données de nos audits.

Ah oui, j’oubliais : notre solution est disponible en anglais et en français !

Quelles sont pour toi les implications de la vitesse de chargement d’un site sur le référencement et globalement le business d’un site web ?

Les débats sur le sujets sont nombreux, bien que nous n’ayons pas eu le temps encore de mener notre propre étude, nous avons collecté quelques informations à avoir en tête :

  • En avril 2010, Google a introduit la performance web dans son algorithme. A ce point, 1% des sites indexés étaient impactés.
  • A partir de 2010, Google affichait dans Webmaster Tools qu’un site chargé en moins de 1,5 seconde était considéré rapide
  • Il existe une corrélation entre le temps de réponse serveur d’un site web et son rang dans les résultats de recherche sur Google ([source EN] http://moz.com/blog/how-website-speed-actually-impacts-search-ranking)
  • Le temps de chargement de votre site impacte le nombre de page que le Google Bot est capable de crawler dans une période donnée, ce qui impact donc le potentiel de pages indexées (quand on parle de volumes conséquents)
  • Les Google Bots se rapprochent de plus en plus d’un utilisateur lambda ([source EN] http://googlewebmastercentral.blogspot.fr/2014/05/understanding-web-pages-better.html), ce qui devrait logiquement conduire Google à pénaliser de plus en plus les temps de chargements excessifs.

Pour résumer : bien que difficiles à quantifier, les impacts de la performance web sur le référencement ne sont plus contestables.

Et comme vos préoccupations ne se limitent sans doute pas au référencement, mais plus largement au succès de votre business, voici une liste non exhaustive des sujets impactés par le temps de chargement : taux de conversion, panier moyen, taux de rebond, satisfaction des internautes,  revenus publicitaires ou encore coût de l’hébergement… (source : http://www.webmarketing-com.com/2014/07/09/28900-performance-web-etre-priorite-10-donnees-marquantes).

Conclusion : ne pas se préoccuper du temps de chargement de son site est une erreur qui peut s’avérer coûteuse.

Quelles sont les prochaines améliorations prévues pour Dareboost ?

Elles sont très nombreuses, et difficiles à lister ici puisque nous travaillons en lien étroit avec nos utilisateurs, pour centrer nos efforts sur les priorités immédiates de nos clients (nous faisons une mise à jour de l’outil chaque semaine), même si cela ne nous empêche pas non plus d’avoir des chantiers à plus long terme.

Nous veillons régulièrement à enrichir notre base de connaissance et à renforcer la qualité de nos conseils.
Un exemple de fonctionnalité qui va arriver très rapidement : une API, qui va permettre de nouveaux usages de notre solution, et notamment une intégration sur vos CMS favoris !

Combien coûte Dareboost et à qui ça s’adresse ?

Nous avons fait nos preuves sur des publics variés, de l’agence web au petit e-commerçant, de l’institutionnel aux décideurs marketing de grands groupes.

Nos tableaux de bord permettent aux décideurs d’avoir une vision claire de l’état des lieux technique, mais également de mieux estimer le ROI des chantiers envisagés.

Notre outillage complet et la richesse de nos diagnostics permettent aux métiers techniques de gagner en productivité, et de monter en compétence sur des technologies qui ne sont pas au coeur de leur savoir-faire.

Enfin, pour les projets de moindre envergure, la qualité de nos conseils permet à nombre de nos utilisateurs de gagner en autonomie et de procéder à des optimisations importantes, même sans compétence technique.

Nous proposons 3 offres en standard, respectivement à 19€, 99€ et 499€/mois, sans engagement.

Outil pour monitorer les performances

Voyons voir une sélection d’outils pour vous aider à optimiser le temps de chargement de vos pages.

Et avant, rappelons l’importance d’avoir une page rapide:

  • Plus un site est crawlé rapidement et plus Googlebot, pour ne parler que de lui, verra de pages. La fréquence de crawl d’une page est un élément essentiel pour que vos pages reçoivent plus de visites.
  • Pour l’expérience utilisateur, une bonne vitesse de chargement permet d’avoir un visiteur content, qui passe plus de temps sur votre site et qui au final a plus de chances de convertir.
  • Ce comportement utilisateur est détecté par google, notamment via son navigateur Chrome.
  • Le score de vitesse d’une page est un élément pris en compte dans les critères de positionnement de google depuis avril 2010.

Si avec tout ça, vous êtes pas convaincu qu’il est temps d’optimiser les performances de votre site !


Outil tout en un

Dareboost

dareboost

Dareboost – exemple sur la Redoute

Je commence par le plus complet, Dareboost vous donne le temps de chargement de la page analysée, des conseils, une note, des détails sur les requêtes chargées. Et contrairement a beaucoup d’autres outils du même genre, les rapports sont en français et les tests sont effectuées depuis des serveurs en France, ce qui ne gâche rien.

Dareboost propose également une solution de surveillance des performances de vos pages, mais dans sa version gratuite elle reste moins complète que les autres outils de cette sélection.

Yellow Lab Tools

Yellow Lab Tools, un autre analyseur de performance qui a l’avantage d’être totalement gratuit et open source. J’aime beaucoup le côté synthétique et efficace de l’outil. En plus, comme pour dareboost, c’est un petit français qui est derrière.

Outils pour tester le chargement des pages

Pingdom tools

pingdom tools

Pingdom tools – test sur www.allocine.fr

Avec Pingdom Tools, vous choisissez le lieu d’où part le test, rentrez votre url et il vous donne le temps de chargement de la page, des recommandations d’optimisations, un historique des différentes analyses, les éventuels erreurs et redirections rencontrées, etc…

J’aime bien cet outil car il est rapide, user friendly, et pas besoin de trop attendre comme d’autres outils de test de chargement.


GTmetrix

gt metrix

Gt metrix – test sur www.gentside.com

GTmetrix ne propose pas de choisir le lieu du test malheureusement dans sa version gratuite, mais il a une interface très sobre et surtout on peux comparer les performances de plusieurs pages entre elles, ce que ne fait pas Pingdom tools ou Dareboost.
On retrouve aussi l’analyse de pagespeed et de yslow, il est vraiment bien cet outil de perf.


Webwait

Webwait

Webwait – test sur news-de-stars.com

Webwait donne uniquement le temps de chargement de la page mais il a la particularité de lancer plusieurs jeux de tests à quelques secondes d’intervalles, puis d’en faire une moyenne. Ce qui le rend surement un peu plus précis que d’autres outils.

Page load time

extension page load time

Extension chrome: Page load time

Cette fois, c’est un un plugin chrome qui va tester le chargement de la page sur laquelle vous naviguez.  Il est très précis puisqu’il utilise l’API Web Timing. Lorsqu’on clique sur le chronomètre, on a même un petit tableau de ce qui est chargé par groupe d’éléments. Pratique pour avoir toujours en vue la rapidité des pages que vous visitez.


Outils d’analyse et de conseils d’optimisations

Yahoo slow

Yahoo slow

yahoo slow – type te nombre de requetes

Proposé en plugin navigateur, « Yslow » analyse votre URL et donne des pistes d’amélioration par ordre de priorité. Une note de performances est donnée au terme de l’analyse, histoire de voir où on se situe.


Pagespeed Plugin

page speed

pagespeed – les entetes d’expirations

Il analyse votre page puis vous donne une liste de conseils basés sur des bonnes pratiques. Il donne aussi un score qui peux servir de repère lorsqu’on on optimise une page.


Pagespeed insights

pagespeed insights

pagespeed insights – exemple sur la fnac – pas super

C’est Pagespeed mais en ligne, pas besoin d’installer quoi que ce soit, vous rentrez votre URL et vous aurez le même type de résultats qu’avec l’extension pagespeed.


Outils d’alerte et de monitoring serveur

Woozweb

woozweb

Woozweb – lesnumeriques

Service gratuit de SMILE, une fois que vous rentrez votre site dans leur système, leurs serveurs va régulièrement tester la disponibilité de votre serveur web avec un joli graphe à l’appui.
Autre point important, il vous alerte si votre site ne répond plus


Uptimerobot

Ce site gratuit surveille toutes les 5mn  jusqu’ à 50 sites internet, ce qui est largement suffisant. il a également un système d’alerte en cas de panne de votre site.


Pingdom

Pingdom, une référence et un gage de sérieux, possède aussi un outil de surveillance de l’état de votre serveur vraiment bien fait. Il est gratuit pour un seul site, et payant pour plusieurs sites avec en plus quelques fonctions supplémentaires. A tester donc.


Pour aller plus loin, je vous conseille d’aller voir notre guide seo sur les performances