Quels bots IA autoriser dans votre robots.txt pour être cité ?
En bref
- Chaque éditeur d’IA envoie plusieurs robots : un bot pour entraîner ses modèles, un pour son moteur de recherche, un pour lire une page quand un utilisateur pose une question.
- Bloquer le robot d’entraînement (GPTBot, ClaudeBot) ne vous retire pas des citations IA, mais limite les futures mentions. Bloquer le bot de recherche (OAI-SearchBot, Claude-SearchBot, PerplexityBot), bloque les citations en revanche. (Citations = reprise de votre site comme source avec un lien / Mentions: votre marque est nommée dans la réponse IA, mais sans lien)
- Chez Google, Google-Extended ne touche pas aux AI Overviews : les AI Overviews passent par Googlebot, comme le reste de la recherche Google.
- Trois politiques de robots.txt pour les bots IA : tout ouvrir pour être cité, refuser seulement l’entraînement, ou ouvrir la recherche IA rubrique par rubrique, comme Le Figaro.
- Le robots.txt n’est qu’une consigne. Un pare-feu ou un CDN peut refuser un robot que le fichier autorise, et un assistant IA peut passer malgré un refus provenant du robots.txt.
Quels robots d’IA autoriser sur votre site, et lesquels bloquer ? Tout dépend de ce que vous voulez : être cité par ChatGPT, Claude ou Perplexity, protéger votre contenu, ou un peu des deux. Ce guide passe en revue les robots de chaque éditeur, avec leurs documentations officielles et des robots.txt réels.
Je me suis penché sur le sujet en développant un outil qui teste si les robots IA peuvent lire vos pages. Et la question qui revient c’est pas uniquement « comment être cité ? » mais aussi « est-ce que je bloque les IA ? ». Je vais tenter d’y répondre sans dogme, parce que bloquer « les IA » en bloc, c’est souvent jeter les citations avec l’entraînement.
C’est quoi, un bot IA ?
Un bot IA (ou robot, ou crawler), c’est un programme qui visite les pages web pour le compte d’une entreprise d’intelligence artificielle. Le robot se présente avec un nom, le user-agent, et c’est ce nom que vous visez dans votre robots.txt, le petit fichier placé à la racine du site qui dit aux robots où ils ont le droit d’aller.
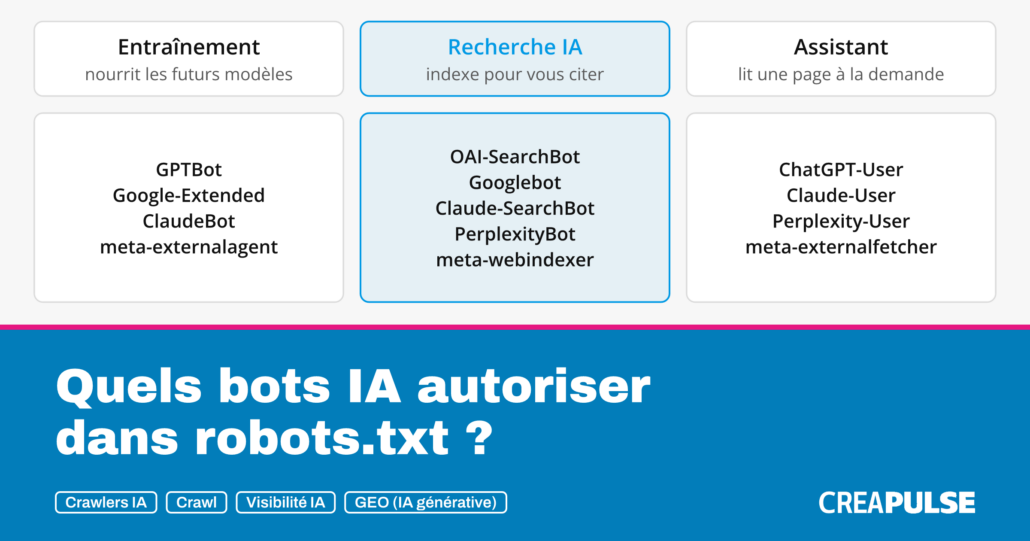
Jusque-là, rien de neuf : Googlebot fait ça depuis plus de vingt ans. Ce qui change avec l’IA, c’est que le même éditeur envoie plusieurs robots qui ne font pas du tout la même chose de votre page. On distingue trois familles de bots IA :
| Famille | Ce qu’elle fait de votre page | Exemples | Si vous la bloquez |
|---|---|---|---|
| Entraînement | L’intègre aux données qui entraînent les futurs modèles | GPTBot, ClaudeBot, Google-Extended, Applebot-Extended, meta-externalagent, CCBot | Votre contenu sort des futurs entraînements. Vos citations ne bougent pas. |
| Recherche IA | L’indexe pour pouvoir la citer dans les réponses | OAI-SearchBot, Claude-SearchBot, PerplexityBot, meta-webindexer | Vous disparaissez des réponses de ce moteur IA. |
| Assistant | Vient la lire quand un utilisateur pose une question | ChatGPT-User, Claude-User, Perplexity-User, meta-externalfetcher | L’IA ne peut plus lire votre page à la demande, si le robot respecte la consigne. |
Ce qu’il faut retenir, c’est que la question « je bloque les IA ou pas ? » est mal posée. La vraie question, c’est : je bloque quelle famille de robots ?
Bots OpenAI : lesquels autoriser dans robots.txt ?
OpenAI documente quatre robots sur sa page dédiée aux crawlers :
- OAI-SearchBot : C’est le robot de la recherche ChatGPT. OAI-SearchBot fait apparaître votre site dans les réponses de ChatGPT qui s’appuient sur une recherche web.
- GPTBot : GPTBot collecte du contenu qui peut servir à entraîner les modèles d’OpenAI.
- ChatGPT-User : ChatGPT-User visite une page quand un utilisateur de ChatGPT le demande. OpenAI précise que ce robot ne sert pas à explorer le web de façon automatique.
- OAI-AdsBot : OAI-AdsBot ne visite que les pages soumises comme publicités dans ChatGPT, pour en vérifier la sécurité.
Le point important, c’est qu’OpenAI déclare ces réglages indépendants les uns des autres. Vous pouvez donc autoriser OAI-SearchBot et interdire GPTBot : c’est même le scénario qu’OpenAI décrit sur sa page de doc.
La doc d’OpenAI donne aussi deux détails pratiques. Un changement de robots.txt met environ 24 heures à être pris en compte par la recherche ChatGPT. Et pour ChatGPT-User, OpenAI précise que l’action venant d’un utilisateur, les règles du robots.txt peuvent ne pas s’appliquer.
Bloquer GPTBot vous protège-t-il vraiment ?
Oui, mais seulement de ce que fait GPTBot, c’est à dire l’entraînement. Interdire GPTbot indique que votre contenu ne doit pas servir à entraîner les modèles d’OpenAI. Ce refus ne vous retire pas des réponses de ChatGPT, qui passent par OAI-SearchBot.
À l’inverse, si vous bloquez OAI-SearchBot, OpenAI est clair : votre site n’apparaît plus dans les sources de la recherche ChatGPT, même s’il peut encore figurer comme simple lien de navigation. De plus, votre marque peux continuer à être mentionnée si vous si vous bloquer pas GTPbot , ou meme via d’autres corpus d’entrainement utilisés et qui connaissent votre marque. Et si un utilisateur demande à chatGPT de lire une de vos pages, c’est ChatGPT-User qui y va, et les règles du robots.txt peuvent alors ne pas s’appliquer.
Vous me direz : « une fois que ChatGPT a lu ma page pour la citer, il s’en sert pour s’entraîner, non ? » OpenAI affirme que les deux usages sont séparés, et qu’OpenAI peut simplement mutualiser le passage du robot quand vous autorisez les deux. C’est une déclaration de l’éditeur, pas une preuve, mais c’est la règle écrite.
Bloquer l’entraînement n’est pas sans effet pour autant. Un modèle entraîné sur vos pages peut parler de votre marque ou reprendre votre contenu de mémoire, sans faire de recherche, c’est une mention (une citation c’est un lien vers votre site) . Refuser GPTBot (modele d’entrainement d’openAI), c’est donc renoncer à cette place dans la mémoire des futurs modèles…. du moins par votre propre site car vos contenus peuvent être repris ailleurs. Les modèles IA utilisent plusieurs corpus d’entrainement (ex: Common Crawl > CCBot), pas uniquement ce qu’il recupere via son bot d’entrainement, donc même en bloquant GPTbot, vos contenus peuvent être dans la mémoire du modèle si vous bloquer pas CCBot.
Bloquer GPTBot, c’est un choix sur l’entraînement et sur les mentions de demain. Pas sur vos citations.
Bots IA de Google et Google-Extended
Chez Google se cache le piège le plus courant. Beaucoup de sites ajoutent Google-Extended à leur robots.txt en pensant sortir des réponses IA de Google. C’est pas ce que fait Google-Extended.
D’après la liste officielle des robots de Google, Google-Extended contrôle deux usages de votre contenu :
- l’utilisation de votre contenu pour entraîner les futurs modèles Gemini ;
- son utilisation pour le grounding, c’est-à-dire quand Gemini (l’application, et l’API Vertex AI) va chercher du contenu dans l’index de Google Search (le même index que les résultats organiques) au moment de répondre.
Google précise que Google-Extended n’a aucun effet sur votre présence dans Google Search, ni sur votre classement. Google-Extended n’est d’ailleurs même pas un robot : il n’a pas de user-agent à lui, c’est un simple jeton de consigne. Le crawl reste fait par les bots habituels de Google (Googlebot).
Google annonce aussi, sur sa liste de robots, vouloir prendre en charge début 2027 un signal standard de préférence sur l’entraînement (__usage_ai-training). A suivre….
Googlebot et AI Overviews : quel robot décide ?
Les AI Overviews et l’AI Mode n’ont pas de robot dédié. La documentation de Google sur les fonctionnalités IA l’explique : l’IA est intégrée à la recherche, donc c’est Googlebot qui fait le travail. Pour apparaître dans une AI Overview, une page doit simplement être indexée et pouvoir s’afficher dans Google avec un extrait (un snippet).
Pour limiter ce que Google montre de vos pages dans les AI Overviews, les seuls leviers sont ceux de la recherche classique, et chacun agit aussi sur vos résultats organiques, via ces balises:
noindexretire la page de Google, AI Overviews comprisesnosnippetgarde la page dans l’index, mais Google n’affiche plus aucun extrait : ni dans les AI Overviews, ni dans les résultats organiques, il reste alors que le titre et l’adresse de la page, pas la petite description, qu’on appelle aussi snippet, sous le lien bleu.data-nosnippetexclut seulement le passage balisé. C’est un attribut qu’on opeux ajouter pour exclure uniquement un paragraphe par exemple et qu’on peut placer à l’intérieur d’un div ou d’un span par exemple.max-snippetplafonne la longueur de l’extrait, partout dans Google.
Autant dire que vous ne pouvez pas sortir des AI Overviews sans réduire aussi votre visibilité dans Google. Pas besoin de désindexer, mais une page sans extrait attire forcément moins de clics. Pour la plupart des sites, le prix est bien trop élevé.
Ca prouve aussi au passage que les AI overview sont très dépendants de l’index organique de Google. Les fondamentaux du SEO s’appliquent donc: une page explorable, indexable, pertinente mais aussi qui répond aux questions voisines que l’IA se pose pour composer sa réponse, ce qu’on appelle les fanouts.
Bloquer Googlebot pour échapper à l’IA de Google, c’est fermer la boutique pour ne plus voir un client.
Bots Anthropic dans robots.txt : lesquels autoriser ?
Anthropic, le fournisseur IA de Claude, explique de manière claire les conséquences de chaque blocage de leurs bots IA, dans son centre d’aide :
- ClaudeBot récupère du contenu qui peut servir à entraîner ses modèles. Bloquer ClaudeBot signale que vos futurs contenus doivent être exclus des données d’entraînement.
- Claude-SearchBot explore le web pour améliorer les résultats de recherche de Claude, c’est l’équivalent d’un Googlebot qui indexe votre contenu à l’avance. Bloquer Claude-SearchBot empêche l’indexation de votre contenu.
- Claude-User visite une page en direct quand la question d’un utilisateur le demande ou que ce cher Claude juge bon d’aller voir. Bloquer Claude-User empêche Claude d’aller lire votre contenu en direct pour répondre.
Anthropic affirme respecter le robots.txt, et même la directive Crawl-delay (même Google ne tient pas compte de cette directive), qui permet de ralentir les visites de ses robots. Les robots d’Anthropic ne contournent pas non plus les captcha. D’ailleurs attention aux règles de votre WAF (Web Application Firewall), un des rôles de cloudflare par exemple, qui peux afficher un captcha ou une page de challenge à un bot IA qui serait trop insistant.
Anthropic donne aussi un conseil qui mérite d’être souligné : ne pas bloquer ses robots IA par adresse IP. Pourquoi ? Parce qu’un robot bloqué par IP ne peut plus lire votre robots.txt, et donc plus voir vos directives de refus. Pour vérifier qu’une visite sur votre serveur vient vraiment d’anthropic, voici la liste en json de ses adresses IP de leurs bots IA.
Chez Anthropic comme chez OpenAI, la logique est donc la même : ClaudeBot pour l’entraînement, Claude-SearchBot pour être cité.
Bots Perplexity : lesquels autoriser dans robots.txt ?
Perplexity documente deux robots sur sa page dédiée :
- PerplexityBot fait apparaître les sites dans les résultats de Perplexity. Perplexity précise que PerplexityBot ne sert pas à entraîner des modèles, et recommande explicitement de l’autoriser.
- Perplexity-User visite une page quand un utilisateur pose une question.
Perplexity-User demande plus de prudence. Perplexity écrit lui-même que, la demande venant d’un utilisateur, Perplexity-User ignore généralement les règles du robots.txt. Au moins c’est clair !
Le comportement de Perplexity est pas très clair, si on le compare à Claude par exemple. En août 2025, Cloudflare a même publié une enquête accusant Perplexity d’utiliser des robots non déclarés, qui changeaient de nom (user agent) et d’adresses IP après avoir été bloqués, et qui ignoraient parfois le robots.txt. Cloudflare a retiré Perplexity de sa liste de robots vérifiés, et c’est encore confirmé par cet article récent qui reprend Perplexity comme exemple.
L’enquête de Cloudflare illustre bien une chose : un robots.txt, c’est une consigne, pas une serrure. C’est un fichier de règles de politesse mais qui n’oblige personne.
Meta-ExternalAgent : rôle du robot IA de Meta
Meta, la boite de Facebook, et aussi fournisseur de modèles IA, est l’éditeur où les noms de robots prêtent le plus à confusion. La page de Meta sur ses robots en liste cinq, dont quatre qui nous intéressent :
- meta-externalagent explore le web pour entraîner les modèles d’IA de Meta, ou pour améliorer les produits de Meta en indexant directement le contenu. C’est donc le robot à viser si vous refusez l’entraînement chez Meta.
- meta-webindexer sert à la recherche de Meta AI, y compris pour citer et faire des liens vers votre contenu dans les réponses. L’autoriser aide Meta AI à vous citer.
- meta-externalfetcher va chercher un lien à la demande d’un utilisateur. Meta prévient que ce robot peut contourner le robots.txt.
- facebookexternalhit récupère le titre, la description et l’image quand un lien est partagé sur Facebook, Instagram ou Messenger. Ce robot peut lui aussi passer outre le robots.txt. Mais il est pas vraiment lié à l’IA, c’est le bot utilisé pour fabriquer l’aperçu du lien sur ses réseauxs sociaux, à partir des balises Open Graph. Il existait bien avant l’IA de Meta.
Bloquer meta-externalagent, c’est un choix sur l’entraînement. Pour être cité par Meta AI, c’est meta-webindexer qu’il faut autoriser Et ne bloquez surtout pas facebookexternalhit si vos liens sont partagés sur les réseaux de Meta : vous perdriez les aperçus de vos liens sur Facebook ou instagram.
Le robots.txt que je recommande selon votre politique sur les IA
Bon, assez de théorie. Voici trois politiques de robots.txt, de la plus ouverte à la plus fine, avec le fichier qui va avec.
1. Vous voulez être cité : tout ouvrir
C’est le choix que j’ai fait pour creapulse.fr. Le robots.txt de creapulse.fr n’interdit rien à personne :
User-agent: *
Disallow:
Le même jour, j’ai passé creapulse.fr dans notre outil de test des bots IA : les 14 robots testés en réseau (recherche, assistants, entraînement, moteurs classiques) ont reçu la page normalement (réponse HTTP 200), et les deux jetons sans robot propre, Google-Extended et Applebot-Extended, sont autorisés. Le contenu de ce site sert à faire connaître mon expertise et être lu, c’est le but, y compris par les modèles IA.
2. Vous voulez protéger votre contenu sans disparaître : bloquer l’entraînement
Cette politique refuse les robots d’entraînement et laisse passer tous les autres :
# Entraînement : refusé
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: CCBot
Disallow: /

# Tout le reste (dont la recherche IA et Googlebot) : autorisé
User-agent: *
Disallow:
Les robots de recherche et les assistants restent autorisés mais pas les bots IA d’entrainement, donc votre site reste citable. Applebot-Extended suit la même logique que Google-Extended : selon Apple, refuser Applebot-Extended vous sort de l’entraînement des modèles d’Apple, mais vos pages restent trouvables dans Siri, Spotlight et Safari. CCBot quant à lui, c’est le robot de Common Crawl, une archive ouverte du web et un corpus d’entyainement très utilisé pour entraîner les modèles IA.
Attention à un piège classique, posé par la norme du robots.txt (RFC 9309) : un robot suit uniquement le groupe qui porte le nom de son user agent, et ignore alors le groupe User-agent: * , global au site. Si vous avez des interdictions générales (un back-office, des pages de recherche interne…) et que vous créez un groupe pour OAI-SearchBot, il faut recopier les mêmes règles interdictions du groupe général dans le groupe d’OAI-SearchBot, sinon OAI-SearchBot ne les verra plus, il ne lit que les règles de son propre groupe.
Bon, prenons un exemple, car je sens que c’est pas clair:
Voici un exemple de règles du groupe général (User-agent: *) au site, et qui bloque des recherches internes:
User-agent: *
Disallow: /recherche/
Disallow: /actions/
Vous voulez autoriser le dossier /actions/ uniquement pour OAI-SearchBot:
User-agent: *
Disallow: /recherche/
Disallow: /actions/

User-agent: OAI-SearchBot
Allow: /actions/
Dans ce cas, OAI-SearchBot ne voit que les règles de son groupe et ignore les regles globales, et il n’interdit pas le dossier /recherche/
Il faut donc recopier les mêmes règles:
User-agent: *
Disallow: /recherche/
Disallow: /actions/

User-agent: OAI-SearchBot
Allow: /actions/
Disallow: /recherche/
3. Vous voulez choisir section par section : le modèle Le Figaro
C’est le cas le plus intéressant que j’ai relevé. Le robots.txt du Figaro (récupéré le 8 novembre 2026), fait exactement le tri entre les familles de robots :
- Entraînement : GPTBot, ClaudeBot, Google-Extended, CCBot et Amazonbot sont refusés sur tout le site.
- Recherche et assistant d’OpenAI : OAI-SearchBot et ChatGPT-User sont refusés par défaut, sauf sur neuf rubriques : beauté, bons plans, culture, résultats d’élections, horlogerie, joaillerie, mode homme, style et voyages. Je suppose que c’est lié à des affilitations pour la plupart, et donc un intéret commercial.
- Recherche et assistant d’Anthropic : Claude-SearchBot et Claude-User sont refusés par défaut, sauf sur trois rubriques : bons plans, résultats d’élections et voyages.
Le Figaro protège ainsi son contenu éditorial, mais se laisse citer là où une citation lui ramène du trafic utile. C’est une stratégie.
Le robots.txt du Monde, en revanche, raconte une autre histoire. Les trois robots d’Anthropic y sont refusés sur tout le site. Google-Extended aussi, sauf sur cinq rubriques. En revanche, GPTBot, OAI-SearchBot, ChatGPT-User et PerplexityBot n’ont aucune règle à leur nom : seules les interdictions générales du site s’appliquent à eux. Hasard ? 😉 En tout cas, ce qui est sûr c’est que Le Monde a signé un accord avec OpenAI en mars 2024, puis avec Perplexity en mai 2025.
Pour un site comme le vôtre, la leçon est plus simple : décidez famille par famille, en fonction de ce que chaque robot vous rapporte.
Votre serveur est-il d’accord avec votre robots.txt ?
C’est la partie que tout le monde oublie en général. La norme du robots.txt le dit elle-même : ses règles ne sont pas une forme d’autorisation d’accès. Pour faire simple, le robots.txt, c’est le panneau sur la porte ; le pare-feu (ou un WAF), c’est le videur. Et le videur ne lit pas (qui a dit qu’il sait pas lire 😉 ) toujours ce qui est indiqué sur le panneau.
Le robots.txt et le serveur peuvent donc se contredire de deux façons :
- Votre robots.txt autorise un robot, mais votre serveur le refuse. Un pare-feu, un WAF, un CDN ou un hébergeur bloque le robot avant même qu’il arrive à la page. Cloudflare, par exemple, propose de bloquer les robots IA par catégorie (recherche, agents, entraînement) directement sur son réseau, et ses réglages par défaut ont changé. En juillet 2025, Cloudflare annonçait bloquer les robots IA par défaut ; sa documentation, mise à jour le 2 novembre 2026, indique que les nouveaux domaines autorisent les trois catégories. Si votre site est derrière Cloudflare depuis un moment, vérifiez ce qui est réellement coché.
- Votre robots.txt refuse un robot, mais le robot passe quand même. C’est le cas des assistants IA qui, de l’aveu même de leurs fournisseurs, peuvent ignorer les règles : ChatGPT-User, Perplexity-User, meta-externalfetcher.
J’en ai fait l’expérience en phase de développant de l’outil d’audit de visibilité IA. En testant chaque robot sur chaque page d’un même site, notre script a envoyé par erreur environ 290 requêtes en rafale. Le pare-feu du site a fini par répondre 403 (accès refusé) à toutes ces requêtes, y compris à celle qui se présentait comme Googlebot. Le pare-feu jugeait le comportement et l’adresse IP, pas l’e nom l’user-agent du robot. C’est mécanique : un robots.txt parfait ne sert à rien si le videur a déjà fermé la porte.
Ceci dit, ce test reste indicatif derrière un pare-feu : l’outil se présente avec le nom de chaque robot, pas depuis les adresses IP officielles des éditeurs. La seule preuve d’un passage d’un bot IA sur un serveur web, ce sont vos journaux serveur (les logs). Si ça vous intéresse, j’explique comment les lire dans mon article sur l’analyse de logs.
Et vous, vous bloquez qui ?
Si vous ne deviez retenir qu’une chose : bloquer l’entraînement et bloquer la recherche, ce sont deux décisions différentes. La première limite les mentions de demain, la seconde coupe les citations.
Et si on les bloque pas, on autorise pas défaut les bots IA. Le robots.txt fonctionne pas règles d’interdiction, les règles d’autorisation sont des exceptions pour ouvrir un chemin dans une zone fermée, uniquement pour bypasser des regles qui interdisent avant.
Et la plupart des éditeurs d’IA vous laissent les prendre séparément. GPTBot, ClaudeBot, Google-Extended et meta-externalagent jouent sur l’entraînement ; OAI-SearchBot, Claude-SearchBot, PerplexityBot et meta-webindexer jouent sur votre visibilité dans les réponses des IA. Et chez Google, les AI Overviews suivent Googlebot, point.
Une fois votre politique choisie, vérifiez que votre serveur applique bien ce que vous avez décidé. C’est souvent là que ça coince, sans que personne ne s’en rende compte.
Et vous, vous avez déjà bloqué des robots IA sur votre site ? Lesquels, et pourquoi ?

Consultant SEO / GEO spécialisé en audits SEO avancés, stratégie de contenu automatisé et optimisé (avec relecture humaine), création d’outils sur mesures, analyse des brevets et algorithmes Google liés au SEO et à la recherche générative et domaines impactant le SEO: UX, social media, autorité de la marque, …


Laisser un commentaire
Rejoindre la discussion?N’hésitez pas à contribuer !