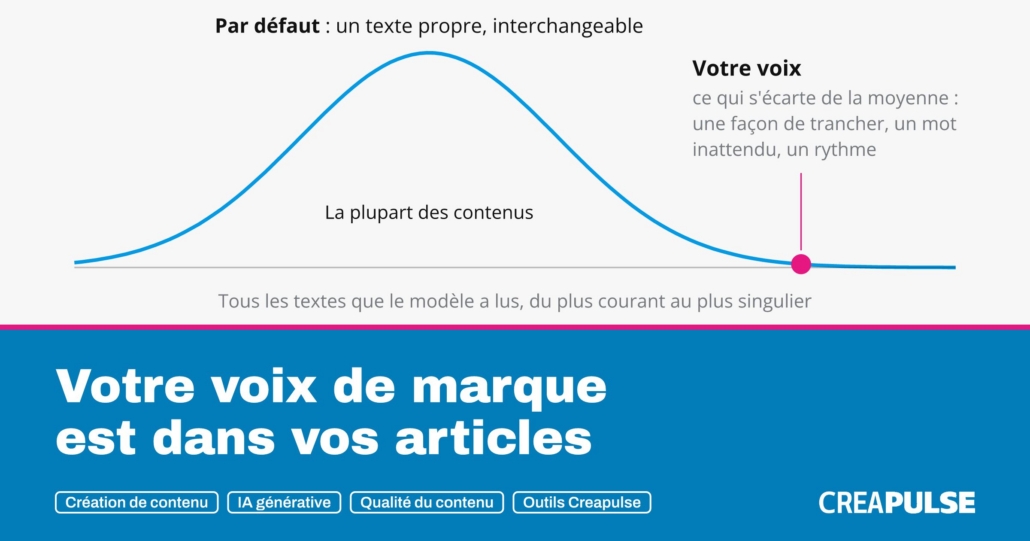
Schéma : sur la courbe de tous les textes qu’un modèle a lus, le texte par défaut est au sommet, la voix de l’auteur se distingue loin de la moyenne.

En bref

  • Votre voix de marque n’est pas à inventer : elle se lit dans vos articles publiés, sous forme de régularités qu’on peut compter.
  • Un brief de ton décrit n’importe qui, et peut même être faux sur vous : mes phrases font 23 mots en médiane, alors que mes textes paraissent faits de phrases courtes.
  • Chaque trait a une fréquence. Donné sans sa dose, un trait est sur-appliqué par l’IA et devient un tic.
  • L’IA repère les traits, elle n’estime pas leur densité : le modèle qualifie, le code quantifie.
  • La méthode tient en quatre étapes : trois à cinq textes représentatifs, lus en entier, distillés par axe avec des citations, puis comptés.

Une voix de marque, c’est la façon dont une marque sonne quand elle écrit : ses tournures, son rythme, ses mots, et ce qu’elle refuse d’écrire. Avec l’IA qui rédige une part croissante des contenus, c’est la première chose qu’on perd, et la plus difficile à décrire dans un prompt. La bonne nouvelle, c’est que vous n’avez pas à l’inventer : elle existe déjà, noir sur blanc, dans ce que vous avez publié.

Je m’en suis rendu compte en construisant le guide de voix qu’utilisent mes outils de rédaction IA. Un guide tiré de mes propres articles, avec des citations à l’appui. Tout y était juste, et pourtant les textes produits forçaient le trait.

Alors j’ai fait ce que je fais sur un site quand quelque chose cloche : j’ai mesuré. J’ai passé mes 18 articles publiés, un peu plus de 50 000 mots, dans des scripts de comptage, et j’ai regardé ce qui revenait vraiment.

Dans cet article, je vous montre ce que ça donne avec mes vrais chiffres, pas avec un cas d’école, puis comment refaire l’exercice sur vos propres textes. Le sujet est plus technique qu’il n’en a l’air, mais je vais rester au plus près du concret.

Pourquoi vos contenus IA se ressemblent

La moyenne n’a la voix de personneSchéma de principe, sans échelle. Une courbe en cloche représente tous les textes qu’un modèle a lus. À son sommet, là où se trouvent la plupart des contenus, le texte que le modèle écrit par défaut : propre, interchangeable. Loin dans la queue de la courbe, la voix de l’auteur, ce qui s’écarte de la moyenne : une façon de trancher, un mot inattendu, un rythme.La moyenne n’a la voix de personneCe qu’un modèle écrit sans indication, et ce qui se remarquePar défaut : un texte propre, interchangeableLa plupart des contenusVotre voixce qui s’écarte de la moyenne :une façon de trancher, un motinattendu, un rythmeTous les textes que le modèle a lus, du plus courant au plus singulierSchéma de principe, sans échelle.

Demandez à n’importe quel modèle d’écrire un article sur votre sujet : il vous rendra un texte propre, structuré, sans faute. Et parfaitement interchangeable. Ce n’est pas un défaut du modèle, c’est sa nature : sans autre indication, il écrit comme la moyenne des textes qu’il a lus, et la moyenne n’a la voix de personne.

Le problème, c’est que votre lecteur lit lui aussi la moyenne, toute la journée. Ce qui le fait rester sur une page, revenir sur un site ou reconnaître un auteur dans son fil d’actualité, c’est précisément ce qui s’en écarte : une façon de trancher, un mot qu’on n’attendait pas, un rythme. Un contenu sans voix n’est pas mauvais, il est oubliable.

L’enjeu dépasse d’ailleurs le confort de lecture. Dès que vous publiez beaucoup, avec plusieurs outils ou plusieurs rédacteurs, la voix devient ce qui relie vos contenus entre eux. C’est elle qui fait qu’on reconnaît la marque d’un texte à l’autre. Sans elle, chaque contenu vit sa vie, et votre site finit par ressembler à une collection de textes signés par personne.

Vous me direz : il suffit d’indiquer à l’IA quel ton employer. C’est justement là que ça coince.

Un brief de ton ne décrit rien

La plupart des briefs de ton se ressemblent : « professionnel mais accessible », « expert et chaleureux », « un style vivant, des phrases percutantes ». Relisez-les en pensant à trois marques concurrentes de votre secteur : ils leur vont à toutes les trois. C’est le problème du portrait-robot. « Taille moyenne, cheveux bruns », ça décrit la moitié de la rue.

Plus gênant, un brief de ton peut être faux sur vous-même. On décrit sa voix d’après l’impression qu’elle laisse, et l’impression trompe. Voici ce qu’un brief aurait pu dire de mes articles, face à ce qu’ils contiennent réellement.

Ce que dirait un brief de tonCe que disent mes 18 articles
« Un ton proche du lecteur »245 « vous » et pas un seul « tu » : proche, mais vouvoyé
« Des phrases courtes et percutantes »Une phrase médiane de 23 mots, et une phrase sur cinq qui atteint 35 mots ou plus
« Un ton conversationnel »« c’est pas » 10 fois, contre « ce n’est pas » 26 fois : l’oral reste l’exception
« Un style vivant »Une incise tous les 470 mots, avec « D’ailleurs » loin devant
« Des titres accrocheurs »Des titres de 5 mots en médiane, dont moins d’un sur dix en forme de question

La deuxième ligne est la plus instructive. Mes paragraphes sont courts et mes textes aérés, ce qui laisse une impression de phrases courtes. C’est l’inverse : j’écris surtout des phrases longues qui empilent les précisions, avec de temps en temps une phrase sèche pour asséner.

Seules 3 % de mes phrases font 8 mots ou moins. Ce qui fait mon rythme, ce n’est pas la brièveté, c’est l’alternance. Un brief qui aurait réclamé « des phrases courtes » à une IA lui aurait fait écrire quelqu’un d’autre que moi.

Ma voix, en chiffres

Concrètement, j’ai pris mes 18 articles publiés, sur creapulse.fr et en tribune sur le Journal du Net, dont une tribune parue en 2014. J’en ai retiré le code, les liens et les métadonnées, puis j’ai compté. Pas d’IA pour juger, pas d’impression : des scripts qui comptent des pronoms, des tournures, des longueurs de phrase et des débuts de paragraphe. Tous les chiffres de cet article viennent de ce relevé, fait en octobre 2026.

Ce qui est mesuréSur quoiRésultat
Volume du corpus18 articles50 711 mots
Adresse au lecteur« vous », « votre », « vos »245 occurrences, et 0 « tu »
L’auteur qui parle« je », « j’ »202 occurrences
Le raisonnement partagé« on »367 occurrences, le pronom le plus fréquent
Incises du répertoire13 tournures suivies108 occurrences, une tous les 470 mots
Longueur de phrase1 329 phrases de prose23 mots en médiane, 19 % à 35 mots ou plus
Paragraphes autonomes498 paragraphes de 25 mots et plus409 se comprennent lus seuls, soit 82 %
Titres de section273 titres de niveau 2 à 45 mots en médiane
Marqueur rare« mécanique », « mécaniquement »8 occurrences en tout
Tiret cadratinTout le corpus0

Trois choses sautent aux yeux.

D’abord, c’est le « on » qui domine, avec 367 occurrences. C’est le pronom du raisonnement qu’on déroule ensemble : « on va voir que », « on comprend mieux ». Le « je » intervient pour le terrain, quand je raconte ce que j’ai constaté sur un site client, et le « vous » pour interpeller le lecteur. Trois pronoms, trois fonctions, et c’est leur dosage qui fait le ton, bien plus qu’un adjectif dans un brief.

Ensuite, les traits les plus fiables d’une voix sont souvent des absences. Zéro « tu » en plus de 50 000 mots, zéro tiret cadratin : ce sont des règles sans exception, donc les plus sûres à transmettre. Pourtant, on pense rarement à les écrire, parce qu’on ne remarque pas ce qu’on ne fait jamais.

Les titres, eux, disent le registre mieux qu’un long discours. Les miens font 5 mots en médiane, et ils sonnent souvent comme une phrase qu’on dirait à voix haute : « C’est quoi des logs ? », « Ce qui a changé », « Ce qui ne marche plus ». Pas de titre à rallonge bourré de mots-clés, pas d’énumération : sur 273 titres, deux seulement enchaînent plusieurs sujets.

Enfin, et c’est le point le plus important, chaque trait a une fréquence. Une incise tous les 470 mots, ce n’est pas « des incises » : c’est cinq ou six dans un article de fond, pas une par paragraphe. Huit occurrences de « mécanique » en 18 articles, ce n’est pas un mot fétiche, c’est un marqueur rare, qui fonctionne justement parce qu’il est rare. On y reviendra, parce que c’est exactement là que les IA dérapent.

De quoi une voix est faite

Pour qu’une voix soit utilisable, par une IA ou par un rédacteur qui arrive dans l’équipe, il faut la ranger. J’utilise cinq axes, qui couvrent à peu près tout ce qui fait qu’on reconnaît un auteur. Chacun se mesure à sa façon.

De quoi une voix de marque est faiteCinq axes d’une voix de marque, avec pour chacun ce qui se compte et la valeur relevée sur les 18 articles publiés de Serge Esteves. Ton : 245 vous et aucun tu. Style de phrase : une incise tous les 470 mots. Vocabulaire : mécanique 8 fois. Déroulé : 82 pour cent de paragraphes autonomes. Principes édito : aucun tiret cadratin sur 50 711 mots.De quoi une voix de marque est faiteCinq axes, et ce qui se compte dans chacunAXE ET CE QUI SE COMPTERELEVÉ SUR 18 ARTICLESTonLes pronoms d’adresse245 « vous »et pas un seul « tu »Style de phraseLa fréquence des incises1 incise tous les 470 mots« D’ailleurs » en tête, 36 foisVocabulaireLes marqueurs rares« mécanique » 8 foismoins d’une fois par articleDérouléLes paragraphes qui tiennent seuls82 % autonomes409 paragraphes sur 498Principes éditoCe qui n’apparaît jamais0 tiret cadratinsur 50 711 motsRelevé par script sur les 18 articles publiés, en octobre 2026.
  • Le ton, c’est qui parle, et à qui. Il se lit dans les pronoms, dans le registre (vouvoiement ou tutoiement, oral ou écrit) et dans la façon de prendre position.
  • Le style de phrase, c’est la construction : la longueur, le rythme, les incises, la ponctuation.
  • Le vocabulaire, ce sont les mots qui reviennent parce qu’ils portent le sens (chez moi, « pertinence » apparaît 27 fois, dans 10 articles sur 18), et ceux qui jugent au lieu de décrire, comme du crawl « gaspillé » ou un effet « néfaste ».
  • Le déroulé, c’est la façon d’ouvrir un texte, de l’illustrer et de le conclure. Chez moi, une intro qui pose le contexte et une promesse, des cas concrets, et une conclusion qui se termine sur une question. Il se mesure aussi : 82 % de mes paragraphes se comprennent lus seuls, sans s’appuyer sur celui d’avant.
  • Les principes, enfin, c’est ce qu’on défend et ce qu’on refuse : pas de superlatif creux, pas de promesse miracle. Ils se lisent autant dans ce qui manque que dans ce qui est écrit.

Le répertoire d’incises montre bien ce que le comptage apporte. Ce sont les petites tournures qui servent à alerter, nuancer ou simplifier. J’en ai relevé 13 qui reviennent dans mes textes, et voici leur fréquence réelle :

TournureOccurrences dans 18 articles
« D’ailleurs »36
« En fait »12
« Ceci dit »10
« Là aussi »8
« Imaginez »7
« Bon, »7
« En gros »7
« A noter que »4
« Vous me direz »4
« Ce qu’il faut retenir »4
« Autant dire »3
« Attention, »3
« Pour faire simple »3

À lui seul, « D’ailleurs » pèse un tiers du total. Les douze autres sont des épices : présentes, reconnaissables, mais à petite dose.

« Bon, » apparaît 7 fois en plus de 50 000 mots, soit moins d’une fois tous les deux articles. Imaginez maintenant une IA à qui l’on dit simplement : « Serge emploie “Bon,” ». Combien de fois va-t-elle le placer dans un seul article ?

Le piège : un trait sans sa dose

Quand j’ai confié ma voix à mes outils de rédaction, la première version de mon guide listait mes tournures, mes mots-signature, mes marqueurs. Tout était juste, tout était tiré de mes textes. Et pourtant, dans les articles générés, j’ai vu revenir « Bon, » et « mécaniquement » bien plus souvent que je ne les écris. Chaque trait était bien le mien, mais à cette fréquence, c’étaient devenus des tics.

Pourquoi ? Parce qu’un modèle à qui on donne une consigne cherche à montrer qu’il l’a suivie, et le moyen le plus sûr de le montrer, c’est de rendre le trait visible. Si le guide dit « l’auteur emploie “mécaniquement” » sans dire combien de fois, le modèle le placera dès qu’il le peut : chaque occurrence est une preuve d’obéissance.

Mon guide disait même de mes tournures qu’elles étaient « à réemployer ». Pour moi, c’était une description. Pour le modèle, c’était un ordre.

Pourquoi un trait de voix devient un ticUne consigne nomme un trait de voix. Sans sa fréquence, le modèle rend le trait visible pour prouver qu’il a obéi, le place à chaque section, et le trait devient un tic. Avec sa fréquence, le modèle le place une fois et le trait reste une voix.Pourquoi un trait de voix devient un ticLe même trait, selon que la consigne dit sa fréquence ou nonLa consigne nomme un trait« Employez : mécanique, déséquilibre »Sans sa fréquenceLe modèle rend le trait visiblepour prouver qu’il a obéi, doncle place à chaque sectionUn ticAvec sa fréquenceLe modèle le place une fois,comme la consigne l’indiqueUne voixDans les 18 articles publiés de Serge Esteves, « mécanique » apparaît 8 fois,soit moins d’une fois par article. Relevé en octobre 2026.

C’est un peu comme le sel dans une recette. « Mettez du sel » et « une pincée de sel » ne donnent pas le même plat, et pourtant les deux consignes sont justes. Un trait de voix sans sa dose n’est plus une voix, c’est une caricature.

J’ai essayé de faire préciser cette dose par l’IA elle-même, au moment où elle extrait la voix d’un texte. Échec complet. Avec deux formulations différentes, dont une avec un format imposé et un exemple, le modèle a annoté la fréquence de zéro trait sur 25.

Il repère très bien les traits, il n’estime pas leur densité. Ça tombe bien : compter, c’est exactement ce que sait faire un script.

Ce qu’il faut retenir, c’est cette répartition des rôles : le modèle qualifie, le code quantifie. Laissez l’IA repérer ce qui fait votre voix, puis comptez vous-même combien de fois chaque trait revient. Dans mon guide, la consigne sur les incises est devenue : environ une tous les 500 mots, en variant, soit cinq ou six différentes dans un article de fond. Ce n’est plus une liste de tics à placer, c’est une dose.

Comment sortir la vôtre de vos textes

La méthode tient en quatre étapes. Aucune n’est compliquée, mais la dernière est celle que tout le monde saute.

1. Choisir trois à cinq textes vraiment représentatifs. Pas forcément vos plus récents, ni vos plus lus : ceux où vous vous reconnaissez le plus. Écartez les contenus réécrits par d’autres, les communiqués, les fiches produits. Et variez les sujets : si vos cinq textes traitent du même thème, vous extrairez un thème, pas une voix.

Pourquoi trois au minimum ? Parce qu’en dessous, une tournure propre à un seul texte passe facilement pour un trait de voix.

2. Travailler sur les textes entiers, pas sur un résumé. C’est l’erreur la plus courante : demander à une IA de résumer le style d’un texte. Un résumé garde le sujet et jette la voix, puisque la voix se trouve précisément dans ce qu’un résumé supprime : les incises, les digressions, la ponctuation, les petites prises de position en passant. Il faut le texte intégral, mot pour mot.

3. Distiller par axe, avec des citations. Pour chacun des cinq axes, notez les traits qui reviennent, et pour chaque trait, une citation exacte tirée de vos textes. La citation est le garde-fou.

Un trait qu’on ne peut pas illustrer par une phrase réellement écrite est un trait qu’on s’invente. « Ton direct » ne vaut rien ; « on tranche : “adieu le PR sculpting” » vaut quelque chose, parce qu’un modèle peut s’en servir.

Pour les traits qui se déclinent en variantes, comme les incises ou les formules d’ouverture, notez-en au moins cinq. Avec une liste de deux ou trois, le modèle les recycle en boucle, et vous retombez dans le tic. Si vos textes n’en fournissent pas assez, vous pouvez compléter par des tournures proches, à condition de les marquer comme des suggestions à valider : ce ne sont pas encore les vôtres.

4. Compter, pour fixer les doses. Une fois les traits repérés, comptez-les sur l’ensemble de vos textes et notez la fréquence à côté de chacun. Pensez aussi à ce qui n’apparaît jamais : une absence mesurée sur des dizaines de milliers de mots est une règle d’une fiabilité rare. C’est l’étape la plus fastidieuse à la main, et c’est elle qui fait la différence entre une voix et une imitation.

Attention, ces absences se transmettent mieux en positif. Plutôt que « jamais de tutoiement », écrivez « le lecteur est vouvoyé » ; plutôt qu’une liste d’expressions interdites, décrivez comment vous formulez une incise. Une consigne positive dit au modèle quoi faire. Un interdit lui dit seulement quoi éviter, et lui en parle quand même.

Et si vous n’avez pas encore trois articles publiés ? Prenez ce que vous avez écrit d’autre, à une condition : que ce soit vous qui l’ayez écrit. Une newsletter, de longs posts, la transcription d’une conférence font l’affaire. Ce qui ne fait pas l’affaire, ce sont les textes relus et réécrits par quelqu’un d’autre, parce qu’ils portent déjà deux voix.

Un dernier conseil : gardez le résultat court. Mon propre guide de voix pesait au départ plus de 10 000 caractères, soit 70 % des consignes de mon outil de rédaction. Il décrivait la voix, mais aussi la structure des articles : sommaire, listes, gras, maillage.

Résultat, les articles produits ressemblaient à des check-lists. Je l’ai ramené à moins de 6 000 caractères, en n’y laissant que la façon dont ça sonne. La voix dit comment ça sonne ; le plan de l’article, lui, se décide ailleurs.

Où la mettre une fois extraite

Une fois votre voix écrite, la tentation est de la recopier dans chaque outil : un bout dans le prompt de ChatGPT, une variante dans votre outil de rédaction, une autre dans les consignes d’un rédacteur freelance. Au bout de quelques mois, vous avez trois voix qui divergent, et plus aucune ne vous ressemble tout à fait. En gros, gardez-en une seule version, dans un seul document, et faites-la lire telle quelle par tous vos outils. Le jour où vous ajustez un trait, il change partout à la fois.

Un simple document texte suffit, du moment que vos outils le lisent tel quel. Évitez surtout qu’un outil le résume avant de s’en servir : un résumé de votre voix, c’est l’étape 2 à l’envers, on y perd exactement ce qu’on avait gagné.

Pour conclure

Votre voix de marque n’est pas un exercice de style à faire en atelier, avec des post-it et des adjectifs. Elle est déjà là, dans vos textes publiés, sous forme de régularités que vous pouvez compter : vos pronoms, votre rythme, vos tournures, et surtout ce que vous n’écrivez jamais. Ce qui manque à une IA pour écrire comme vous, ce n’est pas du talent. C’est cette description précise, avec ses doses.

Et vous, si vous passiez vos propres articles au crible, quel trait pensez-vous découvrir ?

Si vous voulez faire l’exercice sans écrire une ligne de script, j’ai construit un outil qui s’occupe des étapes 2 et 3 : vous lui donnez trois à cinq adresses de vos articles, il les lit (pas un résumé, le texte) et vous rend votre voix rangée en cinq axes, ses traits appuyés par des citations de vos textes, avec un rappel de dosage. Vous la récupérez sous deux formes : un bloc à coller dans n’importe quel assistant (ChatGPT, Claude, Mistral…) et un skill prêt à importer dans Claude. Le comptage de l’étape 4 reste de votre ressort : c’est là que votre relecture fait la différence. L’outil est gratuit.

Extrayez votre voix de marque à partir de trois de vos articles, gratuitement.

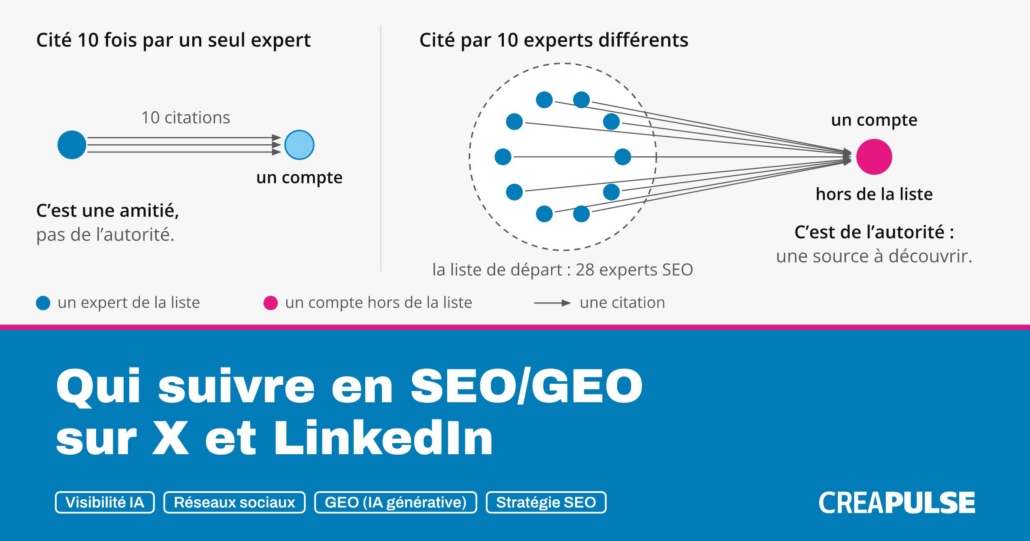
Schéma de la méthode : un compte cité dix fois par un seul expert, c’est une amitié ; un compte cité par dix experts différents de la liste de départ, même s’il n’y figure pas, c’est de l’autorité.

En bref

  • Cette page est remise à jour chaque mois : les classements, les scores et les sources émergentes viennent d’un scrape automatisé des deux plateformes.
  • Le point de départ est la liste des 28 « AI search experts » d’iloveseo.net, qu’on passe au crible des citations croisées plutôt que de la croire sur parole.
  • Deux plateformes, deux questions distinctes : X mesure qui le milieu cite, LinkedIn mesure qui touche du monde et quelles sources neuves émergent.
  • Huit comptes seulement ressortent comme vraiment utiles à une veille quotidienne , et deux des plus relayés ne figurent même pas dans la liste de départ.
  • Être cité ne veut pas dire valoir la peine d’être suivi : les scores sont croisés avec la part réelle d’auto-promo de chaque compte.

Bon, une liste d’experts à suivre, ça ne vaut que ce que vaut son critère de sélection. Celle des 28 « AI search experts » publiée par iloveseo.net est bien faite, mais une liste ne dit jamais si les gens qu’elle cite sont eux-mêmes cités.

Alors je mesure. Chaque mois, je récupère les posts de ces 28 personnes sur X et sur LinkedIn, et je compte qui cite qui, y compris en dehors de cette liste de seed de départ (c’est là où ça devient intéréssant). Puis je lis ce qu’ils publient , parce qu’un compte très cité peut très bien ne balancer que de l’auto-promo.

Comme à mon habitude, je vais essayer de vulgariser au maximum la méthode : c’est elle qui donne sa valeur au classement. Et je commence par la conclusion, ça vous évitera de scroller.

Données du 16 septembre 2026 au 16 octobre 2026. 639 sur x, 446 sur linkedin posts analysés, pour 28 personnes. Prochaine mise à jour : le 12 du mois prochain.

Les comptes à suivre, si vous ne lisez que ça

CompteOù le suivrePourquoi
Barry SchwartzXLa source que 13 des 20 comptes actifs relaient. Hors liste de départ.
Glenn GabeXL'analyse des mises à jour Google. Hors liste de départ.
Lily RayX144 posts, 1 % d'auto-promo, repère les updates en avance.
Aleyda SolísX et LinkedInLa curatrice : 87 comptes relayés sur X, 69 sur LinkedIn.
Marie HaynesX69 % de ses posts décortiquent un document ou une annonce Google.
Dan PetrovicXR&D technique originale : papiers Google reproduits, internals d'AI Mode.
Patrick StoxXLe meilleur rapport densité/volume du groupe.
Wil ReynoldsXRéflexion GEO originale, 0 % d'auto-promo sur la période.
Mark Williams-CookLinkedIn74 comptes cités par mois : le premier capteur du groupe.
Rand FishkinLinkedInLe meilleur engagement des 28 sur cette plateforme.
David KonitznyLinkedInÀ tester : la découverte du mois. Hors liste de départ.

Comment je mesure qui compte vraiment ?

Comment je mesure qui compte vraimentMéthode en quatre étapes : récupérer les posts des 28 experts de la liste de départ sur X et LinkedIn, garder les citations éditoriales en écartant les réponses, compter combien d’experts différents citent chaque compte, puis mesurer l’engagement (like 1, commentaire 3, partage 5, divisé par la médiane de la cohorte). Un compte cité dix fois par un seul expert, c’est une amitié. Un compte cité par dix experts différents, même hors de la liste de départ, c’est de l’autorité : une source à découvrir. X est classé par citations, LinkedIn par engagement.COMMENT JE MESURE QUI COMPTE VRAIMENT1. Récupérer les postsdes 28 experts, sur X et sur LinkedIn2. Garder les citations éditorialesréponses écartées : leur @ est automatique3. Compter qui cite, pas seulement combienCité 10 fois par un seul expert10 citationsun compteC’est une amitié,pas de l’autorité.Cité par 10 experts différentsla liste de départ : 28 experts SEOun comptehors de la listeC’est de l’autorité :une source à découvrir.un expert de la listeun compte hors de la listeune citation4. Mesurer l’engagementlike 1, commentaire 3, partage 5, divisé par la médiane de la cohorteX : qui le milieu citeclassé par citationsLinkedIn : qui touche du mondeclassé par engagementLes listes d’experts mesurent la notoriété.Les citations, elles, montrent où l’information naît.
La méthode des citations croisées : un compte cité par dix experts différents pèse plus qu’un compte cité dix fois par le même, même s’il ne figure pas dans la liste de départ.

Je récupère tous les posts des 28 personnes sur les deux plateformes, puis je regarde, pour chaque post, s’il cite quelqu’un d’autre du groupe. Et là il y a un point de méthode qui change tout le résultat : je sépare deux choses qu’on mélange d’habitude.

  • La citation éditoriale : une mention dans un post original, un repartage ou une citation. L’auteur a fait le choix actif de pointer vers quelqu’un.
  • La réponse : le @ y est ajouté automatiquement dès qu’on répond. Mécaniquement, deux personnes qui discutent beaucoup gonflent leur compteur mutuel sans que ça dise quoi que ce soit sur leur influence.

Je compte aussi combien d’experts différents de la liste citent chaque personne.. C’est la colonne la plus parlante des tableaux : être cité dix fois par un seul copain, c’est une amitié. Être cité dix fois par dix personnes différentes, c’est de l’autorité.

À ça s’ajoute un score d’engagement, noté E. On pondère les interactions par ce qu’elles coûtent au lecteur , un like vaut 1, un commentaire 3, un partage 5 , puis on divise par la médiane de la cohorte. Un post à E = 1 est un post médian ; au-delà du seuil de surperformance, il a mieux marché que d’habitude dans son milieu. Ce seuil est recalculé à chaque mesure, pas fixé une fois pour toutes : vous le trouverez plus bas, avec tous les autres paramètres du mois.

Et surtout, les deux plateformes ne répondent pas à la même question. Sur X, le graphe de citations est dense et sépare nettement : 59 citations pour la première, 32 pour la deuxième, 28 pour la troisième. Sur LinkedIn il est trop clairsemé pour classer qui que ce soit , 7 citations, puis 6, puis 6, puis 5, et neuf personnes à zéro. Les mentions y sont pourtant nombreuses, mais elles partent massivement hors du groupe : le monde SEO de LinkedIn est beaucoup plus large que ces 28 personnes.

Pour faire simple : X sert à mesurer qui le milieu cite, LinkedIn à mesurer qui touche du monde et quelles sources neuves émergent. Deux tableaux, deux critères de tri, jamais fusionnés.

Le classement sur X : qui le milieu cite

#PersonneCompteCitationsCité par (experts)E médianPosts surperformantsPortée médiane (mesurée)
1Lily Ray@lilyraynyc27122,45365 532
2Dan Petrovic@dejanseo1970,8531 491
3Aleyda Solís@aleyda17122,07135 252,50
4Marie Haynes@marie_haynes1461,3293 552
5Kevin Indig@kevin_indig1390,9911 796
6Metehan Yeşilyurt@metehan7771040,5901 831
7Rand Fishkin@randfish105n/dn/dn/d
8Dawn Anderson@dawnieando105n/dn/dn/d
9Suganthan Mohanadasan@suganthan930,8341 758
10Jono Alderson@jonoalderson76n/dn/dn/d
11Mark Williams-Cook@thetafferboy74n/dn/dn/d
12Tomek Rudzki@tomekrudzki74n/dn/dn/d
13Crystal Carter@crystalontheweb630,170285
14Wil Reynolds@wilreynolds530,9611 966,50
15Andrea Volpini@cyberandy430,170305
16Patrick Stox@patrickstox322,5433 725
17Amanda King@amandaecking32n/dn/dn/d
18Olivier de Segonzac—21n/dn/dn/d
19Joy Hawkins@joyannehawkins210,550892
20Mike King@verywellversed110,5402 091
21Mordy Oberstein@mordyoberstein110,280669,50
22Glen Allsopp@viperchill00n/dn/dn/d
23Jason Barnard@jasonmbarnard000,380292,50
24Nick Haigler—00n/dn/dn/d
25Beatrice Gamba—00n/dn/dn/d
26Laurence O'Toole@asklaurence00n/dn/dn/d
27Andy Crestodina@crestodina00n/dn/dn/d
28Olaf Kopp@olaf_kopp00n/dn/dn/d

n/d sur les trois dernières colonnes : la personne est citée, mais elle a publié moins de 5 posts mesurables sur la fenêtre — son engagement n’aurait pas de sens. Les citations, elles, restent comptées.

Le classement sur LinkedIn : qui touche du monde

#PersonnePostsE médianPosts surperformantsTauxAudiencePortée (estimee (ratio non calibre))
1Lily Ray911,409100 %61 2872 513
2Rand Fishkin175,121271 %221 8849 097
3Andy Crestodina53,95360 %136 7505 607
4Mark Williams-Cook62,51233 %90 5723 713
5Suganthan Mohanadasan72,03229 %15 361630
6Wil Reynolds91,66222 %46 4521 905
7Metehan Yeşilyurt52,09120 %17 595721
8Aleyda Solís291,65310 %126 0135 167
9Kevin Indig101,36110 %64 8552 659
10Dan Petrovic221,1200 %17 859732
11Tomek Rudzki50,9200 %7 477307
12Andrea Volpini50,7200 %10 853445
13Dawn Anderson60,7100 %9 079372
14Patrick Stox80,6200 %15 984655
15Olaf Kopp90,5800 %21 274872
16Marie Haynes90,4500 %17 497717
17Mordy Oberstein100,4400 %19 550802
18Joy Hawkins360,3300 %23 708972
19Jason Barnard140,1800 %15 230624
20Amanda King50,1600 %4 206172

La portée est une estimation : la plateforme ne publie pas les vues. Elle ne doit jamais être comparée à une portée mesurée, ni servir à classer des personnes.

Les sources qui émergent

C’est la partie la plus utile de l’exercice, et celle qu’aucune liste d’experts ne vous donnera : les profils que les 28 citent, et qui ne sont pas dans la liste. Je ne garde que ceux cités par au moins trois experts différents, pour éliminer les renvois entre copains.

ProfilCitationsCité par (experts)PlateformeQui le cite
rustybrick15913linkedin + xAleyda Solís, Andrea Volpini, Crystal Carter…
glenngabe5410linkedin + xAndrea Volpini, Dan Petrovic, Joy Hawkins…
thenextcorner299xAndrea Volpini, Dan Petrovic, Jono Alderson…
cyrusshepard208linkedin + xAleyda Solís, Andrea Volpini, Glen Allsopp…
maltelandwehr148linkedin + xAleyda Solís, Andrea Volpini, Kevin Indig…
charles_seo187xDan Petrovic, Glen Allsopp, Joy Hawkins…
gaganghotra_266xAndrea Volpini, Joy Hawkins, Lily Ray…
chris_nectiv146xAleyda Solís, Joy Hawkins, Kevin Indig…
jhtscherck136xDan Petrovic, Glen Allsopp, Joy Hawkins…
gfiorelli1116xAleyda Solís, Andrea Volpini, Metehan Yeşilyurt…
natzir9106xAleyda Solís, Dan Petrovic, Metehan Yeşilyurt…
nickwilsdon96linkedin + xAleyda Solís, Crystal Carter, Dawn Anderson…

Profils cités par au moins 3 experts différents de la cohorte, les plus largement repris d’abord. 69 autres passent le seuil sans tenir dans ce tableau. 112 profils cités par moins de 3 experts sont écartés : un renvoi isolé n’est pas une source.

Deux lectures à ne pas manquer dans ce tableau. Barry Schwartz est relayé par 13 des 20 comptes actifs : c’est lui qui sort l’information, et les experts de la liste qui la commentent. Et Malte Landwehr n’a que 8 citations, mais venant de 7 personnes différentes , peu cité, par presque tout le monde. C’est typiquement le profil que seul le comptage des experts différents fait remonter.

Ce qui a bougé depuis le mois dernier

Premier mois de mesure : pas encore de comparaison possible. Cette section affichera les entrées, les sorties et les variations de rang à partir de la prochaine mise à jour.

Les huit comptes du cœur

Lily Ray : le centre de gravité

Citée par 16 des 20 comptes actifs sur X, soit 59 citations : personne n’approche. 144 posts originaux en 30 jours pour environ 1 % d’auto-promo, et un score de 2,51, deux fois et demie la médiane de sa cohorte, avec 40 posts surperformants. Sur LinkedIn elle poste dix fois moins mais frappe plus fort : 14,39, le seul score du groupe à dépasser le repère exceptionnel. Sur la période, c’est elle qui a repéré que le spam update en cours tapait les pages programmatiques fortement templatées. À suivre sur X, c’est là qu’elle produit le volume.

Aleyda Solís : la curatrice

Le meilleur taux de surperformance sur X : 20 posts au-dessus du seuil sur 46, soit 43 %, devant Lily Ray. Mais sa vraie valeur est ailleurs , elle relaie 87 comptes distincts sur X et 69 sur LinkedIn. Vous suivez un compte, vous récupérez le flux de dix. Un peu de promo autour de ses guides et de SEOFOMO, largement compensé. La seule que je conseille sur les deux plateformes.

Marie Haynes : la plus dense en actu

28 citations venant de 9 experts différents, et le meilleur ratio information/bruit du lot: 69 % de ses posts traitent d’une actu ou d’un document Google. Sur la période, la guidance sur le « main content », le programme UGC Fresh Data, le pilote de rémunération des éditeurs. 5 % d’auto-promo. Son LinkedIn est l’exact inverse : 16e sur 17, avec 31 d’interactions médianes contre 109 pour la cohorte. À suivre sur X uniquement.

Dan Petrovic : le plus technique

32 citations venant de 11 experts différents, deuxième du classement X. Du vrai R&D : reproduction de papiers de recherche Google, vecteurs de fan-out, internals d’AI Mode. Deux réserves , 40 % de ses liens pointent vers son propre produit, et il ne cite presque personne en retour (10 comptes, dont aucun du groupe en post original). C’est un puits, pas un capteur. Le fond reste original, et personne d’autre ne creuse à ce niveau.

Patrick Stox : le meilleur rapport densité/volume

6 citations seulement, mais regardez les scores : 2,46 d’engagement médian et 42 % de posts surperformants, juste derrière Aleyda. Quand il poste, c’est dense et technique , les quatre spam updates de l’année, le markdown contre les fichiers llms.txt, la fermeture progressive des contournements de scraping de SERP. 17 posts sur le mois, la promo se limite à ses conférences.

Wil Reynolds : des idées plutôt que de l’actu

11 citations venant de 5 experts différents, et 0 % d’auto-promo sur la période. Il ne relaie pas l’actu, il réfléchit à voix haute sur le GEO : les KPI à tirer du query fan-out, pourquoi les citations sont un mauvais indicateur. Du contenu qu’on ne trouve pas ailleurs, à condition d’accepter quelques posts personnels au milieu. Correct sur les deux plateformes, légèrement meilleur sur LinkedIn.

Mark Williams-Cook : le capteur que X ne voit pas

Son compte X est muet depuis janvier 2025, et une analyse mono-plateforme le classerait « dormant ». Sur LinkedIn : 37 posts, 76 d’interactions médianes, et 74 comptes distincts cités en un mois , le premier capteur du groupe, toutes plateformes confondues. C’est exactement le genre de profil qu’une liste mono-plateforme juge sur un terrain qu’il a quitté.

Rand Fishkin : pas parti, déplacé

Même histoire : 3 posts sur X en 30 jours, de quoi conclure qu’il a décroché. En réalité il est parti sur LinkedIn autant que sur Bluesky , 13 posts mesurables, 504 d’interactions médianes, un score de 4,62 et 9 posts surperformants, le record du groupe. 220 000 abonnés, la plus grosse audience des 28.

Utiles, avec réserve

Kevin Indig

24 citations venant de 10 experts différents sur X, ce qui est beaucoup.. Mais 20 posts originaux pour 100 réponses : il est surtout là pour discuter, son vrai contenu part dans sa newsletter. Score de 0,77 sur X contre 1,15 sur LinkedIn, avec le meilleur rapport commentaires/likes du groupe , ce qu’il écrit fait réagir. À prendre sur LinkedIn, pour l’angle business.

Suganthan Mohanadasan

375 posts sur X, record absolu du groupe , mais 316 sont des réponses, et ses posts à forte audience parlent de tooling IA et de développement, pas de SEO : 12 % seulement touchent une actu search. Troisième au score LinkedIn avec seulement 7 posts. Un compte intéressant, pour un autre besoin que la veille search.

Metehan Yeşilyurt

8 citations, venant de 4 experts différents. Ses expériences GEO valent le détour : sur la période, un domaine neuf chargé de 50 000 statistiques fausses, juste pour voir ce que les moteurs avalent. Mais 12 posts originaux pour 65 réponses, un score sous la médiane sur les deux plateformes, et la promo de Peec AI n’est jamais très loin.

Mordy Oberstein

8 citations mais 2 experts différents seulement, et les scores les plus bas de sa cohorte sur les deux plateformes (0,23 et 0,58). 44 % de ses posts touchent une actu, le reste oscille entre promo SE Ranking et vannes de podcast. À noter : c’est lui le plus gros relais de Barry Schwartz dans le groupe. Si vous suivez Schwartz directement, Oberstein devient redondant.

Joy Hawkins

45 posts sur X et 32 sur LinkedIn, et de la vraie actu local search : les appels automatiques de Google aux commerçants pour relever les prix, le caractère non déterministe du classement local. Mais 33 % de ses posts sont de la promo d’événement, seuls 2 experts de la liste la citent, et son score LinkedIn est de 0,30, soit un tiers de la médiane de sa cohorte, sur gros volume. À garder seulement si le local vous concerne.

Andy Crestodina

Absent de X sur la période (dernier post en juillet 2026), mais 4e au score LinkedIn avec 2,52 et 136 000 abonnés. Aucun expert de la liste ne le cite en revanche : il joue dans le content marketing plus que dans l’AI search. Bon compte, pas sur ce sujet-là.

Les autres, et pourquoi je ne les garde pas

Ce n’est pas un jugement sur leur travail , plusieurs sont des références du métier. C’est un constat sur ce qu’ils publient, sur ces deux plateformes, pendant cette période.

PersonneSur XSur LinkedInPourquoi je l’écarte
Mike King22 citations, E 0,515 posts22 citations mais presque toutes en réponses, et 10 des 22 d’une seule personne. Flux X largement personnel ; son contenu de fond est sur ipullrank.com.
Andrea Volpini14 citations, E 0,26E 0,58Fond sérieux (ontologies, knowledge graphs) mais très niche, et le plus bas score de la cohorte X.
Crystal Carter12 citations, 5 posts8 posts, E 1,255 posts en 30 jours sur X, essentiellement des annonces de conférence.
Jono Alderson4 posts, 77 repartages6 postsExcellent capteur , 81 comptes relayés , mais il écrit trop peu, et ses repartages sont surtout du développement web.
Jason Barnard0 citation, E 0,4313 posts, E 0,1531 posts sur les deux plateformes et zéro citation de ses 27 autres experts. Dernier au score LinkedIn.
Dawn Anderson2 posts9 posts, E 0,82Respectée (4 citations de 3 personnes) mais rien à se mettre sous la dent sur la période.
Glen Allsopp3 posts3 postsSon travail est dans ses analyses longues, pas sur les réseaux.
Olaf KoppDormant depuis nov. 20258 posts, E 0,42Actif sur LinkedIn mais sous la médiane, et surtout germanophone.
Tomek RudzkiDernier post 7 sept. 20269 posts, E 0,74Volume faible sur les deux plateformes.
Amanda King1 post5 posts, E 0,08Quasi inactive sur la période.
Laurence O’TooleDormant depuis mars 20261 postRien à mesurer.
Beatrice GambaAucun compte2 postsRien à mesurer.
Olivier de SegonzacAucun compte perso7 posts, E 1,00Actif et pile dans le sujet, mais volume trop faible. À revoir s’il monte.
Nick HaiglerAucun compte2 postsIl publie sur le blog de Seer Interactive, pas sur les réseaux.

Les paramètres de ce mois

À noter, et c’est volontaire : aucun seuil de cette page n’est une constante. Ce qui est vrai d’un milieu ne l’est pas d’un autre, ce qui est vrai d’un mois ne l’est pas du suivant. Tout est recalculé sur le corpus du mois, et publié ici pour que vous puissiez critiquer le calcul.

ParamètreSur XSur LinkedIn
Seuil de surperformanceE ≥ 3.46E ≥ 3.15
Repère exceptionnelE ≥ 15.38E ≥ 23.9
Médiane d'interactions de la cohorte35.5103.5
Ratio vues/abonnés4.1 % mesuré (écart interquartile 3.3–7.0 %)4.1 % — importé : médiane mesurée sur x, même run, non calibré pour cette plateforme
Bornes de normalisation0.15384615384615385 – 4.5319148936170220.23404255319148937 – 3.1884057971014492
Âge de mesure7 jours — valeur importée, non mesurée
Pondération des interactions1 like, 3 commentaires, 5 partages
Posts mesurables468240

Questions fréquentes

Pourquoi deux classements au lieu d’un seul ?

Parce que les deux plateformes ne portent pas la même information. Sur X, le graphe de citations entre ces 28 personnes est dense et sépare nettement. Sur LinkedIn il est trop clairsemé pour classer qui que ce soit — les mentions y sont nombreuses mais partent massivement hors du groupe. Fusionner les deux donnerait un chiffre qui ne veut rien dire. Alors X est classé par citations, LinkedIn par engagement.

Pourquoi la portée est « mesurée » sur X et « estimée » sur LinkedIn ?

X publie le nombre de vues de chaque post, LinkedIn non. La portée LinkedIn est donc reconstituée à partir du nombre d’abonnés et d’un taux d’exposition, et ce taux n’a pu être calibré sur aucune mesure réelle — d’où la mention « ratio non calibré ». Les deux colonnes ne sont pas comparables, et la portée estimée ne sert jamais à classer des personnes.

Les citations, c’est un bon indicateur ?

C’est un bon indicateur de reconnaissance par les pairs, ce qui n’est pas la même chose que la qualité du contenu publié. Mike King est 5e au classement X et je ne le recommande pas ; Patrick Stox est 14e et je le recommande. C’est exactement pour ça que les tableaux portent des scores d’engagement en plus des citations, et que chaque personne a droit à son commentaire.

Pourquoi certaines personnes n’ont pas de score ?

Il faut au moins 5 posts mesurables sur la période pour qu’un score ait un sens. En dessous, un seul post à succès suffirait à propulser quelqu’un en tête. Et un post est « mesurable » quand il a au moins 7 jours : avant ça, ses compteurs n’ont pas fini de monter et on comparerait des choses d’âges différents.

Un mois, c’est assez pour conclure ?

Non, et c’est précisément pour ça que cette page est mensuelle. La première fenêtre analysée coïncide avec un spam update Google, ce qui avantage mécaniquement ceux qui couvrent les mises à jour. Un mois calme donnerait un autre classement — et c’est justement la variation d’un mois sur l’autre qui finira par être l’information la plus intéressante.

Les chiffres sont-ils exhaustifs ?

Ce sont des minima. Les volumes X viennent de la recherche avancée, qui sous-capte les réponses des très gros comptes, et le scrape LinkedIn plafonne le nombre de posts par profil. Ça joue sur les totaux, pas sur l’ordre : les écarts en haut de tableau sont trop larges pour qu’un comptage plus fin les renverse.

Ce que je retiens

Le classement brut et la liste à suivre ne se recouvrent qu’à moitié. Les citations disent qui le milieu reconnaît ; elles ne disent rien de ce qu’un compte publie réellement. Il faut croiser les deux, et deux plateformes, pour construire une veille qui tient dans le temps.

Et le résultat le plus utile n’était pas dans la liste de départ : ces 28 experts passent une bonne partie de leur temps à relayer le même homme, qui n’y figure pas. Les listes d’experts mesurent la notoriété ; les citations, elles, montrent où l’information naît.

Vous la faites comment, votre veille AI search ? Sur X, sur LinkedIn, ou vous avez décroché des deux ?

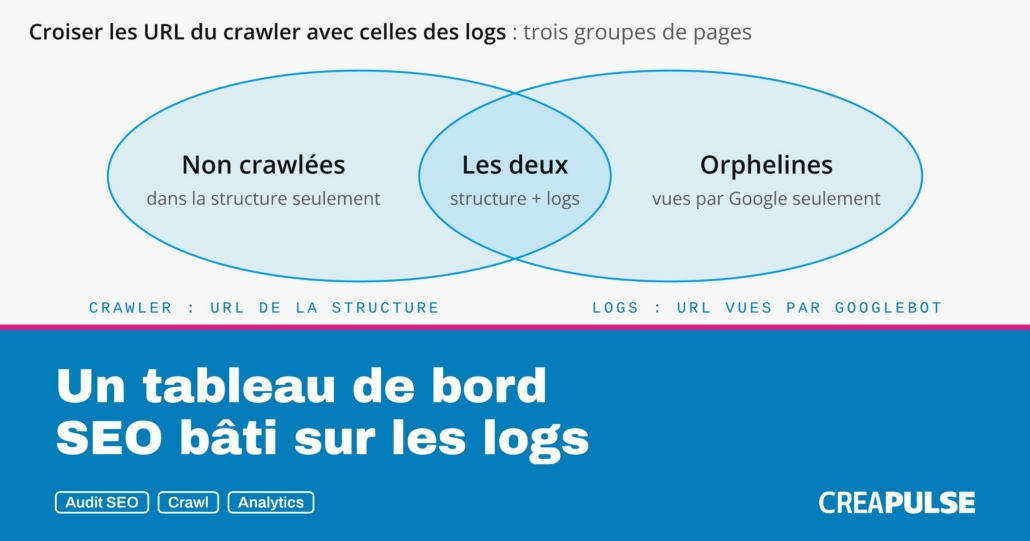
Schéma du croisement entre les URL de la structure trouvées par un crawler et les URL vues par Googlebot dans les logs : pages non crawlées, pages présentes des deux côtés et pages orphelines.

En bref

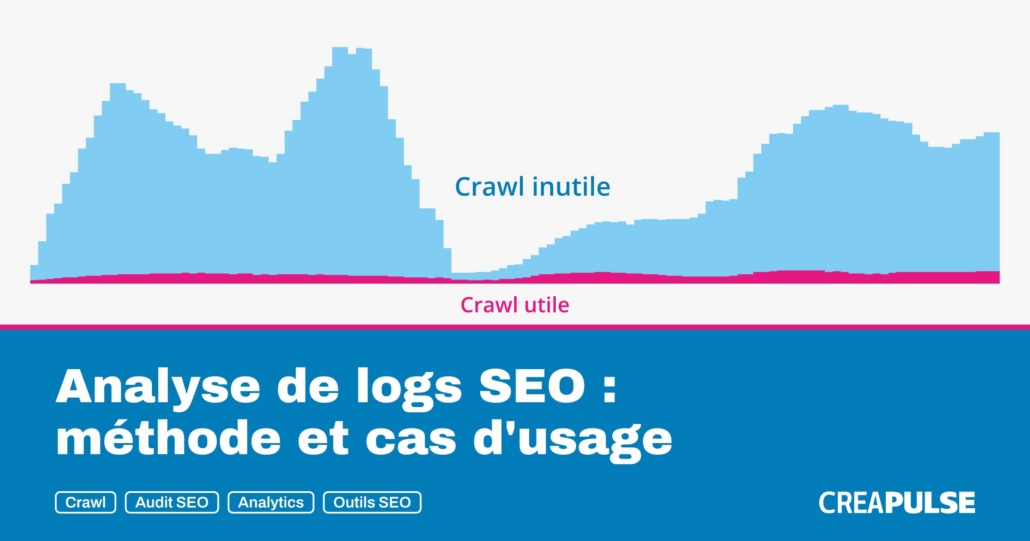
  • Un tableau de bord SEO bâti sur les logs croise deux listes d’URL : celles qu’un crawler trouve dans la structure du site et celles que Googlebot visite vraiment. Ce croisement révèle les pages orphelines, vues par Google mais absentes de la structure, et les pages que Google ne crawle jamais.
  • Les indicateurs se lisent par catégorie de pages (produits, catégories, articles, paginations…), découpées par des regex : à l’échelle du site entier, une moyenne ne dit rien d’opérationnel.
  • Le ratio visites / crawl mesure l’efficacité d’une catégorie de pages : beaucoup de passages de Googlebot pour peu de visites, c’est du crawl gaspillé ; peu de passages pour beaucoup de visites, ce sont des pages à pousser.
  • Le taux de crawl (URL de la structure crawlées par Google ÷ URL de la structure) et le taux de pages actives (pages qui font au moins une visite ÷ URL connues) montrent où concentrer les optimisations.
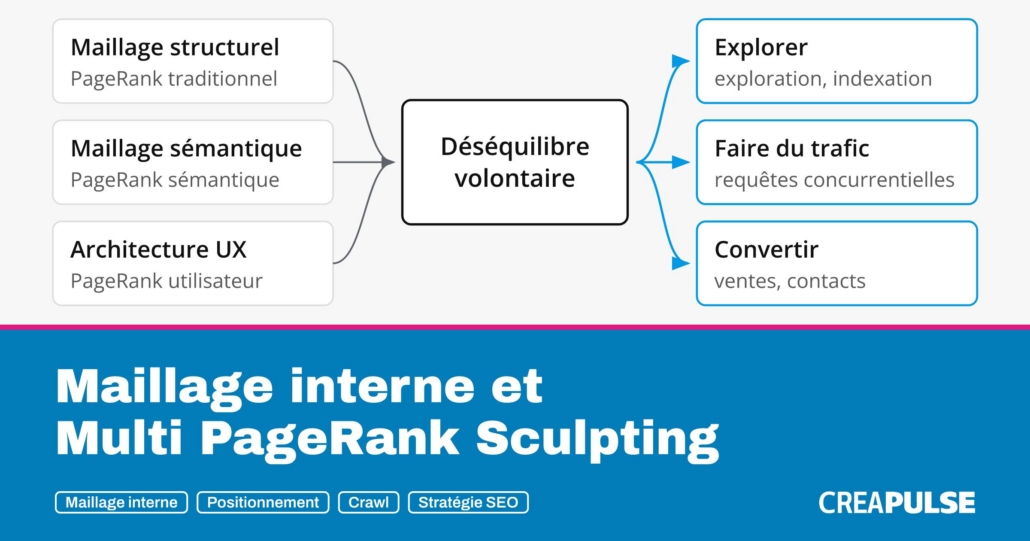
  • Mettre côte à côte la part de chaque catégorie dans le crawl, les visites et le pagerank interne fait ressortir les déséquilibres : une catégorie qui capte 50 % du pagerank interne pour 10 % des visites, ça ne va pas.

Créer un tableau de bord SEO devrait être l’étape essentielle avant de commencer un audit SEO ou maintenir un suivi pour tout référenceur. Un bon tableau de bord permet d’avoir une vue synthétique des principaux axes d’améliorations du site dans le but d’apporter des optimisations concrètes. Les logs enregistrés par le site permettent de récupérer des informations impossibles à récupérer autrement, notamment le passage de Googlebot. Je vais essayer de vous montrer ici comment récupérer certains indicateurs, grace aux logs, indispensables pour réaliser un vrai audit SEO.

Exemple d’un tableau de bord SEO

Voici une vidéo qui explique et illustre rapidement ce qu’on peut obtenir dans un tableau de bord SEO grâce aux logs. Et pour plus de détails, les formules pour calculer certains KPI avec les logs par exemple, il faut lire l’article.

Pourquoi analyser les logs pour optimiser le SEO d’un site ?

Analyser les logs d’un site est le seul moyen pour savoir ce que voit Google sur votre site. Sauf pour les petits sites de quelques dizaines de pages, Google ne connait jamais l’intégralité des pages d’un site. Et si il connait certaines des pages d’un site, il ne va pas crawler toutes les pages à la même fréquence, et ca ne signifiera pas pour autant qu’elles seront indéxées ou même bien positionnées. On verra plus tard que la fréquence de passage de googlebot sur une page influe sur ses chances de faire des visites ou pas.

Donc avec les logs, on peut savoir:

  • Quelles pages Google connait
  • Combien de fois Googlebot crawle une page sur une période donnée
  • Combien de visites une page fait
  • La fenêtre de crawl . : La fréquence de crawl Googlebot nécéssaire pour qu’une page ait des chances de faire des visites
  • Les mots clés tapés sur Google lors de la visite (le peu qui reste car beaucoup de « not provided »)

Mais là où ça devient vraiment intéréssant, c’est lorsqu’on croise les données des logs avec les données d’un outil de crawl comme botify, oncrawl ou encore screaming frog. Car avec ces outils on va récupérer les urls qui existent sur le site et on va donc pouvoir comparer avec les urls que connait Google.

Avec les données de logs croisées avec les données d’un crawler, on peut savoir:

  • Quelles sont les pages orphelines : les pages que connait Google mais inaccessibles sur le site
  • Les pages non crawlées par Google: les pages qui existent sur le site mais Google ne voit pas
  • Quel est le taux de crawl : Le ratio entre les pages accessibles depuis la structure du site et ce que Google connait
  • Le taux de pages actives : Le ratio entre les pages accessibles depuis la structure du site et celles qui font des visites

Vous me direz, des outils comme botify et oncrawl le font déja. Oui, mais il n’y a aucun moyen avec ces outils d’avoir facilement une vue synthétique des différents KPI par catégories du site. Par exemple, impossible de voir quel est la part de crawl de Google que représente une catégorie au sein d’un site. Ou encore plus basique, la part des visites d’une catégorie sur tout le site. Des informations pourtant essentielles pour voir d’un coup d’oeil ce qui ne va pas dans le référencement naturel du site et ce qu’il faut optimiser en priorité.

Mais on va aller encore plus loin, sortir des KPI qui n’existent tout simplement pas sur les outils cités et pourtant super intéréssants. De quoi peut-être leur donner des idées si ils lisent cet article.

Et en attendant, il y a une phase essentielle qui consiste à collecter les données, les croiser, les catégoriser afin d’établir un tableau de bord SEO grace aux logs, commençons:

Etape 1: Croiser les urls des logs et les urls du crawl

Croiser les URL du crawler et celles des logsDeux ensembles d’URL : celles de la structure du site, trouvées par un crawler, et celles vues par Googlebot dans les logs. Leur croisement donne trois groupes : les pages de la structure jamais crawlées par Google, les pages présentes des deux côtés, et les pages orphelines, vues par Google mais absentes de la structure. Réunis, ils forment la liste complète des URL du tableau de bord.ÉTAPE 1 : CROISER LES URL DU CRAWLER ET DES LOGSCRAWLERURL de la structure du siteLOGSURL vues par GooglebotNon crawléesstructure seuleLes deuxstructure + logsOrphelineslogs seulsNon crawléesà faire découvrir à Googlepar le maillage interneDans les deuxla base du taux de crawlet du ratio visites / crawlOrphelines (nomatch)à remettre dans la structureou à laisser sortirLes trois groupes réunis forment la liste complète des URL.Taux de crawl = URL de la structure crawlées par Google ÷ URL de la structure.
Croiser la liste d’URL d’un crawler avec celles des logs donne trois groupes : les pages de la structure jamais crawlées par Google, celles présentes des deux côtés et les pages orphelines, vues par Google mais absentes de la structure.
schéma de croisement de données entre données d'un crawler et données issuees des logs

schéma de croisement de données entre données d’un crawler et données issuees des logs

Je considère que vous avez déja votre liste d’urls extraites d’un crawler (ex: sreaming frog) et votre liste d’urls issues des logs avec le crawl de Googlebot mobile et les visites depuis le moteur de recherche Google. Vous pouvez extraire les logs avec un outil comme apache log viewer ou en ligne de commande. A noter que j’ai précisé Googlebot mobile, et bien oui, depuis l’index mobile first, c’est le googlebot mobile qui devient majoritaire, ceci dit on peut très bien mixer les deux Googlebot dans les analyses de logs. Je considère aussi que vous maîtrisez les fondamentaux d’excel, rien de compliqué ceci dit.

Sur excel, vous collez votre liste d’urls issues du crawler dans une feuille nommé par exemple « urls structure ». Vous collez la liste des urls des logs dans une feuille nommé « urls logs ». Jusque là, tout va bien. Pour croiser les urls du crawler et les urls des logs, on va pas se contenter d’additionner les urls des 2 feuilles, ce serait trop facile et surtout ce serait faux. Avant de continuer il faut comprendre qu’on a plusieurs types d’urls:

  • Les urls dans la structure ET aussi dans les logs
  • Les urls dans la structure et PAS dans les logs
  • Les urls dans les logs et PAS dans la structure, ce qu’on appelle les pages orphelines (nomatch)

On va donc isoler ces différents groupes d’urls et ensuite on pourra les additionner afin d’avoir une liste complète des urls qui croisent les données de crawl du crawler et les données des logs.

Etape 1.1: Extraire les urls dans la structure ET aussi dans les logs

C’est simple, on prend notre feuille « urls structure » et on fait un rechercheV avec la feuille « urls logs » pour récupérer le volume de crawl et les visites pour chaque url présente dans la structure et que Google connait.

Etape 1.2 : Extraire les urls dans la structure et PAS dans les logs

Il s’agit des urls non connues de Google. On reste sur notre feuille « urls structure », on rajoute 2 colonnes: « structure » et »nomatch ». Pour les urls qui ont matché dans l’étape 2.1, on met 1 dans la colonne « structure ». Pour les urls qui n’ont pas matché, on met « 0 » dans la colonne nomatch. On peut en profiter pour copier coller les urls avec structure=1 / nomatch= 0 et les urls avec un crawl =0 dans une autre feuille qu’on appellera « urls non crawlées par Google ». C’était le principal intérêt de cette étape en réalité, pas vraiment essentiel pour croiser crawl et logs mais importante pour la suite.

Etape 1.3: Extraire les urls dans les logs et PAS dans la structure (nomatch)

Cette fois, on part de la feuille « urls logs » et on fait un rechercheV sur la feuille urls structure ». On rajoute une colonne qu’on appellera « nomatch ». Les urls qui matchent, on met 0 dans la colonne « nomatch » et les urls qui matchent pas, on met 1 dans la colonne « no match ». On filtre la feuille « urls logs » et la colonne « nomatch » égale à 1 et on colle les données dans une feuille qu’on apellera « nomatch ».

Etape 1.4: On mélange tout ça

Dans une feuille qu’on nommera « all urls », on ajoute les urls de la feuille « structure » et les urls de la feuille « nomatch ». On a donc bien nos urls de la structure vus par Google, non vues par Google et vues par Google mais pas dans la structure. Et avec les urls, on a biensur toutes nos données du crawler, ainsi que le volume de crawl et les visites issues des logs et une distinction pour savoir si l’url est dans la structure ou en nomatch (hors structure).

Etape 2: Catégoriser les urls

Schéma de catégorisation d'urls

Schéma de catégorisation d’urls

Pour l’instant, on s’est juste contenter de dresser une liste d’urls avec tout un tas d’informations. Mais pour créer notre tableau de bord SEO, il faut d’abord catégoriser le site. On va segmenter le site en différentes catégories: page d’accueil, pages produits, pages de menu, paginations, articles de blog, etc… Pourquoi ? Parce que sans ça, on se contentera d’avoir des données macro au niveau du site en entier uniquement ou d’une seule url, ce qui a très peu d’intérêt. C’est d’ailleurs le cas aussi pour les crawlers que j’ai cité, sans une bonne catégorisation, difficile d’en tirer quoi que ce soit d’opérationnel.

Prenons un cas concret, on a une catégorie de pages qui est fortement crawlée par Google mais dont le trafic est peu qualifié et une autre catégorie qui est peu crawlée mais dont le trafic est très qualifié. Une idée de maillage interne est d’utiliser le catégorie très crawlée pour faire des liens vers la catégorie peu crawlée et qu’on veux pousser davantage. Sans catégorisation, impossible de faire ce genre d’analyses.

Je ne vais pas ici expliquer comment catégoriser les urls d’un site, personnellement j’utilise des regex, un language puissant permettant de représenter des modèles de chaînes de caractère et qui est aussi utilisé en programmation. On peut aussi essayer de catégoriser des urls avec les filtres avancés d’excel, avec les quelques limites que ça implique mais qui peut parfois suffire pour des sites peu complexes.

A noter que si vous utilisez des outils botify ou oncrawl, les possibilités de filtrages sont un peu plus avancées que sur excel pour créer ses catégories, même si la solution des regex reste la meilleure pour avoir une catégorisation stricte et sans erreurs.

Etape 3: Extraire les KPI de base: Crawl, visites, pages uniques crawlées,..

Une fois qu’on a notre liste d’urls croisées avec les logs et catégorisée, on a fait le plus dur, ce qui n’était pas non plus insurmontable. Il s’agit maintenant de faire un tableau croisé dynamique sur excel avec les catégories en tant que ligne et les différents kpi en tant que valeur. Pour commencer, on va récupérer pour chaque catégorie les données de base provenant des logs:

  • Volume de crawl: somme du crawl
  • Volume de visites: somme des visites
  • Pages uniques uniques crawlées: Nombre d’urls crawlées
  • Pages actives: Nombre d’urls visitées

Si j’ai précisé à chaque « somme » ou « nombre » , c’est pas pour rien, car dans votre tableau croisé dynamique, il faut changer le paramètre de champ de valeur en conséquence. Par défaut, le paramètre de champ de valeur est « somme », il faudra donc bien penser à le changer en « nombre » pour les pages uniques crawlées et les pages actives.

Etape 4: Distinguer ce qui relève de la structure ou des pages orphelines

Pages orphelines (ou nomatch) = Pages vues uniquement par Google

Pages orphelines (ou nomatch) = Pages vues uniquement par Google

On reprend les kpi précédents: volume de crawl, de visites, pages uniques crawlées et pages actives mais cette fois on distingue ce qui est dans la structure ou en pages orphelines (nomatch). Même principe donc mais utilisant des filtres vu qu’on a pris le soin d’ajouter une colonne structure et une colonne nomatch. On récupère donc ceci:

  • crawl structure / crawl nomatch
  • visites structure / Visites nomatch
  • Pages uniques uniques crawlées structure / Pages uniques uniques crawlées nomatch
  • Pages actives structure / pages actives nomatch

Je vous garantis que là déja, vous avez des informations que vous n’aurez jamais avec les outils actuels du marché. Grace à ces données, vous pouvez par exemple savoir quelle est la part du crawl de google sur les pages orphelines par rapport aux pages dans la structure. Si cette part est importante c’est mauvais pour le site mais c’est une bonne piste d’optimisation pour votre audit SEO. On verra par la suite que le taux de pages actives des pages orphelines est toujours inférieur au taux de pages actives des urls dans la structure, d’où l’intérêt de ces indicateurs.

L’analyse des pages orphelines est essentielle dans le cadre d’un audit de site e-commerce par exemple. Les sites e-commerce ont tous, en fonction de la rotation des produits, des problèmes d’expiration de produits, de produits plus en stock ou plus disponible. Il est important de bien maitriser le crawl de Google sur des produits expirées qui sortent donc de la structure et qui deviennent par conséquent des pages orphelines.

Etape 5: Analyser l’efficacité des pages: Visites / crawl

Exemple client montrant les catégories de pages les plus efficaces selon le ratio visites / crawl

Exemple client montrant les catégories de pages les plus efficaces selon le ratio visites / crawl

Là aussi, c’est un indicateur que je n’ai jamais vu sur les outils du marché, même chez ceux qui croisent crawl + logs. C’est pourtant un KPI essentiel pour tout bon tableau de bord SEO et qu’on peut facilement calculer. L’indicateur visites / crawl consiste simplement à diviser les visites depuis le moteur de recherche par le crawl de Googlebot.

Par exemple:

  • Si Google explore souvent une page ou une catégorie de pages et qu’elle génère peu de visites, je considère qu’elle est peu efficace.
  • A l’inverse, Si Google crawle peu souvent une catégorie de pages et qu’elle génère beaucoup de visites, c’est une catégorie de pages efficaces.

Cette notion d’efficacité est liée au budget de crawl . Google a un temps limité lorsqu’il crawle un site, alors l’intérêt de l’indicateur Visites / crawl est multiple:

  • Orienter le crawl de Googlebot vers les pages efficaces, peu de crawlées par Google et qui font beaucoup de visites
  • Limiter ou supprimer le crawl de Googlebot vers les pages peu efficaces, très crawlées par Google et avec peu de visites
  • Se servir des pages efficaces pour pousser des pages stratégiques

Dans la pratique, je devrais rajouter un autre point car parfois des pages peu efficaces ont une légitimité à l’être davantage, car peu de contenu, peu de maillage, ou autres. C’est là que l’oeil de l’expert doit correctement analyser et interpréter les données.

Pour en revenir à notre tableau de bord SEO, il s’agit simplement de rajouter un colonne qui divise les visites sur le crawl.

Formule de l’indicateur Visites / crawl = Volume de visites / Volume de crawl Google

Plus la valeur est importante et plus notre catégorie de pages est efficace.

Et pour aller plus loin, on peut même ajouter l’indictateur visites / crawl pour les urls dans la structure et en nomatch (hors structure). Ca permettra de voir que l’efficacité des urls hors structure est moindre que celles dans la structure.

Etape 6: Calculer le taux de crawl et le taux de pages actives

Le taux de crawl c’est le ratio entre les pages vues par un crawler et les pages vues par Google. Si un site a un taux de crawl de 60%, ca signifie que Google ne voit que 60% des pages accessibles en ligne. La aussi, c’est une information qu’il faut connaitre catégorie par catégorie et non au niveau du site en entier comme le font la plupart des outils. L’objectif est d’améliorer le taux de crawl des pages génératrices de trafic et qui en ont le plus besoin. Plus Google connait de pages et plus il y aura de pages potentiellement indéxées et capables de faire des visites.

La formule du taux de crawl = urls uniques crawlées par Google dans la structure / urls dans la structure

Le taux de pages actives, c’est le ratio entre les pages qui font des visites et les pages qui existent sur le site.

La formule du taux de pages actives: Pages actives / urls connues (urls connues via le crawler et via les logs)

L’objectif sera de concentrer les efforts et de prioriser les optimisations sur les pages qui ont à la fois un taux de pages actives faible, un grand volume de pages et une bonne efficacité visites / crawl.

Vu qu ‘on distingue bien les urls de la structure et les nomatch, on peut aussi calculer:

  • un taux de crawl structure
  • un taux de crawl nomatch
  • un taux de pages actives structure
  • un taux de pages actives nomatch

Ce qui permettra notamment de mettre en évidence la nécéssité ou pas de remettre dans la structure certaines pages anciennement en nomatch. Encore une donnée que les crawlers du marché nous donnent pas.

Etape 7: Calculer le Pagerank interne des pages crawlées par Googlebot

Visualisation du pagerank interne sous forme de secteurs et sous gephi

Visualisation du pagerank interne sous forme de secteurs et sous gephi

Vous avez surement déja entendu du pagerank interne, c’est un score qui mesure le jus envoyé aux pages selon la formule du pagerank historique de Google en tenant compte uniquement des pages internes au site. En gros, cette donnée dépend fortement du nombre de liens entrants et sortants sur chaque url, et de la profondeur des pages. Même si il y a plusieurs types de pagerank et même si ce score se base uniquement sur les pages internes au site (et non le web entier, impossible à calculer) c’est une donnée intéréssante car ça montre le poids donné par la structure à chaque catégorie du site.

Certains crawlers donnent des noms différents au pagerank interne, screaming frog appelle ça le linkscore, oncrawl appelle ça l’Inrank, et Botify appele ça… le pagerank interne, normal on vient de la même « école » les fondateurs et votre serviteur. Mais les scores qui se basent sur une échelle de 1 à 10, comme c’est le cas pour le linkscore de screaming frog et le inrank de oncrawl sont très peu exploitables, car c’est une donnée trop grossière pour avoir un calcul précis du pagerank interne par catégories. Botify, en revanche le calcule correctement via ce qu’ils nomment plus exactement le « pagerank interne brut ».

On le calcule comment ce pagerank interne si on a pas botify ? D’autres outils le font assez bien comme netpeak spider et pour les utilisateurs de screaming frog, une solution consiste à passer par un script R (voir le tuto ici).

Mais attendez là, j’ai parlé du PageRank Interne (PRi), pas du PageRank Interne des pages Crawlées par Googlebot (PRic) ! En fait les scores de PRi calculés par tous les crawlers cités, botify compris, prennent en compte toutes les pages de la structure, même celles qui ne sont pas vues par Googlebot. Le PRi est donc un score de pagerank interne absolu si Google parvenait à crawler l’ensemble des pages du site.

Mais on sait très bien que ce n’est jamais le cas, sauf pour les petits sites. Si Google connait 50% du site, il faudrait calculer le pagerank interne uniquement sur ce que connait Google non ? et pas sur tout le site ! En fait les 2 scores sont intéressants, le PR i et le PR ic, mais ce dernier est plus « vrai »sur l’état du pagerank interne à un instant T vu qu’on se base uniquement sur ce que connait Google sur une période donnée. Et pour calculer ce PRic, il est donc nécessaire d’analyser les logs.

Le fait est qu’aucun crawler du marché ne calcule ce PRic qui est pourtant plus représentif du « vrai » pagerank interne que le PRi. Vu que dans notre fichier excel, on connait les urls dans la structure et crawlées par Googlebot, on peut les filtrer et calculer le pagerank interne uniquement sur ces urls là.

Dans tous les cas, que ce soit le Pri ou le PRic, on reste sur des valeurs approximatives et relatives, il n’y a pas donc pas vraiment de vrai pagerank interne au sens stricte. L’objectif de ces indicateurs est plus de se faire une idée sur la répartition du maillage interne et voir comment mieux distribuer le jus du site vers les pages génératrices de trafic et de conversions.

Etape 8: Mesurer la Fréquence de crawl

La fréquence de crawl, c’est le nombre de fois que Googlebot est passé sur une page. Pour calculer la fréquence de crawl la formule est: Volume de crawl / pages uniques crawlées. La aussi c’est un indicateur qui est rare de retrouver. De plus, si on filtre la fréquence de crawl avec uniquement les urls qui font des visites, on peut savoir combien de fois en moyenne Google doit passer sur une page pour qu’elle ait des chances de faire des visites. Valeur qu’on aura catégorie par catégorie, car la fréquence de crawl est différente d’une catégorie à l’autre.

Inutile d’avoir cette donnée au niveau du site en entier, car certaines pages comme la page d’accueil notamment, ont de très grosses fréquences de crawl, ce qui augmente la moyenne générale du site.

Etape 9: Afficher les ratios des kpi par catégories par rapport à tout le site

L’idée est d’afficher clairement sur le tableau de bord SEO quel est la part de crawl d’une catégorie par rapport à tout le site, sa part de visites, sa part de pagerank interne, sa part d’urls connues, sa part de nomatch, etc…

Ces information mises côté à côté dans un tableau de bord est certainement ce qu’il y a de plus intéressant car en un coup d’oeil, on peut voir ce qui ne va pas sur un site et ce qu’il faut optimiser.

Par exemple, si voit qu’une catégorie accapare 50% du pagerank interne pour seulement 10% des visites., on voit tout de suite que ça ne va pas.

Etape 10: Intégrer d’autres sources de données que les logs et le crawl

En plus des logs, on peut ajouter au tableau de bord SEO des données provenant du crawler biensur mais de l’outil de web analytics (ex: Google analytics), de la console de recherche Google, d’outils de suivi de positions (ex: semrush), d’outils de backlinks (ex: majestic SEO). Voici quelques exemples de KPI à ajouter au tableau de bord:

Via le crawler

  • Nombre de mots contenus sur les pages
  • Le ratio texte / html
  • La profondeur moyenne
  • Taille moyenne du title
  • Taille moyenne du H1

Des données très utiles dans le cadre d’un audit ou d’une analyse sémantique

Via l’outil de web analytics

  • Taux de rebond
  • Temps passé par page
  • Temps de chargement de pages interactive
  • Nombre de conversions

Des données importantes pour l’optimisation de l’expérience utilisateur et du SEO.

Via la console de recherche Google

  • Le CTR moyen
  • La position moyenne
  • Les impressions moyennes

La aussi des KPI utiles pour l’UX.

Via des outils comme semrush, majestic et autres

  • Volume de recherche moyen
  • Nombre de backlinks

Les possibilités de croisement de données sont nombreuses en fonction du besoin et des problématiques rencontrées. Mais une fois qu’on a pris le temps de bâtir un tableau de bord SEO avec ces informations déja, on peut vraiment prendre des décisions basées sur des données objectives et scientifiques. C’est d’ailleurs une devise que je met dans ma signature mail:

Le SEO n’est pas un art mais une science


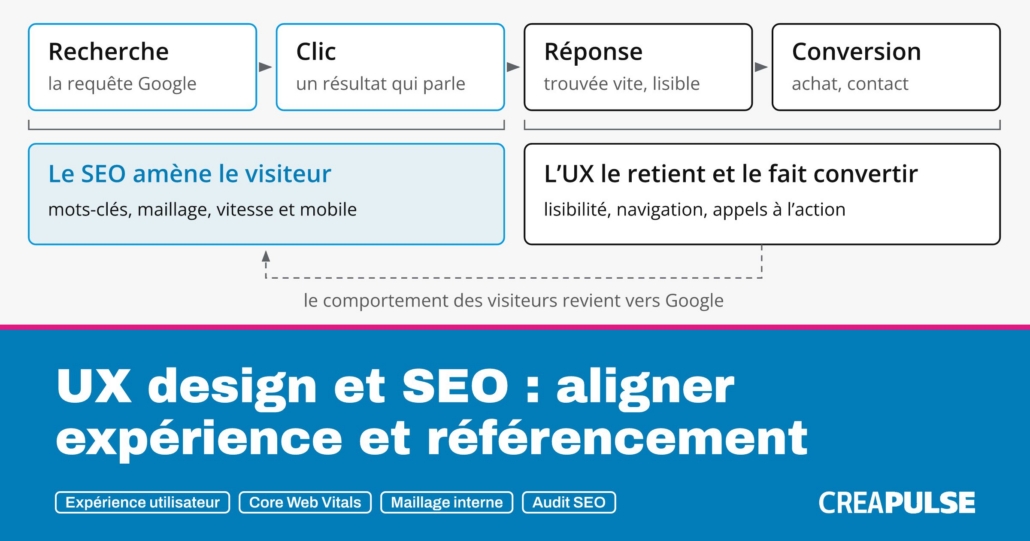
Schéma du parcours d'un visiteur, de la recherche à la conversion : le SEO l'amène jusqu'à la page, l'UX le retient et le fait convertir, et son comportement revient vers Google.

En bref

  • Le SEO amène l’utilisateur au contenu dont il a besoin, l’UX répond à ses questions une fois sur la page : les deux visent le même objectif et donnent de meilleurs résultats lorsqu’ils sont combinés (SXO) plutôt que gérés séparément.
  • Être bien positionné sur Google ne signifie pas offrir la meilleure expérience : une étude sur 638 mots-clés met en évidence un écart entre classement SEO et qualité de l’expérience de navigation.
  • Les Core Web Vitals chiffrent l’expérience de page avec trois seuils « bon » : un LCP de 2,5 secondes ou moins, un INP inférieur à 200 millisecondes et un CLS inférieur ou égal à 0,1. Ces seuils sont un repère, pas une garantie de satisfaction.
  • Vitesse, version mobile, navigation, maillage interne (pages orphelines, liens cassés, profondeur) et mise en forme du contenu servent à la fois l’utilisateur et le robot de Google.
  • Pour mesurer la performance UX/SEO, il faut croiser données Google et de comportement utilisateur, suivre des indicateurs d’engagement et de CTR, puis prioriser les correctifs sur les gabarits lents des pages stratégiques.

Le référencement n’implique pas que la création de liens, le maillage interne et l’inclusion de mots clés pertinents dans le contenu. Bien qu’il s’agisse de  stratégies importantes, les moteurs de recherche considèrent beaucoup plus que cela lors du classement des sites Web. Les éléments  d’expérience utilisateur (UX) sont très importants pour le SEO .

Lire la suite
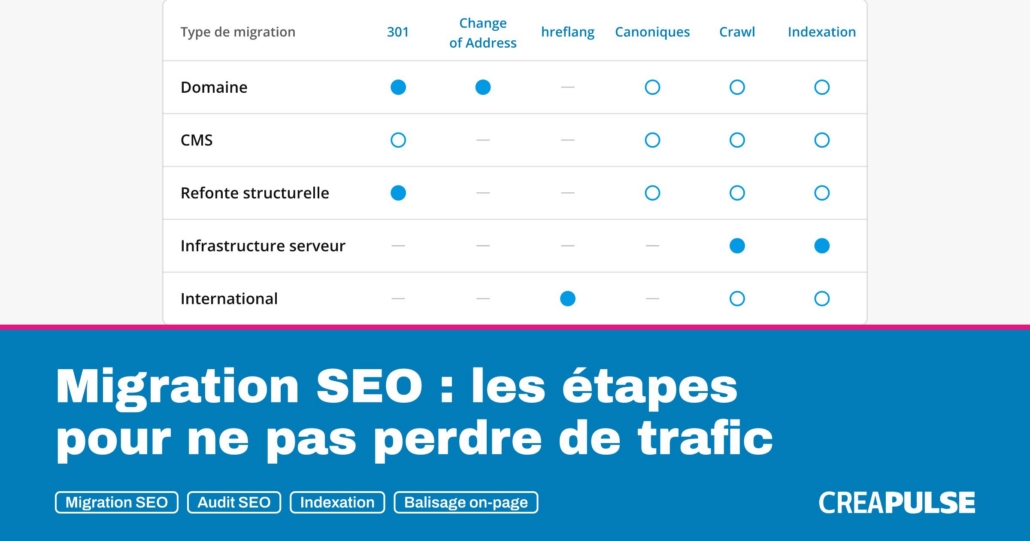
Matrice des actions à mener selon le type de migration (domaine, CMS, refonte structurelle, infrastructure serveur, international) : redirections 301, changement d’adresse, hreflang, canoniques, crawl et indexation.

En bref

  • Une migration SEO bien préparée ne fait pas forcément perdre de trafic : tout se joue avant le jour J, en auditant l’ancien site pour avoir des points de comparaison, puis le nouveau site sur un serveur de test protégé par login et mot de passe.
  • Pour ne rien oublier, il faut lister les URL de l’ancien site en croisant quatre sources : le crawl du site, les URL qui font des visites, celles qui reçoivent des backlinks et celles vues par Googlebot dans les logs serveur.
  • Pour chaque URL orpheline ou supprimée dans le nouveau site, il faut décider : redirection si elle a des visites ou des backlinks, recréer la page si elle a un intérêt, 404 ou 410 assumée si elle n’a aucun intérêt.
  • Le plan de redirections consiste à rediriger les urls de l’anien site vers le nouveau, page à page, sans chaîne ni boucle, et évitez la redirection fourre-tout vers la page d’accueil, surtout si ces redirections concernent des urls porteuses de trafic ou de popularité.
  • Après la bascule, on vérifie à nouveau les redirections en production, puis on surveille l’indexation, les erreurs 404, le sitemap XML et le trafic organique, en gardant le même tag analytics pour pouvoir comparer avec l’avant.

La migration d’un ancien site vers un nouveau, suite à une refonte, est une étape délicate qui peut s’avérer désastreuse si elle n’est pas gérée correctement. La prise en compte du SEO, avant et après la migration, est essentielle pour ne pas vous retrouver avec une perte de trafic difficile à récupérer.
On va détailler l’ensemble des étapes à suivre, avant, pendant et après la migration afin de ne pas perdre votre référencement.

Lire la suite

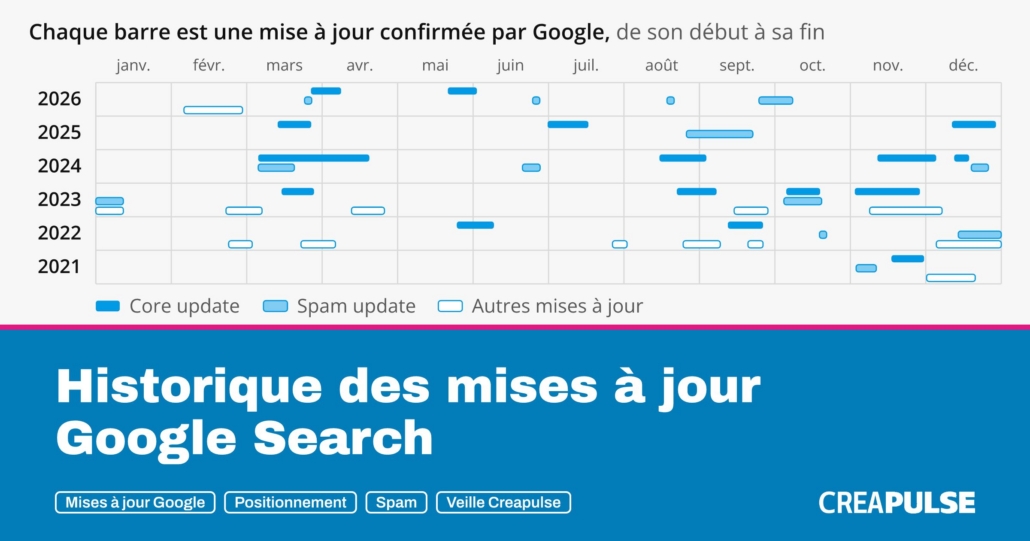
Frise des mises à jour de Google Search confirmées depuis 2021, une ligne par année : chaque barre est une mise à jour, de son début à sa fin, distinguée selon qu'il s'agit d'une core update, d'une spam update ou d'une autre mise à jour.

En bref

  • Cette page liste les mises à jour de l’algorithme de Google Search : core updates, spam updates et les autres, avec leur date de début, leur date de fin et leur durée de déploiement.
  • Les mises à jour confirmées depuis novembre 2021 viennent du tableau de bord officiel de Google, relevé une fois par jour.
  • Avant 2021, et pour les mises à jour que Google n’a jamais confirmées, c’est mon historique tenu à la main depuis 2013.
  • Une frise et un tableau filtrable permettent de retrouver ce qui se passait chez Google à une date donnée.

Au 1er novembre 2026, la dernière mise à jour confirmée par Google est la spam update de septembre 2026 : déployée du 24 septembre 2026 au 8 octobre 2026 (13 j 16 h), elle est terminée. Aucun déploiement n’est en cours. Voir l’annonce de Google

Votre trafic a décroché d’un coup, ou au contraire il s’envole sans que vous ayez touché à quoi que ce soit ? Avant de chercher plus loin, la première question à se poser est toute bête : est-ce que Google était en train de déployer une mise à jour à ce moment-là ?

C’est à ça que sert cette page. Pendant des années, je l’ai tenue à la main, mise à jour après mise à jour. Aujourd’hui elle va chercher l’information à la source : dès que Google annonce un déploiement, ou sa fin, la frise et le tableau suivent, sans que j’aie à y toucher.

Les mises à jour Google en chiffres

7
mises à jour confirmées en 2026
2 core · 4 spam · 1 autre
17 jours
de déploiement en moyenne pour une core update
sur 16 core updates depuis novembre 2021
45 jours
le déploiement le plus long
core update de mars 2024
2 juin 2026
fin de la dernière core update
core update de mai 2026

À noter que ces chiffres ne comptent que les mises à jour confirmées par Google. Les secousses que tout le monde constate dans les résultats mais que Google n’annonce pas n’y figurent pas.

La frise des mises à jour Google depuis 2021

Une ligne par année, un trait par mise à jour : sa longueur, c’est la durée du déploiement. Pour faire simple, si votre courbe de trafic change de pente pendant un de ces traits, vous tenez une piste sérieuse.

janv.févr.marsavr.maijuinjuil.aoûtsept.oct.nov.déc.202620252024202320222021Core update de novembre 2021 : du 17 nov. 2021 au 30 nov. 2021Core update de mai 2022 : du 25 mai 2022 au 9 juin 2022Core update de septembre 2022 : du 12 sept. 2022 au 26 sept. 2022Core update de mars 2023 : du 15 mars 2023 au 28 mars 2023Core update d’août 2023 : du 22 août 2023 au 7 sept. 2023Core update d’octobre 2023 : du 5 oct. 2023 au 19 oct. 2023Core update de novembre 2023 : du 2 nov. 2023 au 28 nov. 2023Core update de mars 2024 : du 5 mars 2024 au 19 avr. 2024Core update d’août 2024 : du 15 août 2024 au 3 sept. 2024Core update de novembre 2024 : du 11 nov. 2024 au 5 déc. 2024Core update de décembre 2024 : du 12 déc. 2024 au 18 déc. 2024Core update de mars 2025 : du 13 mars 2025 au 27 mars 2025Core update de juin 2025 : du 30 juin 2025 au 17 juil. 2025Core update de décembre 2025 : du 11 déc. 2025 au 29 déc. 2025Core update de mars 2026 : du 27 mars 2026 au 8 avr. 2026Core update de mai 2026 : du 21 mai 2026 au 2 juin 2026Spam update de novembre 2021 : du 3 nov. 2021 au 11 nov. 2021Spam update d’octobre 2022 : du 19 oct. 2022 au 21 oct. 2022Link spam update de décembre 2022 : du 14 déc. 2022 au 12 janv. 2023Link spam update de décembre 2022 : du 14 déc. 2022 au 12 janv. 2023Spam update d’octobre 2023 : du 4 oct. 2023 au 20 oct. 2023Spam update de mars 2024 : du 5 mars 2024 au 20 mars 2024Spam update de juin 2024 : du 20 juin 2024 au 27 juin 2024Spam update de décembre 2024 : du 19 déc. 2024 au 26 déc. 2024Spam update d’août 2025 : du 26 août 2025 au 22 sept. 2025Spam update de mars 2026 : du 24 mars 2026 au 25 mars 2026Spam update de juin 2026 : du 24 juin 2026 au 26 juin 2026Spam update d’août 2026 : du 18 août 2026 au 21 août 2026Product reviews update de décembre 2021 : du 1er déc. 2021 au 21 déc. 2021Page experience update (ordinateur) : du 22 févr. 2022 au 3 mars 2022Product reviews update de mars 2022 : du 23 mars 2022 au 6 avr. 2022Product reviews update de juillet 2022 : du 27 juil. 2022 au 2 août 2022Helpful content update d’août 2022 : du 25 août 2022 au 9 sept. 2022Product reviews update de septembre 2022 : du 20 sept. 2022 au 26 sept. 2022Helpful content update de décembre 2022 : du 5 déc. 2022 au 12 janv. 2023Helpful content update de décembre 2022 : du 5 déc. 2022 au 12 janv. 2023Product reviews update de février 2023 : du 21 févr. 2023 au 7 mars 2023Reviews update d’avril 2023 : du 12 avr. 2023 au 25 avr. 2023Helpful content update de septembre 2023 : du 14 sept. 2023 au 28 sept. 2023Reviews update de novembre 2023 : du 8 nov. 2023 au 7 déc. 2023Discover update de février 2026 : du 5 févr. 2026 au 27 févr. 2026Spam update de septembre 2026 : du 24 sept. 2026 au 8 oct. 2026Core updateSpam updateAutres mises à jourLa plus récente
Chaque trait couvre la durée de déploiement d’une mise à jour confirmée par Google. Source : Google Search Status Dashboard.

Quelles sont toutes les mises à jour confirmées par Google ?

Le tableau reprend chaque mise à jour annoncée par Google depuis novembre 2021, de la plus récente à la plus ancienne. Les boutons filtrent par famille, et la colonne « Source » mène à l’annonce d’origine.

Mise à jourTypeDébutFinDuréeSource
Spam update de septembre 2026Spam24 sept. 20268 oct. 202613 j 16 hGoogle
Spam update d’août 2026Spam18 août 202621 août 20262 j 16 hGoogle
Spam update de juin 2026Spam24 juin 202626 juin 20262 j 1 hGoogle
Core update de mai 2026Core21 mai 20262 juin 202611 j 21 hGoogle
Core update de mars 2026Core27 mars 20268 avr. 202612 j 4 hGoogle
Spam update de mars 2026Spam24 mars 202625 mars 202619 h 30Google
Discover update de février 2026Discover5 févr. 202627 févr. 202621 j 17 hGoogle
Core update de décembre 2025Core11 déc. 202529 déc. 202518 j 2 hGoogle
Spam update d’août 2025Spam26 août 202522 sept. 202526 j 15 hGoogle
Core update de juin 2025Core30 juin 202517 juil. 202516 j 18 hGoogle
Core update de mars 2025Core13 mars 202527 mars 202513 j 21 hGoogle
Spam update de décembre 2024Spam19 déc. 202426 déc. 20247 j 2 hGoogle
Core update de décembre 2024Core12 déc. 202418 déc. 20246 j 4 hGoogle
Core update de novembre 2024Core11 nov. 20245 déc. 202423 j 13 hGoogle
Core update d’août 2024Core15 août 20243 sept. 202419 j 4 hGoogle
Spam update de juin 2024Spam20 juin 202427 juin 20247 j 1 hGoogle
Spam update de mars 2024Spam5 mars 202420 mars 202414 j 21 hGoogle
Core update de mars 2024Core5 mars 202419 avr. 202445 jGoogle
Reviews update de novembre 2023Avis8 nov. 20237 déc. 202329 jGoogle
Core update de novembre 2023Core2 nov. 202328 nov. 202325 j 21 hGoogle
Core update d’octobre 2023Core5 oct. 202319 oct. 202313 j 23 hGoogle
Spam update d’octobre 2023Spam4 oct. 202320 oct. 202315 j 12 hGoogle
Helpful content update de septembre 2023Helpful content14 sept. 202328 sept. 202313 j 11 hGoogle
Core update d’août 2023Core22 août 20237 sept. 202316 j 3 hGoogle
Reviews update d’avril 2023Avis12 avr. 202325 avr. 202313 j 2 hGoogle
Core update de mars 2023Core15 mars 202328 mars 202313 j 7 hGoogle
Product reviews update de février 2023Avis21 févr. 20237 mars 202314 jGoogle
Link spam update de décembre 2022Spam (liens)14 déc. 202212 janv. 202329 jGoogle
Helpful content update de décembre 2022Helpful content5 déc. 202212 janv. 202338 jGoogle
Spam update d’octobre 2022Spam19 oct. 202221 oct. 20222 jGoogle
Product reviews update de septembre 2022Avis20 sept. 202226 sept. 20226 jGoogle
Core update de septembre 2022Core12 sept. 202226 sept. 202214 jGoogle
Helpful content update d’août 2022Helpful content25 août 20229 sept. 202215 jGoogle
Product reviews update de juillet 2022Avis27 juil. 20222 août 20226 jGoogle
Core update de mai 2022Core25 mai 20229 juin 202215 jGoogle
Product reviews update de mars 2022Avis23 mars 20226 avr. 202214 jGoogle
Page experience update (ordinateur)Expérience de page22 févr. 20223 mars 20229 jGoogle
Product reviews update de décembre 2021Avis1er déc. 202121 déc. 202120 jGoogle
Core update de novembre 2021Core17 nov. 202130 nov. 202113 jGoogle
Spam update de novembre 2021Spam3 nov. 202111 nov. 20218 j 1 hGoogle

Core update, spam update : c'est quoi la différence ?

Toutes les mises à jour ne font pas le même travail, et on ne réagit pas de la même façon selon la famille. En gros :

  • Core update : Google revoit en profondeur ses systèmes de classement. Aucun site n’est visé en particulier, c’est l’évaluation de tous les contenus qui est refaite. C’est celle qui fait bouger le plus de sites à la fois.
  • Spam update : Google améliore ses systèmes de détection du spam. Elle touche les sites qui enfreignent ses règles, pas la qualité des contenus en général.
  • Link spam update : la même logique, appliquée aux liens artificiels.
  • Helpful content update : le système qui repérait les contenus écrits pour les moteurs plutôt que pour les lecteurs. Depuis mars 2024, il est intégré aux core updates et n’a plus de mise à jour à son nom.
  • Reviews update (d’abord « product reviews ») : l’évaluation des tests et des avis de produits. Depuis fin 2023, Google met ce système à jour en continu et ne l’annonce plus.
  • Discover update : elle porte sur les systèmes qui font remonter les articles dans Discover.

Les définitions officielles sont chez Google : core updates et spam updates.

L'historique commenté, année par année

Ici, c’est la partie tenue à la main : ce que j’ai noté au fil des années sur chaque mise à jour, des Panda et Penguin de 2013 jusqu’aux core updates récentes. Pour les mises à jour confirmées depuis novembre 2021, les dates sont celles de Google ; avant, ce sont celles que j’avais relevées à l’époque. Une mise à jour « non confirmée », c’est un mouvement que les outils de suivi ont détecté sans que Google l’annonce.

Les mises à jour Google de 2025

  • Spam update d’août 2025 (du 26 août 2025 au 22 sept. 2025) : Grosse mise a jour spam
  • Core update de juin 2025 (du 30 juin 2025 au 17 juil. 2025) : Il a été constaté une volatilité accrue dans les SERPs (pages de résultats), des fluctuations importantes sur les mots-clés concurrentiels ainsi que des mouvements significatifs dans les secteurs YMYL (Your Money Your Life)
  • Core update de mars 2025 (du 13 mars 2025 au 27 mars 2025) : La Google Core Update de mars 2025 a engendré des changements très nets au sein des résultats de recherche, modifiant profondément les positions de nombreux sites.

Les mises à jour Google de 2024

  • Spam update de décembre 2024 (du 19 déc. 2024 au 26 déc. 2024) : Mise à jour concernant le spam update
  • Core update de décembre 2024 (du 12 déc. 2024 au 18 déc. 2024) : Mise à jour qui annule les effets d’amélioration constatés sur certains sites depuis la November Core Update
  • Core update de novembre 2024 (du 11 nov. 2024 au 5 déc. 2024) : 3eme grosse mise a jour de l’algorithme de l’année. Cette mise à jour visait à améliorer la qualité des résultats de recherche en promouvant les contenus utiles et en pénalisant les abus de réputation de site (SRA), affectant le classement de certains sites et nécessitant des ajustements.
  • Core update d’août 2024 (du 15 août 2024 au 3 sept. 2024) : Cette mise à jour est une continuité du travail cherchant à améliorer la qualité des résultats de recherche.
  • Spam update de juin 2024 (du 20 juin 2024 au 27 juin 2024) : but d’améliorer la qualité des résultats de recherche en ciblant les sites Web qui violent les politiques anti-spam de l’entreprise
  • 5 mai 2024 — Mise à jour Reputation Abuse Update : cette mise à jour cible en priorité les sites de presse qui jouent de leur autorité pour se positionner sur des sujets pour lesquels ils ne sont pas légitimes
  • Core update de mars 2024 (du 5 mars 2024 au 19 avr. 2024) : L’objectif est d’améliorer la qualité de la recherche en affichant moins de contenu qui semble avoir été conçu pour générer des clics, et plus de contenu que les internautes trouvent utile. Nouvelles regles concernant le spam- la mise à jour à eu une durée de 45 jours.

Les mises à jour Google de 2023

  • Reviews update de novembre 2023 (du 8 nov. 2023 au 7 déc. 2023) : Mise à jour qui cible en priorité les listicles et articles de test de produits et logiciels.
  • Core update de novembre 2023 (du 2 nov. 2023 au 28 nov. 2023) : Mise à jour qui recompense le contenu de qualité produit par les sites avec une réelle expérience « first-hand » sur les sujets traités
  • Spam update d’octobre 2023 (du 4 oct. 2023 au 20 oct. 2023) : Mise à jour concernant le spam
  • Core update d’août 2023 (du 22 août 2023 au 7 sept. 2023) : Mise à jour confirmée par google, d’un deploiement de 2 semaines. Mise à jour plus perfomante que celle de mars
  • Core update de mars 2023 (du 15 mars 2023 au 28 mars 2023) : Mise à jour concernant le classement de la recherche
  • Product reviews update de février 2023 (du 21 févr. 2023 au 7 mars 2023) : Mise à jour concernant les langues disponibles ((le français, l’anglais, l’allemand, l’espagnol, l’italien, le portugais, le russe, l’indonésien, le néerlandais, le polonais et le vietnamien)

Les mises à jour Google de 2022

  • Link spam update de décembre 2022 (du 14 déc. 2022 au 12 janv. 2023) : Mise à jour permettant de nettoyer des backling generés par des sites à faible notoriéte.
  • Spam update d’octobre 2022 (du 19 oct. 2022 au 21 oct. 2022) : Mise à jour dont le but est de sanctionner les techniques de référencement qui vont à l’encontre d’une bonne expérience utilisateur.
  • Product reviews update de septembre 2022 (du 20 sept. 2022 au 26 sept. 2022) : Mise à jour confirmée par google, 2eme partie de la mise à jour de juillet, concernant aux avis pour les produits de mauvaise qualité.
  • Core update de septembre 2022 (du 12 sept. 2022 au 26 sept. 2022) : Mise à jour confirmée par google afin de renforcer le signal de contenu utile
  • Helpful content update d’août 2022 (du 25 août 2022 au 9 sept. 2022) : Mise à jour confirmée par Google afin de récompenser les contenus rédigés pour les internautes et déclasser les contenus rédigés exclusivement pour les moteurs de recherche.
  • Product reviews update de juillet 2022 (du 27 juil. 2022 au 2 août 2022) : Mise à jour confirmée par google concernant l’intégralité des résultats de ses recherche organiques
  • Core update de mai 2022 (du 25 mai 2022 au 9 juin 2022) : Google a confirmé la mise à jour noyau may 2022 qui vise à fournir des resultats plus pertinents et à mieux lutter contre le spam
  • 18 mars 2022 — Mise à jour non confirmée Spring 2022 : Mise à jour non confirmée par Google "Spring 2022"

Les mises à jour Google de 2021

  • Core update de novembre 2021 (du 17 nov. 2021 au 30 nov. 2021) : Google a confirmé cette mise à jour du noyau de l’algorithme. Cette Core Updates à un impact sur le positionnement en résultat de recherche de nombreux sites web.
  • 16 septembre 2021 — Mise à jour non confirmée : Mise à jour non confirmée par Google
  • 26 juillet 2021 — Mise à jour link spam update : Google confirme que : "Cette mise à jour de l’algorithme,est encore plus efficace pour identifier et annuler le spam de liens plus largement, dans plusieurs langues. Les sites participant au spam de liens verront des changements dans la recherche au fur et à mesure que ces liens seront réévalués par nos algorithmes », a écrit Google.
  • 23 juin 2021 — Mise à jour confirmée spam : Google a confirmé sa mise à jour sur les spam du 23 et 28 juin
  • 2 juin 2021 — Mise à jour Noyau June : Google confirme que : "Nous avons apporté plusieurs améliorations au rapport "Expérience sur la page". Nous avons, supprimé du rapport les widgets "Navigation sécurisée" et "Expérience publicitaire", clarifié le fait que la navigation sécurisée n’est pas utilisée comme signal de classement. Les systèmes de navigation sécurisée continuent de jouer un rôle important pour assurer la sécurité des utilisateurs de la recherche Google.
  • 19 mai 2021 — Mise à jour non confirmée : Mise à jour sur les classements qui a entraîné un changement important sur le classement de nombreux sites, non confirmée par Google.
  • 9 avril 2021 — Mise à jour classement des evaluations de produits : Mise à jour de l’algorithme concernant l’affichage des avis/produits/evaluations dans les pages de resultats google, en ciblant les avis d’experts et des personnes qui ont utilisé le produit au lieu de cibler la quantité des avis.

Les mises à jour Google de 2020

  • 3 décembre 2020 — Mise à jour December 2020 : Mise à jour majeure "decembre 2020" , le top 4 des sites les plus touchés positivement sont la culture et les arts, demenagement, finance, science et eduction. Les domaines les plus impactés positivement sont Ebay, Facebook, Linkedin et Youtube.
  • 15 août 2020 — Mise à jour non confirmée : Mise à jour sur le ranking, apparamment temporaire.
  • 10 août 2020 — Mise à jour Glitch Google : Mise à jour confirmée afin de corriger des bugs liées aux resultats de recherches et à l’indexation
  • 22 juin 2020 — Mise à jour Bug Google : Mise à jour non confirmée afin de corriger des bugs d’indexation
  • 4 mai 2020 — Mise a jour Core May : Evolution algorithmique importante pour google, qui a impactée beaucoup de sites surtout pour les domaines de la santé, immobilier, voyages.
  • 11 février 2020 — Mise à jour non confirmée : Mise à jour sur les classements qui a entraîné un changement important sur le classement de nombreux sites, non confirmée par Google.
  • 13 janvier 2020 — Mise à jour majeure : Mise à jour faisant suite à Bert (25/10/19), sur le champ lexical. Elle a modifié le classement dans les Serp.

Les mises à jour Google de 2019

  • 7 novembre 2019 — Mise à jour November Update : Google nous explique qu’il s’agit d’une intelligence artificielle avec correspondance neuronale qui permet de mieux comprendre comment un mot est relié à un concept. Dorénavant, les résultats locaux et les listes Google my business peuvent s’afficher sur des requêtes qui ne correspondent pas exactement à la marque mais dont l’intention de recherche correspond.
  • 25 octobre 2019 — Mise à jour Bert : Evolution algorithmique majeure pour google search, une des plus importantes de ces 5 derniéres années. Elle a impactée 10% des recherches. Permet à Google de de comprendre les requêtes d’une maniére plus "humaine". Elle permet de considérer le contexte complet d’un mot en regardant les mots qui le précèdent et le suivent.
  • 24 septembre 2019 — Mise à jour non nommée : Google introduit deux nouveaux attributs pour les liens sortants, qui modifient la façon dont les robots de Google vont traiter les liens en nofollow.
  • 6 juin 2019 — mise à jour majeure : mise à jour majeure concernant le classement des résultats de recherche
  • 5 avril 2019 — Correction du bug de l’index Google : Mise à jour corrective concernant un bug de l’index de recherche.
  • 12 mars 2019 — Mise à jour Florida 2 : Nommée florida 2 par les webmasters en référence à Florida mise à jour survenue en decembre2003, semble etre la suite de la mise à jour Medic.
  • 1er mars 2019 — Mise à jour des extraits enrichis : Mise à jour concernant les resultats de recherches approfondies des extraits enrichis "snippets"
  • 6 février 2019 — Mise à jour non confimée : Les signes de la mise à jour proviennent surtout du Royaume Uni, confirmé par tous les outils

Les mises à jour Google de 2018

  • 29 novembre 2018 — Nouvelle augmentation des résultats sur Google : Augmentation significative du serp
  • 15 octobre 2018 — Augmentation de l’index Google : mise à jour google search non confirmée, augmentation du serp jusqu’a 9.3 pour Sem Rush (taux le plus haut jusqu’a ce jour)
  • 10 septembre 2018 — Mise à jour non nommée : Pas de confirmation de Google
  • 1er août 2018 — Mise à jour Medic : Google confirme la mise à jour du cœur de l’algorithme avec de gros impacts. Il s’est déroulé sur une semaine, avec une pointe les 2 premiers jours d’août. Il a particulièrement impacté le secteur médical / santé / bien être mais pas uniquement.
  • 24 juillet 2018 — Mise à jour Avertissements de securité Chrome : Apres avoir averti les utilisateurs de sites non https plusieurs mois auparavant via la console de recherche et par mail, chrome 68 a commencé à marquer les sites non https comme non sécurisés.
  • 21 juillet 2018 — Mise à jour non confirmée : Les outils de suivis d’algorithme ont signalés un changement important dans le classement des résultats, mais Google n’a pas confirmé.
  • 9 juillet 2018 — Mise à jour Speed update : Google a déployé la mise à jour sur la vitesse des pages mobiles, faisant de la vitesse un critère de classement majeur des résultats sur mobile.
  • 14 juin 2018 — Mise à jour Carrousel : Google a déplacé les résultats vidéos de type organique dans un carrousel de vidéos dédiés, ce qui a bouleversé le classement des résultats (SERPS). Dans le même temps le nombre de vignettes vidéos a considérablement diminué au profit des caroussels vidéos
  • 23 mai 2018 — Mise à jour non confirmée : Les outils de suivi des résultats Google ont montré de grosses variations sur 3 jours (pic le 23/05) mais Google n’a pas confirmé la mise à jour.
  • 13 mai 2018 — Mise à jour meta description : Apres avoir testé des longueurs d’affichage des méta description de + de 300 caractères, Google les a ramenés à la limite précédente (150-160 caractères).
  • 27 avril 2018 — Mise à jour non nommée : Changement d’algorithme lourd avec un pic le 17/04 et qui s’est poursuivi pendant plus d’une semaine. Google a confirmé une mise a jour majeure mais n’a pas donné plus de détails, ni ne l’a nommé.
  • 26 mars 2018 — Mise à jour deploiement de l’Index Mobile First : Confirmation de Google que le premier index pour mobile a été déployé. L’index mobile remplace donc l’index basé jusqu’à maintenant sur la version ordinateur d’un site. Les critères de classement sont basés sur la version mobile d’un site.
  • 14 mars 2018 — Test: Résultats en position 0 : Sur des requêtes heures/dates et des calculatrices de conversions d’unités, Google à commencer à afficher des résultats organiques en position zéro et un "afficher tout les résultats".
  • 8 mars 2018 — Mise à jour brackets : Google a confirmé une mise à jour du noyau de l’algorithme le 7 mars, mais les changements dans les pages de résultats sont apparus dés le 04/03, avec un 2eme pic le 08/03 et s’est poursuivi pendant 2 semaines. Soit c’était une mise à jour continue ou alors plusieurs d’affilées. Google n’a pas fourni plus de détails.
  • 20 février 2018 — Mise à jour non nommée : Les classements ont montré de gros changements de positions (à travers un certain nombre d’outils) vers le 20/02, qui s’est rapidement stabilisé montrant que l’algorithme a eu une mise à jour ciblée.Google n’as rien confirmé.

Les mises à jour Google de 2017

  • 14 décembre 2017 — Mise à jour maccabees : Les sites touchés sont surtout ceux utilisant des pages satelittes (pages artificielles crées uniquement pour les moteurs), les sites qui multiplient les pages très similaires pour se positionner sur des multitudes de requetes, et aussi des sites déja touchés par FRED, c.a.d des sites avec du contenu de mauvaise qualité ou avec bcp de publicité, liens affiliés.
  • 30 novembre 2017 — Mise à jour taille des méta description : Après avoir testé des extraits enrichis plus longs, Google les affiche sur un plus grand nombre de résultats. Cela a conduit à adopter une nouvelle limite de méta description jusqu’à 300 caractères (au lieu des 150 précédents).
  • 14 novembre 2017 — Mise à jour non nommée : Ceux qui suivent les changements d’algorithme ont détectés de gros changements dans le classement des résultats autour du 15/11. Google n’a pas confirmé la mise à jour.
  • 27 octobre 2017 — Mise à jour baisses des extraits enrichis : Du 27 au 31 octobre, il y a une baisse substantielle du nombre d’extraits enrichis (featured snippets) qui a coïncidé avec une augmentation du knowledgegraph. Pour certaines requêtes génériques, Google a remplacé les extraits enrichis par ces blocs du knowledgegraph
  • 17 octobre 2017 — Mise à jour securité Chrome : Avec le lancement de Chrome 62 , Google à commencé à informer les sites non sécurisés. Bien qu’il ne s’agisse pas d’une mise à jour de l’algorithme il s’agit d’une étape importante de Google vers le https.
  • 27 septembre 2017 — Mise à jour non nommée : Webmasteurs et référencdeurs ont constaté des changements dans SERPS vers le 25/09, avec un pic le 27. Aucune mise à jour n’a été confirmé
  • 20 juin 2017 — Lancement de Google Jobs : Google lance officiellement son portail d’offres d’emploi, incluant dans la recherche 3 offres d’emploi indépendantes. Les données sont collectées notamment depuis Linkedin, Monster, Glassdor, et Career builder
  • 17 mai 2017 — Mise à jour non nommée : Changements dans les classements sur plusieurs jours débutant le 09/05. Certains consultants comme Glenn Gabe y voient une mise à jour en rapport avec les critères de qualité de Google.
  • 16 avril 2017 — Mise à jour HTTPS : La moitié des résultats organiques en page 1 étaient sécurisés https à la mi avril. Ce chiffre a augmenté de 75% fin 2017.
  • 8 mars 2017 — Mise à jour FRED : Mise à jour majeure avec de gros impacts pour le Référencement, notamment pour lutter contre le Spam : les sites de mauvaises qualité et privilégiant les contenus publicitaires sont sanctionnés.
  • 10 février 2017 — Penalités pour interstitiels intrusifs : Google a commencé à appliquer des pénalités pour les interstitiels intrusifs et les pops up qui nuisent à l’expérience mobile avec l’avertissement de cette mise à jour 5 mois à l’avance. Changements entre le 10 et le 11/02 (mais de nombreux referenceurs ont détectés un impact minimal).
  • 6 février 2017 — Mise à jour confirmée : Les changements d’algorithme qui ont commencé le 01/02 se sont poursuivis pendant une semaine complète, culminant le 06/02 . Les spécialistes s’accordent sur une mise à jour en rapport avec la qualité des contenus.

Les mises à jour Google de 2016

  • 14 décembre 2016 — Mise à jour non nommée : Plusieurs référenceurs ont montré de gros changements le 14/15 décembre. Google n’as pas confirmé de mise à jour
  • 10 novembre 2016 — Mise à jour non nommée : Pic important le 10/11 et un autre le 18/11. Les webmasters n’étaient pas d’accord à savoir si la 1ere mise à jour était une prémice de la 2eme.Google n’a pas confirmé la mise à jour.
  • 6 octobre 2016 — Mise à jour Penguin 4.0 phase 2 : La 2eme phase de Penguin est un retour en arrière (rollback) des précédentes mises à jour. L’activité post Penguin a eu un dernier pic le 06/11, mais il n’est pas clair s’il s’agissait de Pinguin ou d’une nouvelle mise à jour. Les variations des résultats ont baissé après le 06/10.
  • 27 septembre 2016 — Mise à jour Penguin 4.0 phase 1 : Lancée vers le 22-23/09, ce déploiement plus doux de Penguin dévalue les mauvais liens au lieu de pénaliser les sites. La mise à jour de Penguin a pris plusieurs jours avant son déploiement complet (pic le 27/09).
  • 23 septembre 2016 — Mise à jour Penguin 4 : Mise à jour majeure de Penguin en version 4. Il est maintenant intégré au coeur de l’algorithme et mis à jour en temps réel. Pénalise les sites avec des liens non naturels, avec des ancres de liens sur-optimisés,…
  • 13 septembre 2016 — Mise à jour Image/Universel : On enregistre une chute de 50% des SERP avec images et issus de la recherche universelle (images, vidéos, maps,..). Le changement des résultats de recherche universelle ont provoqué d’importants changement de classement, ce qui faisait surement parti d’une mise à jour beaucoup plus grande.
  • 1er septembre 2016 — Mise à jour Possum : La communauté SEO a enregistré un changement majeur des résultats locaux: la zone de recherche est élargie, les entreprises avec la même adresse sont dédupliquées, l’ordre de saisie des mots clés a plus d’importance, les résultats locaux ne sont pas seulement en haut de page mais en milieu de page par exemple.
  • 12 mai 2016 — Mise à jour mobile friendly 2 : 1 an après la mise à jour mobile initiale, mobilegeddon, Google a lancé une nouvelle version qui vient renforcer le positionnement des sites compatibles avec la recherche mobile.
  • 10 mai 2016 — Mise à jour non nommée : Plusieurs outils SEO ont montré un changement d’algorithme mais Google n’a pas confirmé.
  • 23 février 2016 — Mise à jour Adwords : Grosse mise a jour de Google adwords puisque la barre liens sponsorisés à droite disparait et la possibilité de voir 4 liens adwords en haut des pages de résultats de Google pour certaines requêtes concurentielles. Ca signifie aussi des résultats naturels qui descendent plus bas dans les serps. Sur mobile, l’impact est encore plus grand car plus de place accordée aux pubs adwords au dessus de la ligne de flottaison.
  • 8 janvier 2016 — Mise à jour non nommée : Plusieurs outils de suivis de l’algorithme ont enregistré un mouvement historique important, Google a confirmé une mise à jour majeure mais en précisant que celle ci ne faisait pas parti de Pingouin.

Les mises à jour Google de 2015

  • 22 décembre 2015 — Extension de Google Pigeon : Extension de Pigeon, affectant les résultats locaux, au Canada, Royaume Uni et Australie.La mise à jour originale date de juillet 2014 aux Etats Unis.
  • 26 octobre 2015 — Annonce de RankBrain : Google annonce que l’apprentissage automatique (machine learning) est en place depuis plusieurs mois. Son nom est Rank Brain et fait parti de l’algorihtme de Google appelé HummingBird (Colibri). Son rôle est notamment d’interpréter les requêtes des internautes et de renvoyer des pages qui ne contiennet pas forcément les expressions recherchées, surtout pour la longue traine. RankBrain est le 3eme facteur de classement le plus influent. Le premier facteur étant les liens (internes et backlinks). Le second est le contenu
  • 17 juillet 2015 — Panda 4.2 : Mise à jour ou plus exactement rafraichissement de Panda en version 4.2 qui se déploie sur plusieurs mois. Les mêmes signaux que la précédente version sont appliqués. Il affecte 2-3% des requêtes contre 3-5% pour la version précédente.
  • 3 mai 2015 — Mise à jour qualité : Aprés de nombreux rapports faisant état de changements (Phantom2), Google a reconnu qu’un changement d’algorithme majeure a eu une incidence sur les signaux de qualité, mais Google n’a pas revelé plus de détails. D’après certaines études, les signaux de qualité concernent la qualité des contenus et qualité de l’expérience utilisateur
  • 22 avril 2015 — Mise à jour Mobile Mobilegeddon : Google a annoncé cette mise à jour de l’algorithme en avance, indiquant qu’ à partir du 21 avril il différenciera les classements pour les sites compatibles mobiles et non mobile. L’impact de cette mise à jour a été plus faible que prevu.
  • 4 février 2015 — Mise à jour non nommée : Google n’a pas confirmé cette mise à jour, les avis divergent à savoir si elle a concerné panda ou Pingouin.

Les mises à jour Google de 2014

  • 21 décembre 2014 — Mise à jour Pirate 2.0 : 2 ans après la mise à jour Pirate d’origine, Google a lancé une nouvelle mise à jour pour lutter contre le piratage de logiciels et supports numériques. Il pénalise notamment les sites de téléchargements ilégaux, torrents, etc…
  • 10 décembre 2014 — Mise à jour continue de Penguin : Annonce de la mise à jour en continue de Pingouin plutot que ponctuellement à des dates précises. Penguin pénalise les liens entrants artificiels.
  • 17 octobre 2014 — Mise à jour Pingouin 3.0 : Google a lancé une mise à jour de Penguin qui retrograde les sites qui ont des liens entrants de mauvaise qualité, cette mise à jour s’est étalée sur plusieurs semaines.
  • 1er octobre 2014 — Mise a jour Google Actualités : Changement d’affichage dans Google Actualités, la box "dans l’actualié" étend ses résultats au déla des sites médias traditionnels. les principaux sites d’informations on fait face à des importants changement de trafic.
  • 23 septembre 2014 — Panda 4.1 : Goolge Panda qui pénalise notamment le contenu dupliqué passe en version 4.1. C’est une mise à jour lente qui se déploi sur plusieurs mois et qui affecte 3-5 des requêtes
  • 28 août 2014 — Fin de l’Autorship : balisage de l’auteur : Google annonce qu’il supprime la prise en compte de balisage de l’auteur (Rel=Author)
  • 24 juillet 2014 — Mise à jour Pigeon : Mise à jour qui a bouleversé les resultats locaux et la maniére dont les signaux de localisations sont traités. Pigeon améliore notamment la précision des résultats en fontion de la distance et de la localisation de l’internaute
  • 28 juin 2014 — Mise à jour Authorship : Google a annoncé le 25/06 que Google supprimerait toutes les photos d’auteurs des serps, ca a pris fin le 28/06.
  • 12 juin 2014 — Mise à jour Payday version 3.0 : cette version concerne les requetes spammées, elle vient un mois a peine apres la precente mise a jour qui concernait le contenu spammy.
  • 8 juin 2014 — Mise à jour HTTPS/SSL : Google annonce qu’il donne la préference aux sites securisés, et ajoute que le HTTPS donnera un coup de fouet au classement.
  • 19 mai 2014 — Mise à jour panda 4.0 : Mise à jour majeure de l’algorithme et atualisation des données. Environ 7.5% des recherches en anglais ont été touchés
  • 16 mai 2014 — payday loan 2.0 : Mise à jour Payday qui pénalise les sites utilisant des requetes considérées comme spammy par Google. Des requêtes souvent utilisées par les spammers comme des requêtes pornographiques par exemple
  • 24 mars 2014 — Mise à jour non nommée : de nombreux sites ont signalés des changements de classements. Certains référenceurs ont supposé qu’une sorte de nouveau Panda soft était sorti mais Google n’a jamais confirmé cette mise à jour.
  • 6 février 2014 — Google pénalise trop de publicités : Google a actualisé son algorithme nommé "top heavy", datant de 2012 et qui pénalise les sites avec trop de publicités au dessus de la ligne de flottaison (ce qui est affiché au dessus du scroll)

Les mises à jour Google de 2013

  • 19 décembre 2013 — Google réduit l’affichage de l’authorship dans les résultats : En 1 mois, 15% des requêtes n’affichent l’auteur dans les résultats Google pour les pages ayant inséré les balises auteurs
  • 17 décembre 2013 — Mise à jour non nommée : Il a été enregistrée une activité trés importante,mais Google n’a pas confirmé une mise à jour.
  • 14 novembre 2013 — Mise à jour non nommée : Il a été enregistrée une activité trés importante,mais Google n’a pas confirmé une mise à jour.
  • 4 octobre 2013 — Penguin 2.1 : 4 mois et demi plus tard, Google lance une nouvelle mise à jour de Pingouin qui n’est pas une mise à jour majeure mais juste uen actualisation des données.
  • 20 août 2013 — Mise à jour Hummimbird : Google Humming permet de mieux comprendre les requêtes longue traîne et notamment la recherche conversationnelle, celle qu’on utilise en recherche vocale notamment. Cet algorithme basé sur la recherche sémantique permet de comprendre l’intention de recherche derrière les mots clés.
  • 6 août 2013 — In depth Articles (articles de fond) : Google ajoute un nouveau type d’actualités appellé "articles de fond" qui tend à mettre en avant les articles avec beaucoup de contenu et qui ont vocation à perdurer sur le long terme (evergreen). Pour 3% des requêtes, Google affiche un bloc de 3 résultats vers des articles de fond
  • 26 juillet 2013 — Mise à jour non nommée : N’a pas été confirmé par Google
  • 19 juillet 2013 — Mise à jour Expansion du knowledgeGraph : Les résultats Google affichant le knowledgeGraph (bloc d’informations sémantiques sur la colonne droite du moteur de recherche) ont progressé de plus de la moitié.
  • 18 juillet 2013 — Mise à jour Panda : Mise à jour qui a attenué certaines penalités ultérieures de Panda.
  • 11 juin 2013 — Mise à jour payday : Les requêtes dites spammy par Google ont été etendues de plus de la moitié.
  • 11 juin 2013 — Panda dance : Ce n’est pas une mise à jour Panda mais Matt Cutts a annoncé au SMX que Panda faisait des mises à jour tous les mois et qu’elles duraient pendant une dizaine de jours.
  • 22 mai 2013 — Penguin 2.0 : 4eme mise à jour de Pingouin avec un impact modérée,ciblée au niveau de la page.
  • 9 mai 2013 — Mise à jour Phantom : De nombreuses pertes de trafic ont été constatées sans avoir plus de détails sur la nature de cette mise à jour, d’où le nom de "phantom".
  • 14 mars 2013 — Mise à jour Panda 25 : Matt Cuts annonce la mise à jour Panda, en suggérant que ce serait surement la dernière avant son intégration dans l’algorithme. On verra que c’était pas vraiment le cas et que c’est intervenu plus tard.
  • 22 janvier 2013 — Mise à jour Panda 24 : Google annonce la première mise à jour panda de 2013, impactant 1,2% des requêtes. Panda pénalise principalement les sites comportant du contenu dupliqué

D'où viennent ces données ?

Les mises à jour confirmées viennent du Google Search Status Dashboard, le tableau de bord sur lequel Google annonce le début et la fin de chaque déploiement. La page le consulte une fois par jour.

Deux limites, autant les dire. Ce tableau de bord ne remonte qu’à novembre 2021 : tout ce qui précède vient de mon historique. Et Google n’y annonce que ce qu’il veut bien confirmer, les mouvements non confirmés n’y sont pas.

Les dates sont données à l’heure de Paris. Google publie les siennes à l’heure de la Californie : un déploiement lancé en fin de journée là-bas tombe le lendemain ici.

Questions fréquentes

Google annonce-t-il toutes ses mises à jour ?

Non. Google modifie ses systèmes en continu et n’annonce que les changements qu’il juge notables. Il arrive donc que les positions bougent sans aucune annonce : c’est ce qu’on appelle une mise à jour non confirmée.

Mon trafic a chuté pendant une core update : que faire ?

Bon, d’abord : on ne touche à rien tant que le déploiement n’est pas terminé, les positions peuvent encore bouger. Ensuite on regarde dans la Search Console quelles pages et quelles requêtes ont perdu, en comparant avant et après. Une core update ne sanctionne pas une faute technique : elle réévalue les contenus les uns par rapport aux autres.

Combien de temps dure le déploiement d'une mise à jour ?

Ça dépend de la famille : quelques heures pour certaines spam updates, plusieurs semaines pour une core update. Les durées exactes sont dans le tableau, et la moyenne des core updates est recalculée en haut de page.

La boucle de pilotage d'une actualité : publier, mesurer, segmenter, ajuster

En bref

  • Google Actualités ne prend plus de candidature : depuis avril 2024, il repère seul les sites d’actualité. Pour y entrer, un site doit respecter les règles de Google Actualités (dates et auteurs visibles, transparence, contenu original, titres honnêtes) et fournir un sitemap News à jour.
  • Le classement repose sur six facteurs officiels : pertinence du contenu, proéminence, fiabilité, actualisation, facilité d’utilisation, zone géographique et langue. Sur une actualité, l’actualisation fait la différence au départ, puis les clics et les articles les plus complets prennent le relais.
  • Le balisage NewsArticle n’est pas obligatoire, mais Google Actualités lit ses dates, son titre, son image et sa page d’auteur. Ces dates doivent dire la même chose que la page et le sitemap News : une date incohérente fait paraître l’article plus vieux qu’il n’est.
  • Pour les images, visez 1200 px de large au minimum en 16:9, avec des variantes 4:3 et 1:1, et autorisez max-image-preview:large. C’est le seuil de Discover pour les grandes images, et cela couvre le carrousel « À la une » et Google Actualités.
  • Un nosnippet ou un max-snippet trop restrictif peut écarter vos articles des carrousels et des fonctionnalités IA de Google. Pour mesurer, Search Console donne les impressions et les clics heure par heure : détectez à H+1, confirmez à H+24. GA4 dit ensuite ce que le lecteur fait après le clic.

Pour tout site éditorial, la présence sur Google actualités est un enjeu, pour certains ça peut même représenter plus de la moitié de leur trafic. Mais ce n’est pas évident pour plusieurs raisons: concurrence féroce, critères d’éligibilité peu transparents et trouver des infos claires est compliqué. A travers ce guide SEO complet, vous apprendrez à optimiser votre site sur Google News.

Lire la suite
Graphique du crawl quotidien de Googlebot relevé par analyse de logs : le crawl inutile écrase le crawl utile.

En bref

  • Les logs sont des fichiers du serveur du site web qui enregistrent chaque visite, celle de Googlebot comme celle des internautes, avec la date, l’url, le referrer, le code réponse et le poids de la page.
  • En SEO, l’analyse de logs montre ce que Google voit vraiment du site, à quelle fréquence et pour quelle efficacité en visites, ce qu’aucun autre outil ne permet de voir aussi précisément.
  • Les logs ne prennent tout leur sens qu’une fois croisés avec un crawl du site et segmentés par groupes de pages : un chiffre isolé ne dit rien, c’est le rapprochement qui donne le sens.
  • Nettoyer le crawl gaspillé sur des pages inutiles (dupliquées, orphelines, en erreur) puis orienter Googlebot vers les pages stratégiques est un levier mécanique : plus de crawl utile, plus de pages indexées, plus de visites.
  • Un log peut être structuré, semi-structuré ou non structuré, et le parser, le normaliser et l’enrichir facilite le croisement avec d’autres données ; pour un audit, on peut se contenter de logs filtrés Google, compressés.

Je parle souvent de l’intérêt de l’analyse de logs en SEO et j’avais pas pris le temps encore d’en faire un article tant le sujet peut être long et complexe à résumer dans un seul article. Je vais ici tenter d’expliquer les informations qu’on peut en extraire en analysant ces données et surtout en les croisant avec d’autres. Comme à mon habitude, je vais essayer de vulgariser au maximum mais si certains termes techniques vous échappent, je vous invite à lire les définitions autour du crawl en SEO.

Lire la suite

Je ne vais pas ici faire une liste de définitions SEO exhaustives, ce serait trop long, sans doute ennuyeux pour les non débutants et il y a bien d’autres articles qui le font très bien. Je vais  plutôt essayer de réaliser un lexique de termes utilisés dans des techniques SEO avancé d’analyse de crawl et de logs pour lesquels il est difficile de trouver des définitions. Il s’agit notamment de jargon de quelques experts utilisés surtout dans le cadre d’analyse de logs et d’analyse de crawl.

Le crawl depuis un moteur de recherche est l’étape n°1 (ou presque) pour amener du trafic organique: pas de crawl > pas d’indexation > pas de visites. Son optimisation représente un gros levier de croissance notamment sur de gros sites et aussi sur des sites moyens (>1000 pages) Lire la suite

Schéma du multi-PageRank sculpting : maillage structurel, maillage sémantique et architecture utilisateur créent un déséquilibre volontaire au profit des pages qui font explorer, du trafic et convertir.

En bref

  • Le maillage interne consiste à déséquilibrer volontairement la structure d’un site pour faire transiter les PageRanks (traditionnel, utilisateur, sémantique, fraîcheur) vers les pages stratégiques : celles qui font découvrir d’autres pages, générer du trafic, de la visibilité ou convertir.
  • Une page ne perd pas son PageRank en faisant des liens, elle le redistribue entre tous ses liens sortants : plus il y en a, moins chacun transmet. Le rel="nofollow" ne permet plus de récupérer ce jus, et sponsored et ugc servent seulement à qualifier un lien. Attention, la transmission du jus n’est pas linéaire cependant.
  • Côté structure, on réduit la profondeur des pages stratégiques (repère de terrain : moins de 3 clics de l’accueil), on repère les pages orphelines et on supprime ou masque les liens vers les pages inutiles. Les ratios entre crawl, PageRank interne et visites indiquent les pages à pousser.
  • Côté sémantique, on relie les pages d’un même univers (silo, pilier et satellites, cocon) en limitant les liens vers les sujets éloignés. Les ancres doivent être descriptives et variées, et l’expérience utilisateur compte aussi.
  • Selon le type de site, les priorités diffèrent : conversion et cross-selling en e-commerce, fraîcheur pour un site média, URLs générées par le CMS à contrôler sur un gros site. Un maillage automatisé demande une revue régulière.

Le maillage interne est surement le levier le plus important en SEO et souvent négligé ou peu maîtrisé sur les sites web. Je constate régulièrement sur mes sites clients l’efficacité de l’optimisation des liens internes, d’autant plus sur de gros sites. Google utilise plusieurs types de PageRank, algorithmes servant au classement des pages web sur le moteur de recherche, qui se basent justement sur les liens internes et externes. Dans cet article, on va s’intéresser au maillage de liens internes au site, c’est à dire au sein du même domaine et à ce que j’appelle le « Multi Pagerank sculping » soit la manière d’optimiser (sculpter) son maillage de liens en fonction de ses différents PageRanks.

Lire la suite