Visibilité IA : comment savoir si Google vous cite, et pourquoi il ne le fait pas
En bref
- Sur 89 requêtes posées à Google lors d’un test de l’outil creapulse de test de visibilité IA, une réponse d’IA s’est affichée 89 fois. La question n’est plus de savoir si la réponse d’IA apparaît, mais quels sites elle cite.
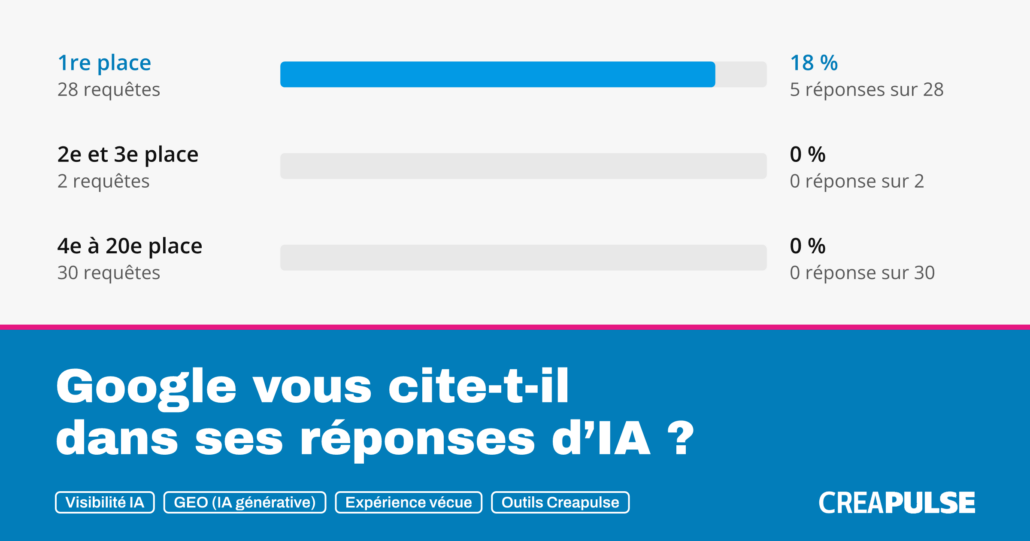
- Le site mesuré est cité dans 18 % des réponses d’IA (5 sur 28) quand il est 1er dans Google, et dans aucune des 30 réponses où il est entre la 4e et la 20e place.
- 47 % des sites cités par l’IA de Google (IA overview) sont aussi dans les dix premiers résultats organiques : être classé sur les pages de résultats organiques aide à être cité mais ca reste une bataille à part et aussi plus accessible.
- Google masque désormais l’adresse de la quasi-totalité de ses résultats organiques : un outil de mesure qui ne la résout pas conclut l’inverse de la vérité, sans afficher d’erreur.
- Avant d’être cité par les IA, encore faut il que les bots IA aient accès à vos pages : L’outil de visibilité IA teste les robots IA qui peuvent lire la page, et sept prérequis pour aider les LLms à comprendre vos contenus.
Google répond non seulement par dix liens (parfois meme moins, 9 bien souvent), mais aussi le moteur écrit une réponse IA au-dessus des résultats (AI overview), et cite à côté cinq ou six sites dont il s’est servi comme sources. Si votre site n’en fait pas partie, vous ne perdez pas trois places : vous perdez la réponse, et aucun tableau de bord ne vous prévient.
Je vais tenter de poser ça simplement : comment on mesure cette visibilité dans les réponses d’IA, ce que j’ai trouvé en la mesurant pour de vrai, et ce qui se corrige chez vous. Tous les chiffres de cet article sortent d’un relevé fait du 6 au 8 novembre 2026 sur un site marchand non francophone de 3 672 pages : 89 requêtes posées à Google, une par une, et ses 89 réponses d’IA lues ligne à ligne.
Combien de sites Google cite-t-il dans une réponse d’IA ?
Commençons par nommer les choses, parce qu’on mélange vite trois objets différents. Quand vous tapez une question dans Google, vous pouvez tomber sur ses dix résultats classiques, sur un AI Overview (le bloc de réponse générée affiché au-dessus des résultats) ou sur l’AI Mode (l’onglet conversationnel, qui répond et propose ses sources). Trois surfaces, trois listes de sites, et elles ne disent pas la même chose.
Sur les 89 réponses d’IA que j’ai lues, Google cite 5,8 sites en moyenne par réponse. Les résultats classiques des mêmes requêtes affichent en moyenne 6,9 sites. En gros, une réponse d’IA, c’est une courte liste de gagnants, et une longue liste de sites qui n’existent plus pour le lecteur.
| La surface | Ce que l’internaute voit | Ce que vous pouvez y gagner |
|---|---|---|
| Résultats classiques | dix liens, que l’internaute choisit | des clics, et un classement qui se travaille |
| AI Overview | une réponse écrite, et 5,8 sites cités à côté en moyenne | une citation, ou rien |
| AI Mode | une réponse conversationnelle et ses sources | une citation, sur une surface encore jeune |
Être bien classé suffit-il pour être cité ?
C’est le résultat qui m’a le plus surpris, et c’est celui qui change une feuille de route. Sur les 60 requêtes où le site mesuré est classé dans Google, j’ai regroupé les requêtes selon la position du site, puis compté les réponses d’IA qui le citent.
Lisez bien la dernière ligne. Sur ces trente requêtes, le site est déjà à portée de la première page, Google affiche trente réponses d’IA, et aucune ne cite le site. Entre 18 % de réponses qui le citent en 1re place et zéro dès la 4e, il n’y a pas de pente douce : il y a une marche. Les 2e et 3e places, elles, ne comptent que deux requêtes, trop peu pour en tirer quoi que ce soit.
Ce qu’il faut retenir c’est que gagner neuf places ne rapproche pas d’une citation. La citation n’est pas la récompense d’un bon classement, c’est une autre bataille sur le même terrain. Et c’est plutôt une bonne nouvelle, on va voir pourquoi.
Le classement et les réponses d’IA se recoupent à peine de moitié
Si l’IA de Google recopiait le classement, votre travail serait simple : remonter dans les dix premiers résultats, et attendre. J’ai donc comparé, requête par requête et dans les deux sens, les sites cités par l’IA et ceux des dix premiers résultats.
47 % des sites cités par l’IA sont aussi dans les dix premiers résultats, et 39 % des sites des dix premiers résultats sont cités par l’IA. Le recoupement n’est jamais nul, jamais total : l’IA de Google reprend environ la moitié du classement, et va chercher l’autre moitié ailleurs.
D’ailleurs, la difficulté d’un mot-clé ne prédit pas ce recoupement. Sur mon relevé, deux requêtes de difficulté identique se retrouvent l’une à 11 % de sites communs entre l’IA et le classement, l’autre à 100 %. Autant dire que la difficulté, l’indicateur sur lequel toute la profession découpe ses priorités, est un indice organique : elle ne dit rien de votre potentiel de citation.
La conséquence est concrète : vous n’avez pas besoin de déloger Reddit de la première place pour commencer à être cité. Le classement et les citations de l’IA sont deux listes différentes, et la seconde est bien plus accessible que la première.
Citation ou mention : quelle différence ?
Il y a deux façons d’apparaître dans une réponse d’IA, et les confondre fausse tout de suite le résultat. Être cité, c’est figurer parmi les sources que Google crédite à côté de sa réponse ou lie depuis son texte. Être mentionné, c’est voir son nom de marque écrit dans la réponse, avec ou sans lien. Être nommé est une visibilité ; être cité est une autorité.
Sur le site mesuré, hors les quatre requêtes qui contiennent son propre nom, la part de citation (les réponses qui le citent parmi leurs sources) est de 3,5 %, et la part de mention (les réponses qui écrivent son nom) de 2,4 %, sur 85 réponses. En gardant ses requêtes de marque, les deux parts passent à 6,7 % et 5,6 %, sur 89 réponses.
A noter que l’écart entre les deux bases n’est pas un détail de calcul : la part de citation double presque. Un outil qui vous annonce une part de voix sans dire s’il compte vos requêtes de marque vous flatte sans le dire, parce qu’être cité sur son propre nom n’a jamais été une conquête.
Je me méfie encore plus des scores composites, ces notes uniques qui mélangent mention et citation avec une pondération maison. Une pondération inventée présentée comme une mesure, ça reste une invention.
Pourquoi beaucoup d’outils se trompent sans le dire
Depuis l’été 2026, Google ne met plus l’adresse des sites dans le code de ses pages de résultats : chaque lien passe par un redirecteur maison, google.com/goto, qui porte un jeton illisible à la place de l’adresse. Google a confirmé ce déploiement à Search Engine Roundtable le 26 août 2026, en le rangeant parmi ses mesures contre les abus, et le site spécialisé y voit une protection contre l’aspiration des résultats. Sur mon relevé, l’adresse de la quasi-totalité des résultats organiques est masquée, et celle de 28,5 % des sources d’AI Overview aussi.
Le problème n’est pas le masquage, c’est ce qu’il produit en aval. Un outil qui lit ces adresses naïvement attribue toutes les sources au même domaine, celui de Google. L’outil ne plante pas, n’affiche aucune erreur : il conclut simplement que vous n’êtes pas cité, ou que tout le monde l’est. Une panne silencieuse ressemble à un résultat normal, et c’est bien ça qui la rend dangereuse.
Même histoire avec les champs fournis gratuitement à côté des mesures payantes. L’API que j’utilise annonce, pour chaque requête, si elle déclenche une réponse d’IA. J’ai pris trente requêtes et je suis allé vérifier en interrogeant réellement Google sur chacune : le champ gratuit annonçait une réponse d’IA pour neuf requêtes, et la réponse s’affichait sur les trente. Le champ s’est trompé 21 fois sur 30.
Vous me direz que ça fait beaucoup de précautions pour un article qui présente un outil. C’est justement le point : un champ gratuit situe, il ne compte pas. Quand un chiffre n’a pas été vérifié, je préfère écrire qu’il ne l’a pas été plutôt que de le publier comme un relevé.
Avant d’être cité, il faut être crawlé
Pour qu’une IA cite votre page, il faut d’abord que son robot ait pu la lire. C’est mécanique, et c’est là que des sites perdent la partie sans le savoir.
Un robot d’IA passe deux portes. La première est votre fichier robots.txt, la liste de ce que vous autorisez : une demande polie, que les robots sérieux respectent. La seconde est votre pare-feu ou votre CDN, le service qui protège et accélère votre site. Le pare-feu, lui, ne demande rien : il décide. Imaginez un panneau « entrée libre » sur la porte, et un videur qui refoule tout le monde derrière.
Sur le site mesuré, j’ai appliqué chaque règle du robots.txt à 14 pages pour 16 robots, puis je me suis présenté au serveur sous l’identité des 14 robots qui crawlent vraiment, une requête chacun. Verdict : les 14 robots ont obtenu la page, et le site est pourtant servi derrière Cloudflare. Être derrière un CDN ne veut donc pas dire être fermé aux IA, et la nuance mérite d’être dite, parce qu’on lit souvent le contraire.
Bon, j’ai aussi appris à mes frais comment il ne faut pas tester. Le 7 novembre 2026, au premier essai, mon script a enchaîné environ 290 requêtes sur le même site, page après page et robot après robot. Le pare-feu a fini par refuser toutes ces requêtes, y compris celle qui se présentait comme Googlebot : le pare-feu bloquait mon adresse IP, pas un nom de robot. Données inutilisables, relevé à refaire.
La leçon vaut pour vos propres tests. Un pare-feu applique en général sa politique au site entier, et non page par page : une seule page suffit pour le tester. Les règles du robots.txt, elles, se vérifient chemin par chemin, sans envoyer la moindre requête au serveur.
Dernière nuance, et elle compte : ce test mesure une identité déclarée, depuis notre adresse. Un pare-feu filtre aussi sur les plages d’adresses IP annoncées par les éditeurs de robots. Ce sont vos journaux serveur qui font foi : eux seuls disent quels robots sont vraiment passés. Et pour choisir quels robots laisser entrer, j’ai détaillé chaque famille dans le guide des bots IA à autoriser dans votre robots.txt.
Les sept prérequis qui rendent une page citable
Une fois le robot entré, reste ce qu’il trouve sur la page. Une IA ne lit pas une page comme vous : elle la découpe pour en extraire des morceaux réutilisables, comme un résumé, un intertitre, une ligne de tableau ou une question suivie de sa réponse. Ce qui est déjà découpé, l’IA peut le reprendre et le créditer tel quel ; ce qui est en prose continue, elle doit le reformuler.
Personne hors de Google ne connaît ses critères de citation, et je ne vais pas prétendre le contraire. Mais ces sept prérequis sont la seule partie de l’équation sur laquelle vous avez la main. Voilà combien des 14 pages analysées remplissaient chacun d’eux.
Aucun résumé en tête sur les quatorze pages, et un seul tableau. Pendant ce temps, l’AI Overview de Google ouvre systématiquement par un paragraphe de 73 à 280 caractères avant de découper sa réponse en blocs titrés. Le résumé que vos pages ne donnent pas, Google l’écrit à votre place, avec les sources de son choix.
Et le plus intéressant n’est pas dans les taux. Treize des quatorze pages commençaient par exactement les mêmes neuf titres de section, qui sont des liens de menu. Un robot lit « Sign in » et « Sign up » comme les premières sections de la page, et ne croise le sujet qu’au dixième titre.
Ce n’est donc pas treize pages à corriger : c’est un gabarit, qui s’applique aux 3 672 pages du site. Un audit qui vous vend treize chantiers là où il y a un réglage perd sa crédibilité dès que vous l’ouvrez.
Au passage, ce site a bien un fichier llms.txt à la racine, censé proposer aux IA une version épurée du contenu. C’est rare, et ça ne le dispense de rien : ce fichier n’autorise aucun accès, aucun grand moteur d’IA n’a confirmé s’en servir, et ce qui est mal découpé dans les pages l’est aussi dans le llms.txt.
Ce que la mesure complète a donné sur un site réel
Mettons tout bout à bout. Sur ce site de 3 672 pages, la mesure complète a coûté 0,18 $ d’API et quelques minutes de calcul.
| Ce qui a été mesuré | Résultat |
|---|---|
| Requêtes posées à Google | 89 : 29 sujets tirés des pages du site, et 60 requêtes où le site est classé |
| Réponses d’IA lues | 89, une par requête |
| Réponses d’IA qui citent le site | 6, dont 5 sur des requêtes où le site est déjà 1er |
| Citations dans ces 89 réponses, tous sites confondus | 516, partagées entre 260 domaines |
| Domaines cités dans le plus de réponses | YouTube (56 réponses sur 89), Reddit (25), un comparateur de logiciels (14) |
| Accès et lisibilité | 14 pages analysées, 16 robots testés |
Le site n’est cité que dans six réponses sur 89, et cinq de ces six citations tombent sur des requêtes où il était déjà premier. Pendant ce temps, 260 domaines différents se partagent les 516 citations de ces réponses. Le terrain n’est pas vide : il est occupé.
Mais le constat le plus rentable n’était pas dans les citations. Les dix pages les plus visibles du site redirigent ailleurs, et ces dix pages portent à elles seules 70 % de son trafic estimé.
En parallèle, douze requêtes de difficulté 10 ou moins, où le site est déjà placé entre la 4e et la 20e place, cumulent 136 000 recherches par mois. La plus grosse de ces douze requêtes pèse 74 000 recherches mensuelles pour une difficulté de 5, et elle pointe vers une page qui redirige. À côté, les 29 sujets du marché du site réunis pèsent 2 420 recherches par mois.
Trois chantiers sont sortis, dans cet ordre : réparer les dix pages qui redirigent, aller chercher les douze requêtes faciles, et arrêter de courir après les requêtes de marque des concurrents. Aucun des trois ne se devine sans mesurer, et les deux premiers ne coûtent presque rien à corriger.
Par où commencer cette semaine
Vous n’avez pas besoin d’un audit pour faire les deux premières étapes. Dans l’ordre, parce que chacune conditionne la suivante :
- Vérifiez l’accès, sur une page de contenu. Pas votre page d’accueil : un article ou une fiche produit, là où les données structurées ont un sens. Si un robot de recherche d’IA est refusé, le reste ne sert à rien.
- Regardez votre gabarit, pas vos pages. Ouvrez le code de deux pages du même type et comparez leurs premiers titres de section. Si vos neuf premiers intertitres sont votre menu, vous avez un réglage à faire, pas une refonte.
- Posez un résumé en tête et un tableau dans ce gabarit. C’est le format même d’une réponse d’IA : elle résume, puis elle détaille.
- Mesurez qui est cité à votre place sur vos propres sujets. C’est la seule étape qui demande d’interroger Google requête par requête, et c’est ce que fait notre outil de visibilité IA.
Ensuite viennent les questions auxquelles aucune mesure ne répond : pourquoi ces redirections existent, ce que ces sujets valent vraiment pour votre activité, et ce qu’il faudrait écrire pour entrer dans la réponse de Google. Ces questions-là se tranchent à deux, dans un audit SEO / GEO, en lisant les réponses une par une et en les comparant à vos pages.
Questions fréquentes
Et ChatGPT, Perplexity, Gemini ?
Notre outil de visibilité IA ne mesure que les réponses de Google, et c’est délibéré. Les réponses de Google sont les seules qui se lisent telles que votre client les voit, sources comprises.
Interroger un modèle par son API rend une réponse qu’aucun utilisateur ne reçoit : pas la même version, pas le même contexte, pas les mêmes sources. Un chiffre qui ne correspond à rien de vécu n’est pas une mesure de visibilité, même s’il fait une case de plus à cocher.
Faut-il bloquer GPTBot ?
C’est un choix, pas une faute. GPTBot sert à l’entraînement des modèles d’OpenAI : le bloquer n’empêche pas ChatGPT de vous citer aujourd’hui, ce sont OAI-SearchBot et ChatGPT-User qui comptent pour ça. Bloquer GPTBot réduit seulement ce que les futurs modèles d’OpenAI retiendront de votre contenu.
Un robot de recherche bloqué est critique ; un robot d’entraînement bloqué est une décision qui vous appartient. J’ai détaillé les robots de chaque éditeur dans le guide des bots IA à autoriser.
Mon site est derrière Cloudflare, les IA sont-elles bloquées ?
Pas forcément. Le 8 novembre 2026, sur un site protégé par Cloudflare, les 14 robots testés ont tous obtenu la page. Tout dépend de vos réglages anti-robots.
Attention, un réglage trop large n’écrit rien dans votre robots.txt : la consigne continue d’autoriser des robots que le pare-feu refuse, et rien ne vous le signale.
Deux mesures du même site sont-elles comparables ?
Pas tout à fait, et autant le savoir avant d’acheter un suivi. L’étape qui découvre les sujets dans votre contenu s’appuie sur un modèle de langage : sur six exécutions de la mesure sur un même site, le nombre de requêtes candidates variait de 28 à 34.
Une mesure de visibilité IA est donc une photo, pas un point de série. Pour suivre dans le temps, il faut figer les sujets du premier relevé et les remesurer à l’identique.
Être lisible garantit-il d’être cité ?
Non, et personne ne peut l’affirmer : les critères de citation de Google ne sont pas publics. Ce que vous obtenez en travaillant l’accès et la structure, c’est d’arrêter de perdre par forfait. La suite dépend de ce que vous avez à dire sur le sujet, et de qui le dit déjà mieux que vous.
Reste une question que je vous laisse, et qui décide de pas mal de budgets : sur vos trois sujets les plus rentables, savez-vous quels sites Google cite dans sa réponse à votre place ? Si la réponse est non, c’est que ça n’a jamais été mesuré, et ça se mesure en quelques minutes.

Consultant SEO / GEO spécialisé en audits SEO avancés, stratégie de contenu automatisé et optimisé (avec relecture humaine), création d’outils sur mesures, analyse des brevets et algorithmes Google liés au SEO et à la recherche générative et domaines impactant le SEO: UX, social media, autorité de la marque, …


Laisser un commentaire
Rejoindre la discussion?N’hésitez pas à contribuer !