Brevets Google : la liste commentée des brevets du moteur de recherche
En bref
- Cette page liste les brevets déposés par Google autour de son moteur de recherche : classement des résultats, compréhension des requêtes, entités, liens, réponses générées par IA.
- Chaque brevet a sa fiche : dates de dépôt et de délivrance, inventeurs, ce qu’il décrit, ce que ça change pour le SEO, et un extrait du texte d’origine cité mot pour mot.
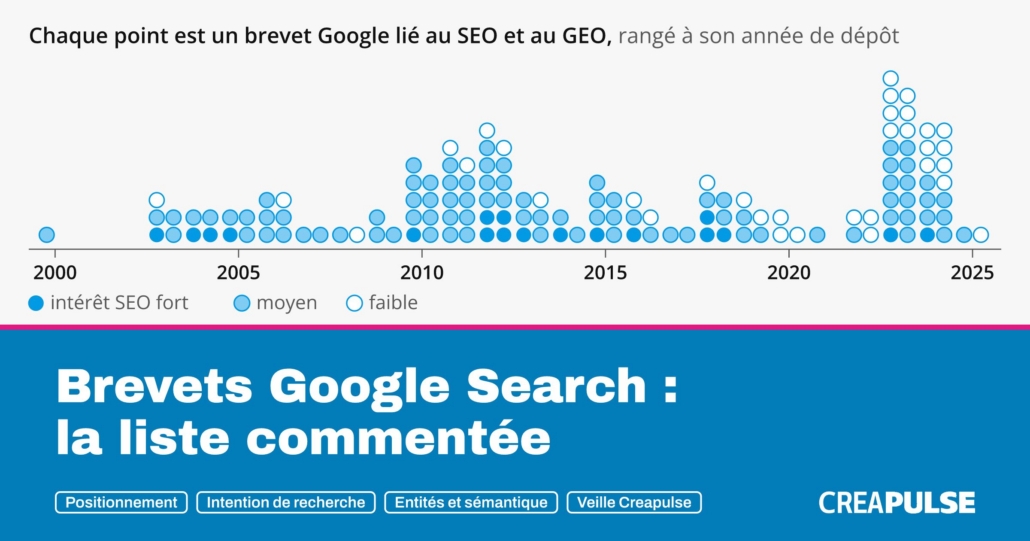
- Une frise replace tous ces brevets dans le temps, année de dépôt par année de dépôt.
- Un brevet déposé ne prouve pas que Google s’en sert. Il montre comment ses ingénieurs ont posé un problème, et c’est déjà beaucoup.
Au 15 octobre 2026, cette page recense 138 brevets de Google liés à son moteur de recherche, déposés entre 2000 et 2025. Le dernier brevet délivré est « Content snippet generation and storage with generative model content grouping », le 8 septembre 2026.
Quand on fait du SEO, on passe son temps à deviner comment Google fonctionne. Les annonces officielles restent vagues, et les tests de terrain ne montrent que le résultat, jamais la mécanique. Les brevets, eux, décrivent la mécanique.
Le problème, c’est qu’un brevet c’est long, c’est en anglais et c’est écrit par des juristes. J’ai donc monté une veille qui les repère, les trie et les résume. Cette page en est la vitrine : dès qu’un nouveau brevet entre dans ma base, sa fiche apparaît ici.
Les brevets Google en chiffres
À noter que ces chiffres ne portent que sur les brevets que j’ai retenus pour leur intérêt SEO, pas sur tout ce que Google dépose, qui déborde largement du moteur de recherche.
La frise des brevets Google, année par année
Un point par brevet, rangé à son année de dépôt. La date de dépôt, c’est le moment où Google a couché l’idée sur le papier ; la délivrance arrive plus tard, le délai moyen est donné juste au-dessus. Plus le point est foncé, plus la note d’intérêt SEO du brevet est élevée.
Quels sont les brevets de Google sur la recherche ?
Les fiches vont du brevet le plus récent au plus ancien, par date de dépôt, et les boutons filtrent par thème. Le titre reste en anglais : c’est le titre officiel du brevet. L’extrait cité aussi, parce que ce sont les mots de Google et que je n’ai pas voulu les retraduire.
Brevets déposés en 2025
Identifying search results in a history repository
US-12579191-B2 · déposé le 30 janvier 2025, délivré le 17 mars 2026
Inventeurs : Yana Yushkina, Mohamad Hasan Ahmadi, Sophie Chang et 10 autres
Ce brevet décrit une recherche dans l’historique de navigation du navigateur (l’omnibox de Chrome, typiquement) qui ne se base plus sur l’URL ou le titre, mais sur le contenu sémantique des pages déjà visitées. Chaque page est découpée en passages, transformée en embeddings (des représentations numériques du sens, pour faire simple), puis compressée et stockée sur l’appareil. Quand l’utilisateur tape une requête, le système compare, génère une réponse ancrée dans le passage retrouvé et cite la page source. Ce n’est pas un signal de ranking de la SERP : on est sur du retour de visiteur, pas sur de l’acquisition. Le levier est donc réel mais ténu, et je préfère vous le dire franchement plutôt que de vous vendre une révolution.
Les navigateurs comprennent également une zone de texte qui permet à un utilisateur d’entrer un localisateur de ressource, de naviguer vers une ressource particulière ou de lancer des recherches. Le navigateur peut fournir des suggestions à l’utilisateur au fur et à mesure que l’utilisateur tape dans la zone de texte.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qui compte pour vous, c’est le déséquilibre entre une page identifiable par son titre et une page identifiable par ses passages. Le matching se fait sur des passages du contenu, avec un nombre d’embeddings par page limité par la mémoire. Concrètement, des passages clairs, autoportants et bien délimités ont plus de chances d’être retrouvés et cités que du contenu dilué. Le ranking peut aussi plafonner le nombre de résultats d’un même domaine, donc un site qui multiplie des pages quasi identiques se cannibalise jusque dans l’historique de l’utilisateur. À noter que l’impact est indirect : la page doit d’abord avoir été visitée. Un titre et une URL explicites restent utiles, mais ne sont plus le seul point d’accroche. Ce qu’il faut retenir : écrire pour des passages qui se comprennent isolément sert le SEO classique, le GEO et ce type de retrieval en même temps.
Exemple : Un guide comparatif de 4 000 mots dont les sections répondent chacune à une question précise (« quel budget prévoir », « quelle durée de mise en place ») sera plus facile à retrouver via une requête en langage naturel dans l’historique qu’un pavé introductif flou avec un titre générique. Et l’utilisateur qui revient dessus peut atterrir directement sur la bonne réponse.
Thèmes : Intention de recherche, Embeddings, IA générative, RAG · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Web page transformer for structure information extraction
US-12730846-B2 · déposé le 7 janvier 2025, délivré le 8 septembre 2026
Inventeurs : Qifan Wang et Dongfang Liu
Ce brevet décrit un transformer qui lit une page web pour en extraire des champs précis (titre d’événement, date, lieu, attributs produit…). Il ne regarde pas juste le texte aplati : il exploite aussi la structure HTML, c’est-à-dire l’arbre DOM, avec les relations parent-enfant et la mise en page. Pour faire simple, la machine ne lit pas votre page comme un roman, elle la lit comme un formulaire dont elle cherche les cases. Pas un signal de ranking, mais un indice sérieux sur la façon dont un contenu peut être compris. Le brevet ne dit pas que Google l’applique à son index (il parle d’un système capable de répondre « à une requête de recherche, une analyse ou autre »), donc on reste prudent, sans en faire un dogme.
Des techniques telles que l’induction de modèles/enveloppes ont connu un certain succès, mais ne passent pas à l’échelle du Web entier, où l’obtention de vérités terrain exactes pour un grand nombre de domaines peut exiger beaucoup de ressources. De plus, les enveloppes peuvent rapidement devenir obsolètes parce que la structure des pages change, et de nouveaux modèles sont nécessaires pour les nouveaux domaines.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Mécaniquement, plus votre HTML est propre et lisible, plus une extraction « champ par champ » a de chances de tomber juste. Les champs sont repérés grâce au texte ET à la position dans la structure. Ce qu’il faut retenir : une info clé (prix, date, lieu, caractéristique) doit se trouver dans un bloc clair, à côté de son libellé, avec une hiérarchie de balises cohérente. Le brevet insiste aussi sur le fait que cette approche fonctionne sans wrapper (gabarit) écrit à la main par site, ce qui veut dire que la machine se débrouille même sur des pages jamais vues. Ne comptez donc pas sur un gabarit « connu » pour être compris : c’est la lisibilité de votre structure qui joue. Ça complète les données structurées sans les remplacer : un balisage explicite reste un signal direct, là où l’extraction par modèle est une compréhension indirecte, une assurance de plus. Côté GEO, des champs bien isolés sont aussi plus faciles à réutiliser dans une réponse.
Exemple : Une page d’événement où le titre est en h1, la date et l’heure dans un bloc dédié juste sous le titre, et le lieu dans une section libellée « Lieu » sera bien plus facile à extraire qu’une page où tout est noyé dans un paragraphe décoratif avec des divs sans logique. Même chose pour une fiche produit : les attributs en liste ou tableau libellé plutôt qu’éparpillés dans le texte marketing.
Thèmes : Embeddings, Données structurées, Balisage on-page, Intention de recherche · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Brevets déposés en 2024
Contextualized token retriever
US-12632457-B2 · déposé le 30 décembre 2024, délivré le 19 mai 2026
Inventeurs : Jinhyuk Lee, Zhuyun Dai, Sai Meher Karthik Duddu et 4 autres
Ce brevet décrit une architecture de récupération « multi-vecteurs » dans l’esprit de ColBERT : chaque mot (token) de la requête et du document est transformé en vecteur, puis on score au niveau du token. L’astuce, c’est qu’on ne compare pas tout avec tout. On ne garde que les vecteurs de documents les plus proches de chaque token de la requête, on en déduit un ensemble de candidats, et on les note sur cette base. C’est un gain de vitesse et de mémoire, pas un nouveau signal de ranking. Pour un SEO/GEO, c’est donc utile à comprendre, mais le levier direct reste mince.
Procédés, systèmes et appareils, y compris des programmes informatiques encodés sur des supports de stockage informatique, permettant d’identifier des documents pertinents pour une requête en utilisant uniquement des vecteurs de jetons récupérés de documents candidats plutôt que tous les vecteurs de jetons des documents.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le mécanisme dit une chose utile : un document remonte s’il possède au moins un token (une unité de sens) très proche de chaque token de la requête, et les manques sont pénalisés par une valeur de substitution. Concrètement, la couverture fine des sous-aspects d’une requête compte, pas seulement le sujet global. Un passage qui traite précisément chaque facette (entité, attribut, intention) a plus de chances d’entrer dans le lot de candidats qu’un texte vague et généraliste. À noter que le brevet ne dit rien sur ce que Google déploie réellement en production : on reste sur un raisonnement, pas sur un signal confirmé. Ce qu’il faut retenir, c’est que rédiger en couvrant chaque facette de la requête est stratégique, et que le remplissage de mots-clés ne l’est pas.
Exemple : Sur une requête comme « aspirateur robot poils de chien pas cher », une page qui ne parle que d’aspirateurs robots en général risque de rater les tokens « poils » et « chien » et d’écoper du score de substitution. Une page qui traite explicitement de la gestion des poils d’animaux et du budget a un vecteur proche pour chaque morceau de la requête.
Thèmes : Embeddings, Positionnement, Intention de recherche, Questions-réponses · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Summary of a discussed topic in previous conversations as an artifact in large language model interfaces
US-12524452-B1 · déposé le 5 décembre 2024, délivré le 13 janvier 2026
Inventeurs : Tibor Kranjc et Will Walker
Ce brevet décrit une mémoire thématique pour assistants LLM : chaque conversation passée est résumée par sujet, stockée comme « artefact », puis réinjectée dans le contexte quand une nouvelle requête est classée sur ce même sujet. Pour faire simple, l’assistant ne rejoue pas tout l’historique, il retrouve la fiche du sujet et répond en s’appuyant dessus. C’est du produit pur : ça touche la continuité conversationnelle, pas la façon dont on sélectionne ou cite des pages web. Je ne vais donc pas vous vendre un levier de ranking qui n’existe pas. En revanche, ça éclaire un déséquilibre à anticiper : la réponse d’un assistant peut dépendre autant du contexte accumulé de l’utilisateur que de la requête du moment.
Malheureusement, lorsqu’un utilisateur rappelle un sujet particulier dans une nouvelle session de chat qui a été précédemment abordé dans plusieurs sessions de chat antérieures, l’approche conventionnelle pourrait exiger que l’utilisateur fournisse des entrées pour faire défiler et accéder à un historique de chat entier qui peut inclure des dizaines ou des centaines de sessions de chat antérieures entre l’utilisateur et l’assistant virtuel ou l’interface qui permet à l’utilisateur d’interagir avec le grand modèle de langage.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le levier est indirect et ténu. Si les assistants conditionnent leurs réponses sur des résumés de sujets déjà discutés, l’utilisateur arrive avec un contexte préchargé, et sa requête sera plus précise, plus située dans un parcours. Côté contenu, cela plaide pour une couverture par sujet, avec des pages qui prolongent un parcours (étape suivante, cas avancés) plutôt que des pages isolées qui répondent à une seule question. Ce qu’il faut retenir c’est qu’on ne peut ni mesurer ni piloter ce mécanisme depuis l’extérieur : le brevet ne dit rien sur les sources web citées. À garder en tête pour penser la visibilité GEO, sans en faire un chantier prioritaire.
Exemple : Une personne a passé plusieurs sessions avec un assistant sur le choix d’un logiciel de facturation, et l’assistant a stocké un résumé de ce sujet. Quand elle revient avec « et pour la TVA européenne ? », la requête est classée sur ce sujet et la réponse tient compte de ses critères passés. Un site qui a structuré un parcours complet (comparatif, puis TVA, puis migration) a plus de chances de correspondre à cette demande déjà affinée qu’une page unique et généraliste.
Thèmes : Recherche conversationnelle, Questions-réponses, RAG, Embeddings · Intérêt SEO : 4/10 · Lire le brevet sur Google Patents
Adversarial bandits policy for crawling highly dynamic content
US-12585712-B2 · déposé le 4 novembre 2024, délivré le 24 mars 2026
Inventeurs : Michael Bendersky, Przemysław Gajda, Sergey Novikov et 2 autres
Ce brevet décrit comment Google décide à quelle fréquence re-crawler des pages d’offres commerciales (prix, disponibilité) dont le contenu change tout le temps. Plutôt qu’une règle fixe, il met en concurrence plusieurs stratégies (uniforme, pondérée par le changement, pondérée par la consultation, optimisée sur les ressources), et un algorithme de « bandits » (un système qui teste plusieurs options et apprend progressivement laquelle rapporte le plus) ajuste leur poids. Le tout sous un budget de crawl limité. Ce qu’il faut retenir : la fréquence de passage n’est pas un cadeau, c’est une allocation de ressources rare, et elle dépend de signaux que vous pouvez influencer. Le périmètre reste étroit (offres e-commerce) et il n’y a aucun réglage direct à actionner, d’où un levier réel mais indirect.
L’actualisation de contenu factuel dynamique, tel que des pages d’offre, à un rythme uniforme n’utilise pas de manière optimale les ressources réseau. Pour garantir que le contenu est à jour, le robot d’exploration du web effectuerait des explorations fréquentes, mais des requêtes d’exploration fréquentes consomment des ressources réseau inutiles si le contenu n’a pas changé et peuvent également submerger le domaine.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Les paramètres estimés pour décider du recrawl sont la probabilité de changement (historique de fréquence des modifications, temps écoulé depuis la dernière), le taux d’accès (impressions, clics) et des métadonnées comme la marque, le marchand, le pays ou le jour de la semaine. Si vos fiches produit changent vraiment et sont réellement consultées, elles ont plus de chances d’être revisitées vite. À l’inverse, des pages qui ne bougent jamais ou ne génèrent ni impressions ni clics sont mécaniquement reléguées dans l’allocation du budget. Côté action : gardez des prix et des stocks fiables et à jour dans le HTML et vos flux, évitez les changements artificiels sans valeur (ils brouillent l’historique), et concentrez le budget de crawl sur les pages qui comptent en élaguant le reste. À noter que Google teste aussi des stratégies par exploration : un rythme de recrawl irrégulier n’est donc pas forcément un signal négatif.
Exemple : Sur un site e-commerce de 50 000 références, les produits en promo qui reçoivent des clics et dont le prix change souvent sont re-crawlés plus vite que les fiches d’un catalogue dormant. Si vous gardez des milliers de fiches obsolètes ou sans trafic indexables, elles consomment un budget qui ferait plus de bien à vos fiches vivantes.
Thèmes : Crawl, Fraîcheur du contenu, Intention de recherche, Embeddings · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Indexing actions for resources
US-12561387-B2 · déposé le 3 octobre 2024, délivré le 24 février 2026
Inventeurs : Steve Chen, Jason B. Douglas et Samuel Shoji Fukujima Goto
Ce brevet décrit un moteur qui n’indexe plus seulement ce qu’une ressource contient, mais ce qu’elle permet de faire : réserver, commander, appeler, téléphoner, etc. Les « actions » (type, paramètres, parfois instructions exécutables) sont déclarées par le site, via du balisage type Schema.org Actions, un manifeste d’application ou une soumission directe, puis stockées dans l’index. À la requête, le moteur détecte si l’intention implique une action et favorise les ressources capables de la réaliser, avec un boost de classement. Le levier est réel mais indirect : le brevet ne dit pas que tout le monde y gagne, il décrit un mécanisme dont on ignore l’ampleur de déploiement. Reste que pour des pages transactionnelles ou de service, c’est une piste stratégique, pas un gadget.
Le système fournit un cadre pour indexer les actions prises en charge par des ressources de page Web, des ressources de service Web et des ressources d’application native. Le système évalue ensuite des requêtes pour déterminer si la requête est associée à une action, et, si oui, dans quelle mesure une ressource prend en charge cette action.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Pour les pages dont l’objectif est une action (réserver, commander, demander un devis, prendre rendez-vous), déclarez cette action de façon structurée plutôt que de la laisser deviner par le moteur. Concrètement : balisage Schema.org Actions propre, paramètres explicites (date, lieu, quantité…) et parcours court, car le brevet mesure la capacité à agir avec un nombre d’étapes réduit (moins d’étapes, meilleure mesure). À noter aussi que les actions sont vérifiées : une action annoncée mais qui ne fonctionne pas est décotée. Impact direct sur la pertinence perçue, et indirect sur l’expérience utilisateur. Donc ne balisez que ce que la page sait réellement faire.
Exemple : Un restaurant dont la page propose la réservation : en déclarant l’action « réserver » avec ses paramètres (date, nombre de couverts) et un formulaire en deux étapes, il se place mieux sur une requête « réserver une table » qu’un concurrent dont la page ne fait que décrire la carte et renvoie vers un PDF.
Thèmes : Positionnement, Intention de recherche, Données structurées, Applications mobiles · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
User attribute resolution of unresolved terms of action queries
US-12461924-B2 · déposé le 5 septembre 2024, délivré le 4 novembre 2025
Inventeurs : Vikram Aggarwal et Alice Lee
Ce brevet décrit un mécanisme d’assistant sur appareil : l’utilisateur déclenche une action sans la formuler (bouton, voix, geste), l’appareil lit le contenu affiché à l’écran, puis complète ce qui manque (une catégorie de lieu, une cuisine, une activité) avec des données personnelles stockées en local. Le résultat est un élément cliquable qui lance l’action. Pour un SEO/GEO, c’est utile à comprendre, mais le levier reste ténu : la résolution se fait côté appareil, à partir de l’historique, des préférences et de la localisation de l’utilisateur, donc on n’a aucune prise directe dessus. Ce qu’on peut en retenir, c’est une logique plus qu’une consigne : le contenu affiché sert de contexte, et quand ce contexte est trop vague, c’est le profil de l’utilisateur qui tranche.
Certaines techniques s’appuient sur le contexte actuel de l’interaction d’un utilisateur avec un dispositif informatique pour tenter d’inférer l’intention de l’utilisateur lorsqu’elles effectuent des actions au nom de l’utilisateur. Ainsi, par exemple, ce qu’un utilisateur est en train de faire actuellement avec un dispositif informatique et/ou ce qu’un utilisateur a récemment fait avec un dispositif informatique peut être utilisé pour aider à interpréter de futures requêtes de l’utilisateur.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Pas de levier direct, et je ne vais pas vous en inventer un. L’enseignement est indirect : plus votre page est précise sur ses entités (nom, catégorie, sous-catégorie, localisation), moins l’appareil a de choses à deviner à votre place. Une page qui reste au niveau du genre (« restaurant ») laisse la main au profil personnel, alors qu’une page qui nomme l’espèce (type de cuisine, type d’activité) fournit un contexte exploitable tel quel. Pour le local, des données de point d’intérêt propres et cohérentes (fiche, balisage, contenu) restent stratégiques, puisque l’action peut aussi s’appuyer sur une base locale de lieux.
Exemple : Une page de blog sur « que faire ce week-end » mélange sorties, restos et boutiques sans hiérarchie : le contexte est ambigu, et l’appareil se rabat sur les goûts de l’utilisateur. Une page qui isole clairement un restaurant, sa cuisine et sa ville donne une entité nette, donc moins de risque que votre contenu soit « réinterprété » à côté de l’intention réelle.
Thèmes : Personnalisation des résultats, Intention de recherche, Entités et sémantique, SEO local · Intérêt SEO : 4/10 · Lire le brevet sur Google Patents
Automated keyword generation based on similarity score
US-12645684-B2 · déposé le 16 juillet 2024, délivré le 2 juin 2026
Inventeurs : Abhinav Khandelwal, Aravindan Raghuveer, Snehal Sunilkumar Motarwar et 1 autre
Ce brevet décrit un outil de suggestion de mots-clés : le système lit votre landing page, en tire un mot-clé source, puis le compare (similarité sémantique) à un stock de mots-clés déjà utilisés par des tiers. Il propose ensuite le plus proche à l’utilisateur, avec un apprentissage par feedback (sélection, confirmation, approbation). Tout l’ensemble est branché sur la mise en place de campagnes, les enchères et la prévision de conversion, donc sur l’univers publicitaire, pas sur le classement organique. Ce n’est pas un signal de ranking, et je ne vais pas vous inventer un levier qui n’existe pas. Reste un enseignement indirect : Google sait extraire des mots-clés depuis une page et les valider contre un usage du marché.
Les mots-clés jouent un rôle essentiel en mettant les utilisateurs en relation avec le contenu, les produits ou les services que les utilisateurs recherchent en ligne. Une sélection et une optimisation efficaces des mots-clés sont vitales pour une campagne réussie menée par un fournisseur de contenu, car elles peuvent déterminer si un élément de contenu du fournisseur de contenu est visible par le public cible.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Aucun levier de ranking direct. Ce qu’il faut retenir : le contenu d’une page sert de matière première pour déduire ses mots-clés, et le pool de référence est constitué de termes réellement utilisés par d’autres acteurs (au-delà d’un seuil de fournisseurs). Pour vous, ça plaide pour une page dont le sujet est limpide (produit ou service clairement nommé, vocabulaire cohérent) et pour une recherche de mots-clés qui part du vocabulaire réellement employé par le marché, pas de vos intuitions internes. À noter que l’aspect enchères et prévision de conversion ne concerne que ceux qui pilotent aussi du payant.
Exemple : Vous vendez des chaussures de trail : si votre page mélange vocabulaire maison et jargon flou, l’extraction de mots-clés sera bancale. Si elle nomme clairement le produit avec les termes que les concurrents emploient aussi, le mot-clé déduit tombera dans le pool validé par le marché, ce qui sert autant vos campagnes Ads que votre cadrage éditorial.
Thèmes : Recherche de mots-clés, Embeddings, Création de contenu, Analytics · Intérêt SEO : 3/10 · Lire le brevet sur Google Patents
Location-based searching using a search area that corresponds to a geographical location of a computing device
US-12579207-B2 · déposé le 30 mai 2024, délivré le 17 mars 2026
Inventeurs : Tak Keung Cheng et James R. Von Behren
Ce brevet décrit comment Google transforme la position d’un mobile en « zone de recherche » (quartier, ville, région, pays…), et pas en simples coordonnées GPS brutes. Ces zones sont imbriquées les unes dans les autres : la même position peut tomber dans plusieurs zones à la fois. Le serveur en choisit une à l’aide d’un score (précision estimée de la localisation, interactions passées de l’utilisateur), puis lance une requête construite avec le nom de la zone en mots humains, sans les coordonnées. Pour un SEO local, c’est un levier indirect mais réel : il éclaire la façon dont une position devient un libellé géographique, donc un contexte de requête. À noter que le brevet ne parle pas de signal de ranking sur votre site, il décrit un mécanisme de sélection et d’affichage.
Avec la popularité des dispositifs mobiles puissants, dotés de la localisation, l’intérêt des utilisateurs pour localiser rapidement des informations sur des lieux d’intérêt à proximité s’est accru. Pour répondre à cet intérêt, des systèmes et des méthodes ont été déterminés pour récupérer des informations sur la base d’une localisation géographique déterminée. Cependant, trouver rapidement des informations pertinentes sur des lieux d’intérêt à proximité peut être fastidieux et pénible.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le résultat est obtenu en interrogeant le moteur avec un libellé de lieu, et non avec des coordonnées. Vos pages doivent donc être pertinentes pour ces libellés, à plusieurs niveaux d’échelle (quartier, ville, département ou région). Cela veut dire des noms de lieux explicites et cohérents dans vos titres, contenus et données de fiche, plutôt qu’un ciblage limité à une seule maille. Comme l’utilisateur peut aussi élargir ou resserrer la zone (le brevet parle d’un lien de type « Refine Location » et d’une pondération qui évolue selon ses choix), un site qui couvre proprement plusieurs niveaux géographiques a mécaniquement plus de chances d’apparaître quand la zone change. Impact direct : la pertinence par zone. Impact indirect : la cohérence de votre hiérarchie géographique (pages ville, quartier, fiches établissement) aide à rester éligible quand la zone retenue bouge. À garder en tête : c’est un brevet, rien ne dit que tout est appliqué tel quel en production.
Exemple : Un restaurant qui n’a qu’une page « Paris » risque de passer à côté des requêtes calculées sur « Marais » ou « Paris 3e ». Avec une page par niveau (ville, quartier, fiche établissement), reliées entre elles et cohérentes avec sa fiche locale, il reste pertinent quel que soit le niveau de zone retenu.
Thèmes : SEO local, Intention de recherche, Positionnement, Personnalisation des résultats · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Customizing large language models for information retrieval
US-12675515-B2 · déposé le 3 mai 2024, délivré le 7 juillet 2026
Inventeurs : Jinsung Yoon et Sercan Omer Arik
Ce brevet décrit un « adaptateur » posé au-dessus d’un modèle d’embeddings figé (un encodeur LLM dont on n’a pas les poids). Il apprend à transformer les vecteurs de la requête et du corpus pour que la similarité (cosinus, notamment) colle mieux à la pertinence réelle. Un régulariseur l’empêche de trop s’écarter des vecteurs d’origine, et l’entraînement s’appuie sur des paires (requête, document) positives et négatives. Pour faire simple, c’est une couche de personnalisation de la recherche sémantique, pensée pour des corpus d’entreprise, des documents, des pages web ou des logs. Ce n’est pas un signal de ranking du web public, et rien n’indique que Google l’applique ainsi à son index. Utile à comprendre, mais le levier direct reste mince.
La présente divulgation propose un adaptateur IR, qui intègre un petit réseau adaptateur au-dessus de modèles d’incorporation linguistique de grande taille fixes afin de modifier des incorporations de texte préentraînées qui sont personnalisées pour un ensemble de données donné. La divulgation fournit en outre une perte de classement différentiable qui peut directement utiliser les informations de paires positives (requête, corpus). Une perte de classement et de multiples régularisateurs peuvent être inclus afin d’améliorer la généralisation et d’améliorer les performances d’IR sans surapprentissage ni oubli.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir : la pertinence se joue dans un espace vectoriel, et ce qui compte est la proximité sémantique entre la requête et votre contenu, pas la présence d’un mot-clé. Le brevet suggère aussi qu’un système de retrieval peut être réajusté sur des paires « requête satisfaite / non satisfaite ». Un contenu qui répond franchement à l’intention a donc plus de chances de se retrouver du bon côté de la frontière. Le levier actionnable est indirect : écrire des passages autoportants, alignés sur une intention précise, et vous en servir pour vos propres chantiers RAG ou de recherche interne, où ce type d’adaptateur est directement exploitable sans toucher au modèle de base. Par construction, il ne justifie aucun changement de pratique sur le SEO classique.
Exemple : Sur le moteur de recherche interne ou le chatbot RAG (génération augmentée par récupération) d’un site e-commerce, vous gardez l’encodeur d’embeddings du fournisseur et vous entraînez une petite couche d’adaptation avec des paires « requête → fiche produit pertinente » et « requête → fiche hors-sujet ». Les résultats remontent mieux, sans fine-tuning complet. Côté contenu public, vous vérifiez simplement que chaque page cible une intention nette plutôt que de mélanger trois sujets.
Thèmes : Embeddings, RAG, Questions-réponses, IA générative · Intérêt SEO : 4/10 · Lire le brevet sur Google Patents
Indexing access limited native applications
US-12682002-B2 · déposé le 17 avril 2024, délivré le 14 juillet 2026
Inventeurs : Pranay Gupta et Chirag Shah
Ce brevet décrit comment Google pourrait indexer le contenu d’applications natives (celles qui tournent sur le téléphone, hors navigateur) même quand tout est planqué derrière un écran de connexion. Le principe : un robot crée un compte dédié, se connecte tout seul, parcourt les écrans, en extrait le texte et les images, puis range le tout dans un index interrogeable par le moteur. C’est malin sur le papier, et ça montre que l’écran de login n’est pas forcément un mur infranchissable pour un moteur. Mais pour un SEO/GEO, le levier reste mince : on ne pilote pas ce crawler, on n’a aucun réglage à activer, et le brevet ne dit rien sur le classement des pages web. Utile à comprendre, rarement actionnable.
Certaines de ces applications natives limitent l’accès au contenu générique dans l’application native jusqu’à ce que des identifiants de compte soient fournis aux applications natives. Le contenu générique peut être un contenu qui n’est pas spécifique à des utilisateurs particuliers.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir, c’est que le contenu d’une app n’est pas par construction invisible au moteur, même derrière un compte. Si vous travaillez sur une app (ou sur un site avec app jumelle), le texte réellement affiché dans les écrans, y compris le texte d’interface, peut être lu et indexé. Donc la clarté et la pertinence de ces libellés comptent. Côté web, le contenu strictement réservé aux connectés reste un angle mort pour le crawl classique : si vous voulez qu’il soit trouvable, exposez un équivalent public (pages de présentation, fiches, aperçus). Et ne comptez pas sur ce mécanisme pour indexer votre espace membre : le brevet ne dit pas que c’est généralisé, ni que ça fonctionne pour du web.
Exemple : Une app de recettes réserve ses fiches détaillées aux utilisateurs inscrits. Plutôt que d’espérer que le robot se connecte, vous publiez des versions publiques indexables de ces fiches (titre, ingrédients clés, extrait), et vous soignez les libellés des écrans de l’app pour qu’ils décrivent clairement leur contenu.
Thèmes : Crawl, Indexation, Applications mobiles, Crawlers IA · Intérêt SEO : 4/10 · Lire le brevet sur Google Patents
Question answering using entity references in unstructured data
US-12591629-B2 · déposé le 8 mars 2024, délivré le 31 mars 2026
Inventeurs : Dvir Keysar et Tomer Shmiel
Ce brevet décrit comment Google peut répondre à une question de type « qui / quoi / où / quand » sans passer par une base de connaissances curée à la main. Il prend les résultats du top, en extrait les références d’entités (un nom de personne, un lieu, une date, dans le texte brut) et retient celle qui revient le plus, à condition qu’elle soit bien liée au sujet de la requête. Ça compte, parce que la réponse n’est plus choisie sur une page : elle ressort d’un consensus entre plusieurs pages bien classées. Ce n’est pas un mécanisme à surinterpréter (il consomme le classement, il ne le remplace pas), mais il déplace clairement ce qu’on optimise : être cité comme source d’une réponse, pas seulement être premier.
Dans certaines implémentations, un système fournit des réponses à des requêtes de recherche en langage naturel en s’appuyant sur des références d’entités identifiées sur la base des données non structurées associées aux résultats de recherche.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le classement des candidats repose sur la fréquence d’apparition dans le top et sur un score de thématicité (topicality : à quel point l’entité est liée au sujet de la requête), avec possiblement qualité, fraîcheur et pertinence en renfort. Trois leviers : 1) écrire la réponse en toutes lettres, avec le nom exact de l’entité à proximité immédiate de la question traitée, plutôt que de la laisser implicite ; 2) rester cohérent avec les faits que les autres pages bien classées énoncent, car une entité isolée a peu de chances de gagner un vote à la fréquence ; 3) soigner la fraîcheur des pages factuelles. Comme la réponse peut s’appuyer sur au moins deux résultats du top, être présent dans le top 10 sur la requête reste la condition d’entrée. À noter : cet effet est à la fois direct (vous êtes cité dans la réponse) et indirect (vous alimentez le consensus qui désigne l’entité retenue).
Exemple : Vous gérez un site sur l’histoire locale et ciblez « qui a fondé telle abbaye ». Une page qui noie le nom du fondateur dans trois paragraphes d’introduction est mal placée pour être retenue. Une phrase claire, avec le nom complet, la date et le lieu, dans une page cohérente avec les autres sources du top, vous donne de meilleures chances de faire partie des résultats cités à l’appui de la réponse.
Thèmes : Questions-réponses, Entités et sémantique, SERP, Featured snippet · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Indicating location status
US-12332957-B2 · déposé le 4 mars 2024, délivré le 17 juin 2025
Inventeurs : Daisuke Ikeda, Ryoichi Imaizumi, Kaleigh S. Smith et 1 autre
Ce brevet décrit une page de résultats qui ne se contente plus d’afficher des commerces : elle ne garde que ceux qui seront encore ouverts quand l’internaute arrivera, en tenant compte du temps de trajet depuis sa position. Les établissements fermés ou injoignables à temps sont écartés de la page, pas juste annotés. Pour le SEO local, le déséquilibre est réel : une fiche avec des horaires faux, incomplets ou mal structurés risque de disparaître avant même d’entrer dans la compétition du classement. À noter qu’on parle ici d’un filtre de présentation et de sélection, pas d’un facteur de ranking classique, et que le brevet ne dit pas comment les horaires sont collectés. Mais le levier est concret et activable, surtout pour tout ce qui relève du local.
En réponse à une requête reçue d’un dispositif informatique, un système de moteur de recherche peut identifier des résultats de recherche, y compris des résultats d’entreprise qui sont associés à des emplacements d’entreprise. Le système de moteur de recherche peut déterminer si des résultats d’entreprise doivent être désignés comme ouverts à un moment particulier sur la base d’horaires d’exploitation associés aux résultats d’entreprise et d’un emplacement associé à la requête.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Vos horaires d’ouverture deviennent une condition d’éligibilité à l’affichage, pas un simple détail de fiche. Il faut les traiter comme une donnée stratégique : fiche Google Business Profile à jour, horaires spéciaux (jours fériés, congés) renseignés, cohérence entre fiche, site et données structurées (balisage schema.org pour les horaires). L’impact est direct (présence ou non dans le sous-ensemble « ouvert ») et indirect (un filtre « ouvert plus tard » permet de capter des requêtes à intention future). La proximité compte aussi : le brevet tient compte du temps de trajet, donc un commerce qui ferme dans 10 minutes et se trouve à 15 minutes de l’internaute peut sauter. Pour les multi-établissements, il faut vérifier les horaires lieu par lieu, pas à l’échelle de l’enseigne.
Exemple : Un restaurant affiche 22h sur son site mais 21h sur sa fiche Google, et oublie de déclarer sa fermeture exceptionnelle du lundi férié. Un internaute à 20 minutes de route le cherche à 21h : le restaurant est écarté des résultats « ouverts », alors que son concurrent aux horaires propres et cohérents reste affiché.
Thèmes : SEO local, SERP, Intention de recherche, Applications mobiles · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Generating augmented output sequences by a neural network using external databases
US-12585658-B1 · déposé le 1er mars 2024, délivré le 24 mars 2026
Inventeur : Terrance Paul McCartney Jr.
Ce brevet décrit un filtre posé APRÈS la génération : le LLM produit sa réponse, on la découpe en sous-séquences (des morceaux de phrases), puis chacune reçoit un score de confiance. Ce score vient d’une recherche par similarité d’embeddings (une représentation numérique du sens du texte) dans plusieurs bases externes, chacune étiquetée avec son propre niveau de confiance. Si un morceau colle à une source jugée fiable, il passe. S’il ne colle à rien de solide, il est supprimé, corrigé ou reformulé (voire la réponse entière est refusée). Pour un GEO, c’est stratégique : cela suggère que ce qui survit dans une réponse générée dépend de la fiabilité de la source qui ressemble le plus à l’énoncé. Votre contenu doit être « proche » d’une base de confiance, sinon il saute. À noter : c’est un brevet, pas la preuve que ce système tourne tel quel en production.
Cette spécification décrit un système mis en œuvre sous forme de programmes informatiques sur un ou plusieurs ordinateurs dans un ou plusieurs emplacements qui génère une séquence de sortie augmentée en utilisant un réseau neuronal de modèle de langage pour générer une séquence de sortie initiale, puis en modifiant, à la suite de l’évaluation de la séquence de sortie initiale en utilisant une pluralité de bases de données externes, la séquence de sortie initiale pour générer la séquence de sortie augmentée.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Les affirmations de vos pages sont potentiellement jugées une à une, par proximité sémantique et non par mots-clés, avec le crédit de la base qui les corrobore. Concrètement : rédigez des énoncés autonomes, précis et sourcés (un fait par phrase, avec son contexte), alignés avec ce que disent les références solides de votre thématique. Les phrases floues, les affirmations isolées sans corroboration ailleurs et les contenus qui s’écartent du consensus sont les premiers candidats à l’effacement ou à la reformulation. Le brevet mentionne aussi des métadonnées indexées (URL source, position dans le document, date de dernière modification), ce qui rend la fraîcheur et la traçabilité de vos pages potentiellement utiles, en impact direct ET indirect.
Exemple : Sur une page qui dit « ce plugin accélère le site de 40 % » sans source ni contexte, cette phrase ne ressemble à aucune base fiable et risque d’être retirée ou adoucie dans une réponse générée. Reformulée en « selon le test X mené sur Y, le temps de chargement passe de A à B », avec la méthode visible et cohérente avec des références reconnues, elle a plus de chances de passer le filtre.
Thèmes : IA générative, RAG, Embeddings, Questions-réponses · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Content snippet generation and storage with generative model content grouping
US-12730848-B2 · déposé le 29 février 2024, délivré le 8 septembre 2026
Inventeurs : Erin Shea Lynch, Clement Dickinson Wright et Rosemary Margaret La Prairie
Ce brevet décrit un système de capture et de rangement d’extraits visuels au niveau de l’OS. L’utilisateur sélectionne une zone d’écran (tap, lasso, gribouillis) et l’extrait est stocké avec sa source (application, URL). Un modèle génératif regroupe ensuite ces extraits par sujet ou par entité, puis les ressort au bon moment, par exemple à partir d’une intention de recherche proactive déduite du contexte. L’interface décrite mélange réponse générative, extrait mémorisé et résultats web classiques. Ce n’est pas un signal de ranking, et rien ne prouve qu’il touche l’index public. Il vaut surtout pour ce qu’il laisse entrevoir : le contenu est de plus en plus consommé en fragments, dont la provenance reste attachée.
Comprendre le monde dans son ensemble peut être difficile. Qu’un individu essaie de comprendre ce qu’est l’objet devant lui, essaie de déterminer où d’autre l’objet peut être trouvé, et/ou essaie de déterminer d’où une image sur Internet a été capturée, la recherche textuelle seule peut être difficile.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le levier est ténu, mais il existe. Un extrait capturé garde sa source, donc ce qui est attribué à votre site dépend de la netteté de ce fragment visuel. Le regroupement se fait par sujet et par entité, ce qui récompense les pages dont l’entité principale est claire et identifiable d’un coup d’œil. Côté GEO, l’interface mêle réponse générée, extrait et résultats web : être cité ou mémorisé passe aussi par un bloc visuellement autoportant, lisible hors contexte. À noter qu’on est sur du personnel (les snippets appartiennent à l’utilisateur), donc rien de mesurable ni de pilotable directement. C’est une piste de conception de contenu, pas un chantier à lancer.
Exemple : Une page comparatif produit avec un tableau clair, un titre explicite et le nom de la marque ou du produit visible dans le bloc lui-même : si un utilisateur le capture, l’extrait reste compréhensible, rattaché à la bonne entité et à votre URL. Un tableau noyé dans un carrousel ou sans légende perd son sens une fois isolé.
Thèmes : IA générative, Personnalisation des résultats, Questions-réponses, Google Discover · Intérêt SEO : 4/10 · Lire le brevet sur Google Patents
Selective presentation of content types and sources in search
US-12468771-B2 · déposé le 7 février 2024, délivré le 11 novembre 2025
Inventeurs : Daniel Belov, Matthew E. Kulick, Adam D. Bursey et 2 autres
Ce brevet décrit une SERP assemblée à partir de trois sources distinctes : les résultats sociaux (contenu généré par les contacts de l’utilisateur), les abonnements (blogs, vidéos suivis) et le web public. Le contenu social n’est affiché que s’il passe des seuils de scores : pertinence par rapport à la requête (topicality), qualité, fraîcheur, avec un traitement spécifique des requêtes en tendance. Pour un SEO, l’intérêt est réel mais ténu. Ce qui est décrit, c’est une personnalisation par utilisateur (graphe social, abonnements), donc une partie de l’affichage échappe à votre contrôle direct. À noter que le brevet ne dit rien sur le classement des pages web publiques : il parle de présentation et de sélection des sources, pas d’un nouveau signal de ranking.
Un grand nombre de résultats de recherche peuvent être renvoyés pour une requête donnée. En conséquence, il peut être difficile pour un utilisateur recherchant de choisir un résultat qui soit le plus pertinent pour l’utilisateur recherchant ou qui fournisse un conseil sur lequel l’utilisateur recherchant est à l’aise de se fonder.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir : votre contenu peut remonter par un autre canal que le classement web classique, celui de l’abonnement et du social, qui dépend de la relation entre l’utilisateur et la source. Concrètement, le levier est indirect : travailler la récurrence et l’abonnement (blog, flux, chaîne vidéo) pour exister dans les « subscription results », et soigner la fraîcheur et la pertinence thématique sur les requêtes en tendance, où le brevet traite le contenu récent différemment. À l’inverse, ne pas surinterpréter : ce n’est pas un critère de ranking du web public, et il est impossible de mesurer ces SERP personnalisées avec un outil de suivi de positions classique (déséquilibre entre ce qu’on mesure et ce que l’utilisateur voit).
Exemple : Vous publiez un blog expert avec une audience qui s’y abonne via un lecteur de flux : sur une requête liée à votre sujet, un abonné peut voir votre article dans un bloc dédié aux abonnements, indépendamment de votre position dans les résultats web publics. Sur une requête en tendance, un article récent et clairement thématisé a plus de chances de franchir le seuil de pertinence qu’un contenu ancien.
Thèmes : Personnalisation des résultats, Réseaux sociaux, Intention de recherche, Positionnement · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Brevets déposés en 2023
Distance based search ranking demotion
US-12724784-B2 · déposé le 20 décembre 2023, délivré le 1er septembre 2026
Inventeur : Neha Arora
Ce brevet décrit une rétrogradation des résultats « locaux » quand ils sont loin de l’utilisateur, sur une requête générique à intention locale implicite (sans nom de ville dedans). Le système ne rétrograde pas à l’aveugle : il vérifie que l’intention locale de la requête est assez forte (mesurée via les logs de requêtes et les clics), qu’un résultat non local suffisamment solide existe, et que le document distant n’a pas de score indépendant de la géographie qui justifie de le garder. Ce qu’il faut retenir, c’est que la popularité locale d’une page ne la protège pas quand l’utilisateur est ailleurs. Le levier est indirect mais réel : il touche la façon dont on construit les pages à ancrage géographique. À noter que ce texte décrit un mécanisme possible, pas une preuve de son poids dans le classement actuel.
Dans un aspect, une méthode détermine qu’un premier document local dans un ensemble de documents locaux pour des résultats de recherche est éligible à une opération de rétrogradation. La détermination est fondée au moins en partie sur une mesure de proximité basée sur l’emplacement de l’appareil utilisateur et un emplacement spécifié pour le premier document local.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Si votre page est classée « locale » (rattachée à un lieu), elle risque de se faire doubler par une page non locale dès que l’internaute est loin de ce lieu et que la requête appelle du local. Pour limiter ce déséquilibre, deux pistes : (1) assumer un ancrage géographique clair et cohérent avec votre vraie zone de chalandise, plutôt que de viser large avec un lieu qui ne correspond à personne ; (2) sur les pages qui ont une vocation plus large, construire une pertinence qui ne dépend pas du lieu (contenu de fond, expertise, utilité générale), parce que c’est précisément ce score indépendant de la géographie qui peut éviter la rétrogradation. Impact direct sur les requêtes hors zone, indirect sur la manière d’arbitrer entre page locale et page nationale.
Exemple : Un cabinet ou une agence qui a une page « conseils et tarifs » très ancrée sur sa ville peut être rétrogradé face à un guide non local quand la recherche vient d’une autre région. En séparant un contenu de fond, utile partout, de la page de service locale, on garde une chance de rester visible hors zone tout en défendant la requête de proximité.
Thèmes : SEO local, Positionnement, Personnalisation des résultats, Intention de recherche · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Generating context-based spell corrections of entity names
US-12566805-B1 · déposé le 15 décembre 2023, délivré le 3 mars 2026
Inventeurs : Lawrence J. Brunsman, Matthieu Devin, Uri N. Lerner et 1 autre
Ce brevet décrit une correction orthographique des noms d’entités (personnes, marques, produits, groupes, œuvres…) qui ne s’appuie pas sur un dictionnaire, mais sur les mots qui gravitent autour du nom dans les textes. Pour faire simple : si vous tapez un nom mal écrit avec des termes de contexte, Google cherche quelle entité cohabite le plus souvent avec ces termes, puis corrige la requête automatiquement. C’est un mécanisme interne, vous ne pouvez pas le « débloquer » avec une balise. Mais il dit quelque chose de très concret sur la façon dont une entité se fait reconnaître : par son entourage lexical. Votre nom de marque est donc aussi défini par les mots qui l’accompagnent. Levier indirect, mais réel.
Cependant, certains termes utilisés dans les requêtes n’apparaissent pas dans ces dictionnaires et, par conséquent, ne peuvent pas être corrigés à l’aide de ces techniques conventionnelles. Par exemple, les noms d’entités, en particulier les noms d’entités ordinaires (non célèbres), n’apparaissent souvent pas dans les dictionnaires.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Mécaniquement, le système mesure la probabilité qu’un terme de contexte apparaisse quand le nom apparaît (la « cohérence de contexte »). Il faut donc associer votre nom de marque, de produit ou de personne, de façon constante, à votre thématique, dans le titre et dans les quelques mots autour de chaque mention. C’est ce qui permet à Google de vous retrouver même quand le nom est mal orthographié. Autre point : le brevet décote les textes dupliqués ou quasi identiques. Mille copies d’un même communiqué ne renforcent pas le signal, des mentions variées sur des sources différentes, oui. Enfin, pensez aux variantes et alias de votre nom : le brevet stocke des formes canoniques et des noms liés. Soyez cohérent dans votre façon de vous nommer, sans multiplier les graphies fantaisistes.
Exemple : Vous avez une marque au nom difficile à écrire, disons un outil SEO au nom exotique. Si vos pages, vos titres et les mentions externes disent toujours « [nom] + outil d’audit SEO », une requête du type « nom mal écrit + audit SEO » a de bonnes chances d’être corrigée vers vous. Si votre nom est cité n’importe où, sans contexte stable, ce rattachement est beaucoup plus fragile.
Thèmes : Intention de recherche, Entités et sémantique, Questions-réponses, SERP · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Contextual search on multimedia content
US-12579152-B2 · déposé le 6 décembre 2023, délivré le 17 mars 2026
Inventeurs : Gökhan Hasan Bakir, Károly Csalogány et Behshad Behzadi
Ce brevet décrit un système qui réécrit la requête d’un utilisateur pendant qu’il regarde une vidéo en streaming, en s’appuyant sur les entités extraites du contenu (personnes, lieux, objets, organisations) et sur leur position dans la timeline. Concrètement, si vous demandez « c’est qui ? » ou « où ça se passe ? » en plein visionnage, le moteur complète la requête avec le contexte de la scène, teste plusieurs réécritures, garde celle qui renvoie le meilleur jeu de résultats, puis affiche la réponse sans couper la lecture. Pour un SEO/GEO, ce n’est pas un signal de ranking classique. Le levier est indirect mais réel : les entités sont puisées dans les métadonnées, le nom de fichier, les commentaires et les annotations, donc dans ce que vous publiez autour de la vidéo. Reste une nuance : le brevet décrit un mécanisme, pas une garantie d’exploitation en production, et il vise surtout l’expérience de streaming.
Lors de la visualisation d’une vidéo particulière, des utilisateurs ont des requêtes liées à des objets apparaissant dans la vidéo. Par exemple, lors de la visualisation de la vidéo, un utilisateur peut vouloir connaître le nom d’une personne apparaissant dans la vidéo lorsque la personne apparaît dans la vidéo.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce que la machine sait d’une vidéo dépend en partie de ce que vous lui donnez à lire : titre, nom de fichier, description, commentaires, annotations. Soignez ces métadonnées en nommant clairement les entités (personnes, marques, lieux, objets) et, quand c’est possible, ancrez-les dans le temps (chapitres, timestamps, transcription). Le brevet stocke aussi des réécritures issues de requêtes historiques liées au contenu, donc plus votre vidéo est associée à des entités sans ambiguïté, plus les requêtes qui l’entourent sont complétées avec un contexte exact. L’impact est direct sur la clarté des entités rattachées à votre média, et indirect sur la visibilité dans les réponses contextuelles. Ne le prenez pas pour un facteur de classement avéré : c’est un levier de lisibilité, pas un bouton magique.
Exemple : Vous publiez un tutoriel vidéo sur la configuration d’un boîtier domotique. Un titre générique du type « Tuto #12 » laisse le moteur deviner. Avec le nom exact du produit et de la marque dans le titre, la description et des chapitres horodatés (« 03:20 – Appairage avec l’application »), une question posée à ce moment précis peut être réécrite avec le bon produit et la bonne étape, et vos contenus deviennent de meilleurs candidats pour y répondre.
Thèmes : Images et vidéos, Entités et sémantique, Intention de recherche, Questions-réponses · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Search result ranking and presentation
US-12298986-B2 · déposé le 28 novembre 2023, délivré le 13 mai 2025
Inventeurs : Chen Zhou, Chen Ding, David Francois Huynh et 6 autres
Ce brevet décrit un moteur qui ne se contente pas de lister des pages : il repère le type d’entité visé par la requête (des bâtiments, des films, des lieux…), devine le modificateur qui s’y cache (« plus haut » devient la propriété « hauteur »), puis classe les résultats selon cette propriété, tirée d’un graphe de connaissances (la base d’entités et de relations de Google). Le modificateur peut être explicite, un superlatif écrit dans la requête, ou implicite, simplement inféré du contexte, par exemple une notion de popularité ou un filtre de plage. Le moteur choisit aussi le format d’affichage (liste, carte, frise, galerie d’images, carrousel horizontal) selon la propriété retenue. Soyons lucides : on ne pilote pas le graphe depuis son site, et le brevet ne livre aucun signal de ranking chiffré. Le levier est indirect, mais il est réel pour la structuration de contenu.
Des méthodes et des systèmes sont fournis pour classer des résultats de recherche et générer une présentation. Dans certaines implémentations, un système de recherche génère une présentation sur la base d’une requête de recherche.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Sur les requêtes à superlatif ou à critère implicite (« meilleur », « plus grand », « pas cher », « récent »), le classement dépend de propriétés mesurables rattachées au type d’entité. Vos pages doivent donc exposer ces propriétés de façon explicite et exploitable : valeurs claires, comparables, balisées en données structurées quand c’est pertinent. Côté présentation, le format (carte, frise, galerie) découle de la nature des données, et les résultats en galerie exigent des vignettes. Des images propres, bien rattachées à l’entité, deviennent stratégiques et non décoratives. À noter que cela vaut en impact direct (être éligible à ces formats) ET indirect (être lisible comme entité dans le graphe).
Exemple : Vous tenez un site sur des lieux à visiter et ciblez « plus beaux châteaux de la Loire » : donnez à chaque fiche des propriétés nettes (localisation, date de construction, image principale légendée) plutôt qu’un pavé de texte. Vous augmentez ainsi vos chances d’être classé sur la bonne propriété et d’apparaître dans une carte ou une galerie.
Thèmes : Positionnement, Intention de recherche, Knowledge Graph, SERP · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Query suggestions based on entity collections of one or more past queries
US-12216669-B1 · déposé le 27 novembre 2023, délivré le 4 février 2025
Inventeurs : Anwis Das, Abhinandan Sujit Das, Nitin Gupta et 1 autre
Ce brevet décrit comment Google personnalise les suggestions de recherche (l’autocomplétion) à partir des requêtes précédentes de l’utilisateur, mais seulement si l’historique est assez récent ou adjacent. Le pivot, c’est l’entité : chaque requête est rattachée à des entités (des « choses » identifiables, pas des chaînes de mots), et une suggestion monte quand ses entités recoupent celles de la session en cours. Il y a aussi un garde-fou : si les requêtes passées ne forment pas une session cohérente sur un même sujet, l’historique est ignoré. Vous n’agissez pas sur un signal de ranking classique ici. En revanche, ça éclaire la façon dont se construisent les parcours de recherche, et donc les requêtes qui arrivent jusqu’à vos pages. À noter que le brevet ne dit rien sur le classement des résultats eux-mêmes : il faut rester prudent sur ce qu’on en déduit.
Un utilisateur peut soumettre une requête à un moteur de recherche pour localiser des informations liées à la requête. Lors de la saisie d’une requête, un utilisateur peut souhaiter obtenir une ou plusieurs suggestions fournies qui sont basées sur la requête saisie.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Les suggestions étant pilotées par le recoupement d’entités, travaillez vos contenus par entités et par parcours plutôt que par mot-clé isolé. Cartographiez les entités qui reviennent dans les sessions de vos cibles (impact direct sur les requêtes de suivi qu’elles se verront proposer) et couvrez ces enchaînements de façon cohérente sur le site (impact indirect : vous êtes présent à chaque étape de la session). Le critère de popularité, qui pondère davantage les entités peu populaires, suggère aussi qu’une entité de niche bien identifiée porte plus de signal qu’une entité générique. Ce qu’il faut retenir c’est que la suggestion n’est pas la même pour tout le monde, donc un test d’autocomplétion en navigation privée ne reflète qu’une partie de la réalité.
Exemple : Un utilisateur cherche « randonnée Vercors », puis tape « gîte » : la suggestion « gîte Vercors randonnée » est favorisée par rapport à un « gîte » générique, parce que leurs entités se recoupent. Un site de gîtes qui publie des contenus liés à l’entité Vercors et aux activités de randonnée se place sur ce type de requête de suivi.
Thèmes : Autocomplétion, Entités et sémantique, Positionnement, Personnalisation des résultats · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Determining relevance of points of interest to a user
US-12346393-B2 · déposé le 29 septembre 2023, délivré le 1er juillet 2025
Inventeurs : Zoltan Gyongyi, Frank Worsley et Darryl Deweese
Ce brevet décrit un pipeline de personnalisation pour la carte et les lieux : Google lit les données personnelles d’un utilisateur (mails, agenda, historique web, localisations passées), en déduit des points d’intérêt (POI, soit un lieu physique), puis les affiche plus ou moins en évidence selon un score de pertinence propre à cet utilisateur. Le déclencheur n’est pas une requête, c’est le contenu personnel, et le score peut même baisser si le lieu est déjà familier. Pour un SEO/GEO, le levier est ténu : rien ici ne touche le classement de vos pages, on est dans un mécanisme interne de produit (cartes, suggestions). À noter que le brevet confirme tout de même la logique d’entités : un lieu est relié à un autre par des relations externes au texte, pas par une simple correspondance de mots. Utile à comprendre, pas de quoi réorganiser vos priorités.
La présente divulgation est généralement dirigée vers des procédés et des appareils permettant de déterminer des points d’intérêt qui sont personnels à l’utilisateur. Plus particulièrement, la divulgation est dirigée vers des procédés et des appareils permettant de déterminer un point d’intérêt pour un utilisateur sur la base de contenu provenant d’une ou de plusieurs sources associées à l’utilisateur et de déterminer un score de pertinence pour le point d’intérêt sur la base d’informations supplémentaires associées à l’utilisateur.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Pour un business local, le levier indirect porte sur la clarté de l’entité lieu : adresse au format standard, nom cohérent partout, codes et termes de contexte (aéroport, gare, quartier) bien associés à votre établissement, et fiche d’établissement à jour. C’est ce qui aide à rattacher un lieu cité dans un contenu à la bonne entité. En revanche, le score étant personnalisé (fréquence, récence, visites, requêtes passées de la personne), vous ne pouvez pas l’optimiser directement. Ne bâtissez aucune stratégie là-dessus.
Exemple : Un hôtel proche d’un aéroport voit son nom, son adresse et sa zone décrits de façon identique sur son site, sa fiche d’établissement et ses annuaires. Si un voyageur reçoit un mail de réservation avec un code d’aéroport, le système a plus de chances de rattacher proprement ce trajet à des lieux de l’entourage, dont l’hôtel, plutôt qu’à une entité ambiguë.
Thèmes : SEO local, Personnalisation des résultats, Intention de recherche, Expérience utilisateur · Intérêt SEO : 4/10 · Lire le brevet sur Google Patents
Session-based user awareness in large language models
US-12572573-B2 · déposé le 28 septembre 2023, délivré le 10 mars 2026
Inventeurs : Ramprasad Sedouram et Dharma Teja
Ce brevet décrit un LLM qui observe comment l’utilisateur interagit avec sa réponse (survol de souris, regard détecté par caméra) pour en déduire qu’un mot n’a pas été compris, puis réinjecte cette info dans le prompt suivant. Le système peut alors proposer une définition, un contexte ou une version simplifiée, et réécrire tout ou partie de la réponse précédente. C’est intéressant pour comprendre où va l’interface conversationnelle, mais le levier SEO direct reste mince : rien ici ne parle de classement, de sélection de sources ou de crawl. C’est de la personnalisation côté session, pas un critère de ranking. À prendre comme un signal de direction, pas comme un plan d’action.
Un défi de ces LLM est qu’ils peuvent ne pas être en mesure de fournir une réponse appropriée à la question d’un utilisateur. Les LLM ne connaissent pas le niveau de connaissances ou d’expertise d’un utilisateur ; par conséquent, le LLM peut fournir une réponse qui est trop complexe pour le niveau de connaissances d’un utilisateur.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Les réponses générées peuvent être réécrites ou simplifiées selon l’engagement de l’utilisateur, donc ce qui compte, c’est que vos contenus restent facilement reformulables à la bonne granularité (phrase, paragraphe, section). Concrètement : définissez vos termes techniques dès leur première apparition, rédigez des passages autonomes et compréhensibles isolés, et évitez le jargon non expliqué. Impact direct limité, mais indirect réel : un contenu clair se fait plus facilement citer, résumer et reformuler sans perte de sens. À noter que le brevet ne dit pas que ces signaux d’engagement influencent la sélection des sources, donc inutile d’en tirer une règle.
Exemple : Dans un article sur le maillage interne, vous écrivez « PageRank interne » sans l’expliquer : si l’utilisateur survole longuement ce terme dans une réponse IA qui vous reprend, le système peut demander une définition ou simplifier le passage. Un paragraphe où le terme est déjà défini en une phrase se prête mieux à cette réécriture.
Thèmes : Recherche conversationnelle, Personnalisation des résultats, Expérience utilisateur, IA générative · Intérêt SEO : 4/10 · Lire le brevet sur Google Patents
Search result filters from resource content
US-12468769-B2 · déposé le 8 septembre 2023, délivré le 11 novembre 2025
Inventeurs : Ian Macgillivray, Kaylin Spitz, Selena Sunling Yang et 3 autres
Ce brevet décrit comment Google fabrique des filtres de recherche (ces petites pastilles de raffinement affichées à côté des résultats) à partir du contenu des pages déjà jugées pertinentes pour une requête, et non à partir d’une taxonomie figée. Les mots extraits du contenu, des métadonnées, des avis et des descriptions sont croisés avec les requêtes liées, puis notés selon leur fréquence et leur proéminence dans les ressources. Pour un SEO/GEO, le levier est indirect mais réel : le vocabulaire de vos pages peut décider si vous apparaissez dans une tranche filtrée ou non. À noter que le brevet cite surtout des requêtes catégorielles (restaurants, avis), donc je ne généraliserais pas à toutes les requêtes. Reste que la logique, elle, est très lisible : ce qui est visible et récurrent dans le corpus devient un filtre.
Une requête de recherche, cependant, est souvent une expression incomplète du besoin informationnel d’un utilisateur. Ainsi, un utilisateur peut souvent affiner une requête de recherche après avoir examiné les résultats de recherche, ou peut sélectionner une « requête suggérée » qui est fournie par un moteur de recherche pour effectuer une autre recherche.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Travaillez les termes qui différencient votre page au sein d’une catégorie (attributs, usages, caractéristiques) et placez-les à des endroits proéminents (titres, intertitres, début de contenu) plutôt que de les enterrer dans des métadonnées. Appuyez-vous sur les requêtes liées à votre requête cible, celles qui mènent réellement à des clics, pour choisir ces termes. Le brevet impose aussi une diversité : deux filtres qui donnent des résultats quasi identiques sont fusionnés, donc inutile de saturer la page de synonymes. Le gain se joue sur des attributs distincts, pas sur la répétition. L’impact est direct (être dans la tranche filtrée) ET indirect (couvrir les facettes que les internautes utilisent pour affiner).
Exemple : Vous gérez un site d’avis de restaurants : si les pages concurrentes mettent en avant « terrasse » ou « végétarien » et pas la vôtre, ces termes risquent de devenir des filtres dont vous êtes exclu. En les affichant clairement dans vos titres et descriptions, avec un vrai contenu derrière, vous augmentez vos chances d’être dans le sous-ensemble filtré.
Thèmes : Query fan-out, SERP, Questions-réponses, Entités et sémantique · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Document entity extraction using machine-learned models
US-12536376-B2 · déposé le 21 août 2023, délivré le 27 janvier 2026
Inventeurs : Vincent Perot, Florian Luisier, Kai Kang et 10 autres
Ce brevet décrit un pipeline d’extraction d’entités à partir de documents (factures, formulaires, PDF scannés) : un modèle de machine learning remplit un schéma cible, puis chaque valeur extraite est revérifiée contre l’emplacement exact où le modèle dit l’avoir trouvée. Si le texte ne correspond pas à ce qui figure réellement dans le document, la valeur est jetée. C’est un vrai garde-fou anti-hallucination, avec en plus un vote majoritaire sur plusieurs générations pour stabiliser le résultat. Rien ne dit que ça pilote le ranking du search, donc on reste sur un levier ténu. Pour un SEO/GEO, c’est surtout un signal de direction. Les pipelines d’extraction sérieux préfèrent les valeurs qu’on peut retrouver telles quelles dans la source.
Les documents peuvent contenir de grandes quantités de données. Les données obtenues à partir de ces documents peuvent ne pas être structurées dans un format souhaité. Certaines portions des données peuvent être associées à des catégories ou à des étiquettes sémantiquement significatives, mais une telle association peut ne pas être explicite dans les données brutes.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le brevet ne décrit ni un signal de classement ni un critère de qualité de page, donc rien à "optimiser" au sens strict. L’enseignement est indirect : une donnée n’est retenue que si elle existe en toutes lettres dans le document, à un endroit identifiable. Pour vos contenus, cela pousse à écrire les faits clés (prix, dates, références, caractéristiques) de façon explicite, littérale et cohérente, sans paraphrase floue ni valeur uniquement implicite. Cela vaut aussi pour les PDF et les images : si le texte repose sur un OCR (la reconnaissance optique de caractères), un texte propre et lisible limite les erreurs de lecture. À noter que ce brevet concerne l’extraction de documents, pas forcément le moteur de recherche. Je le lis donc comme une indication de méthode, pas comme une règle du jeu.
Exemple : Une fiche produit affiche « Autonomie : 12 h » dans un tableau HTML clair, ou un PDF de tarifs aligne un libellé et son prix sur la même ligne en texte sélectionnable. La valeur est facile à extraire et à valider contre la source. À l’inverse, une info glissée dans une image sans texte alternatif, ou reformulée de trois façons différentes dans la page, a plus de chances d’être écartée ou instable à l’extraction.
Thèmes : Données structurées, Questions-réponses, IA générative, Embeddings · Intérêt SEO : 4/10 · Lire le brevet sur Google Patents
Selecting, ranking, and/or presenting microsite content
US-12001496-B1 · déposé le 5 juillet 2023, délivré le 4 juin 2024
Inventeurs : Morten Just Petersen, Francisco Campoy Flores, Emmet J. Connolly et 2 autres
Ce brevet décrit un système où un « microsite » (une petite page ou mini-expérience rattachée à une adresse web) est poussé sur un appareil (montre, smartphone) quand des signaux de capteurs collent à des critères définis à l’avance : lieu, heure, vitesse, mode de transport, son ambiant, appareil ou personne à proximité. Un classement combine ensuite la correspondance aux critères avec l’activité de l’utilisateur et celle de ses contacts. C’est un mécanisme de déclenchement contextuel, pas un système de classement de pages web dans les résultats de recherche. Pour un SEO/GEO, le levier direct est donc très mince, et je préfère vous le dire franchement plutôt que d’enrober.
De nombreuses techniques sont à la disposition des utilisateurs aujourd’hui pour trouver des informations sur le World Wide Web (« web »). Par exemple, les utilisateurs utilisent souvent des navigateurs web et/ou des moteurs de recherche pour trouver des informations d’intérêt.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Aucun signal de ranking activable ici : rien dans le résumé ne dit que le contenu web classique est évalué de cette façon. Ce qu’il faut retenir, c’est la direction : Google travaille sur une pertinence qui dépend du contexte réel de l’utilisateur (où il est, ce qu’il fait, qui l’entoure), et pas seulement de sa requête. Indirectement, cela plaide pour soigner ce qui rend une page « déclenchable » dans un contexte donné : ancrage local, informations situationnelles claires, une adresse (URL) stable et bien définie par usage. À noter que ce sont des déductions de raisonnement, pas des consignes tirées du brevet. Et rien ne prouve que ce système soit déployé tel quel.
Exemple : Si vous gérez un site de restaurants ou d’événements locaux, structurer des pages distinctes par lieu et par moment d’usage (déjeuner sur le pouce, sortie en soirée) reste cohérent avec cette logique contextuelle, sans que le brevet vous demande quoi que ce soit de précis.
Thèmes : Personnalisation des résultats, Intention de recherche, Images et vidéos, Création de contenu · Intérêt SEO : 3/10 · Lire le brevet sur Google Patents
Contextualizing knowledge panels
US-12182142-B2 · déposé le 22 juin 2023, délivré le 31 décembre 2024
Inventeurs : Amit Behal, Randolph G. Brown, Akash Nanavati et 1 autre
Ce brevet décrit comment Google adapte un knowledge panel (le encart d’informations sur une entité, à droite ou en haut des résultats) quand la requête contient une entité ET des termes de contexte. Le panel n’est plus figé : Google choisit, classe et met en forme (gras, police, fond) les éléments de connaissance qui collent au contexte. Pour faire simple, « Ronnie Wood » et « Ronnie Wood The Rolling Stones » ne déclenchent pas le même panel. Le levier n’est pas direct, car vous ne pilotez pas un knowledge panel comme une balise title. Il reste réel : il touche à la façon dont vos entités, et les relations entre elles, sont comprises et exposées.
Un panneau de connaissances est un élément d’interface utilisateur qui fournit des informations, par exemple des faits connus, liées à une entité particulière référencée par une requête de recherche. Le système peut déterminer les informations à inclure dans le panneau de connaissances en identifiant le ou les termes de contexte qui sont associés à l’entité identifiée par la requête de recherche.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir, c’est que la pertinence d’une entité se joue aussi sur ses relations (membre de, fondé en, rattaché à) et sur les termes de contexte qui l’accompagnent. Travaillez donc vos contenus pour que ces associations soient explicites, cohérentes et faciles à extraire : phrases claires, attributs factuels (dates, appartenances, catégories), données structurées sur les entités concernées. Côté recherche de mots-clés, regardez les requêtes « entité + contexte » comme des intentions distinctes, pas comme des variantes. À noter que le brevet ne dit pas que Google lit votre page pour alimenter ce panel : il parle d’une base d’éléments de connaissance. L’impact est donc indirect : cohérence de l’entité, désambiguïsation, présence dans les sources qui nourrissent ces bases.
Exemple : Vous gérez le site d’un groupe de musique ou d’un artiste : au lieu d’une page biographique fourre-tout, structurez des passages et des pages qui rendent explicites les relations (membre du groupe, date de début, albums associés) pour que « artiste + groupe » ressorte avec les bons éléments mis en avant.
Thèmes : Entités et sémantique, Knowledge Graph, SERP, Positionnement · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Providing relevance-ordered categories of information
US-12019664-B2 · déposé le 5 juin 2023, délivré le 25 juin 2024
Inventeurs : Yael Shacham Shazeer, Leland Rechis, Scott Jenson et 1 autre
Ce brevet décrit un mécanisme où Google ne classe pas seulement des documents, mais des blocs entiers de résultats (web, images, news, maps, vidéo, shopping, scholar…) et décide quel bloc s’affiche en premier, selon la requête. Cet ordre repose sur une probabilité qu’une catégorie soit pertinente, calculée à partir des clics passés sur des requêtes similaires et, éventuellement, d’un profil utilisateur, de l’appareil, de la zone géographique ou de l’heure. Pour un SEO/GEO, c’est un levier indirect mais réel : votre visibilité dépend de la catégorie dans laquelle vous êtes présent, pas seulement de votre position dans les résultats web classiques. À noter que c’est un brevet de présentation, pas un signal de ranking de pages : il ne vous dit pas comment grimper, il vous dit où regarder.
Parce que les capacités d’entrée peuvent être plus limitées dans un dispositif mobile (p. ex., un smartphone) que dans un dispositif informatique fixe (p. ex., un ordinateur de bureau), un utilisateur peut devoir fournir plus d’effort pour saisir une requête de recherche (ou d’autres informations) à partir du dispositif mobile qu’il ne serait nécessaire à l’utilisateur pour saisir la même requête de recherche à partir du dispositif informatique fixe. En outre, parce que les affichages dans divers dispositifs mobiles sont souvent plus petits que les affichages dans des dispositifs informatiques fixes, il peut ne pas être possible d’afficher autant d’informations à un moment donné dans un dispositif mobile.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Pour chaque requête stratégique, identifiez quelle catégorie Google a tendance à mettre en avant (images, local, news, vidéo, shopping…), puisque l’ordre découle du comportement des utilisateurs sur des requêtes similaires. Si la catégorie dominante n’est pas le web classique, c’est là qu’il faut investir : fiche locale, flux d’images optimisées, contenus éligibles à l’actualité, vidéos, flux produits. Gardez aussi en tête que l’ordre varie selon l’appareil, le lieu et l’heure : un suivi de positions sur une seule configuration vous donne une vision partielle. Impact direct : votre présence dans la bonne catégorie. Impact indirect : les clics sur les onglets de catégorie nourrissent l’historique qui fixe l’ordre futur, donc ce que les internautes cherchent à faire avec la requête compte autant que le texte de votre page.
Exemple : Sur une requête du type « pizza places », si le comportement agrégé favorise le local, le bloc cartes/établissements passe en tête et les pages web optimisées passent derrière : un restaurateur gagne davantage à soigner sa fiche d’établissement qu’à publier un énième article de blog. À l’inverse, pour un nom de personnalité, un média qui produit des images originales et bien balisées peut capter la catégorie placée en premier.
Thèmes : SERP, Positionnement, Personnalisation des résultats, Expérience utilisateur · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Thematic search
US-12158907-B1 · déposé le 16 mai 2023, délivré le 3 décembre 2024
Inventeurs : Jamie Leach, Danielle Fisher, Jason Blythe et 4 autres
Ce brevet décrit une SERP qui ne se contente plus d’aligner des liens : Google prend les documents qui répondent à la requête, résume leurs passages avec un modèle de langage, regroupe ces résumés en clusters (des paquets de passages proches par le sens), puis étiquette chaque paquet avec une phrase-thème. Ces thèmes s’affichent comme éléments cliquables (listes, cartes, carrousels), et un clic relance une requête plus fine, avec possibilité de sous-thèmes. Ce qui compte pour nous, c’est que l’unité d’analyse est le passage, pas la page, et que le classement des thèmes repose notamment sur le nombre de documents distincts qui les mentionnent. Pour être honnête, rien ne dit que ce soit déployé, et le brevet ne promet aucun gain de position. Mais le levier est réel : votre contenu peut se retrouver rangé (ou absent) sous un thème, selon la pertinence de ses passages.
La présente divulgation concerne un moteur de recherche thématique qui génère des thèmes à partir des résultats de recherche et, dans certains exemples, organise les résultats de recherche par thèmes.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Concevez vos pages comme un ensemble de passages autoportants, chacun avec un sujet clair, plutôt que comme un bloc diffus. Le résumé d’un passage peut s’appuyer sur le titre, les métadonnées et les passages voisins : soignez donc titres, hiérarchie Hn et cohérence de contexte autour de chaque section. Côté stratégie, un thème est priorisé quand beaucoup de documents distincts l’abordent. Couvrir les sous-thèmes récurrents du top des résultats devient donc stratégique, alors que passer à côté vous exclut de la grille thématique. À noter que les thèmes affichés sont aussi une mine pour repérer les angles et sous-intentions que Google déduit lui-même d’une requête.
Exemple : Sur la requête « assurance emprunteur », si le top des résultats fait émerger des thèmes comme « délégation d’assurance », « résiliation » et « tarifs selon l’âge », votre guide qui noie la résiliation dans un paragraphe fourre-tout risque de ne rien alimenter sous ce thème. Une section dédiée, avec un titre explicite et un passage qui se comprend seul, donne à Google un résumé net à rattacher au bon cluster.
Thèmes : Intention de recherche, SERP, Questions-réponses, Embeddings · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Subquery generation from a query
US-12265560-B2 · déposé le 28 avril 2023, délivré le 1er avril 2025
Inventeurs : Vladimir Vuskovic, Joseph Lange, Behshad Behzadi et 1 autre
Ce brevet décrit la façon dont Google découpe une requête composée (typiquement autour d’un « et ») en deux sous-requêtes. Il compare ensuite la qualité attendue de la requête entière à celle des deux morceaux, puis choisit une seule réponse ou deux réponses distinctes. Le contexte est très orienté assistant vocal et commandes, donc il faut rester prudent : rien n’indique que le web search classique fonctionne exactement ainsi. Reste que les signaux de qualité cités (fréquence des requêtes passées, abondance de résultats, réponse connue) sont des indices exploitables sur ce qui rend un morceau de requête « servable ». Pour un GEO, c’est un levier indirect mais réel : vos pages doivent répondre proprement à chaque intention prise isolément, pas seulement à la requête globale.
Cependant, ce processus peut prendre du temps et nécessiter plusieurs interactions de la part de l’utilisateur, car l’utilisateur peut devoir attendre que la première requête s’exécute avant de fournir la seconde requête.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Les requêtes à intentions multiples peuvent être traitées comme deux requêtes séparées. Chaque intention doit donc avoir sa propre réponse nette, identifiable et indexable : un passage dédié, un titre explicite, une réponse directe. Un contenu qui ne traite que le « package » global, sans réponse autonome à chaque sous-partie, risque de perdre la sous-requête pour laquelle un concurrent a une réponse claire. Impact direct : la page est mieux sélectionnée sur chaque morceau. Impact indirect : vous captez aussi les formulations vocales ou conversationnelles, qui ont tendance à enchaîner les demandes. À noter que le brevet favorise les sous-requêtes déjà fréquentes et riches en résultats : ciblez des formulations réelles, pas des tournures inventées.
Exemple : Sur une requête comme « comment configurer un sitemap XML et le soumettre à la Search Console », une page qui mélange tout en un seul pavé est fragile. Deux sections distinctes, « Configurer un sitemap XML » et « Soumettre le sitemap dans la Search Console », chacune avec une réponse directe en tête de bloc, peuvent être servies séparément si Google découpe la requête.
Thèmes : Query fan-out, Intention de recherche, Autocomplétion, Questions-réponses · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Automatically restructuring search campaigns
US-12561382-B2 · déposé le 17 avril 2023, délivré le 24 février 2026
Inventeur : Vineet Verma
Ce brevet ne parle pas du ranking organique : il décrit comment restructurer automatiquement une campagne de liens sponsorisés (type Google Ads). Le système écrase les doublons : URLs de destination identiques une fois les paramètres de tracking retirés, mots-clés quasi identiques fusionnés par fuzzy matching (correspondance approximative de chaînes) et clustering, groupes d’annonces qui se recouvrent regroupés par thème. Pour un SEO pur, le levier est ténu, c’est surtout un mécanisme de rangement côté publicité. Pour un SEO/GEO qui touche aussi au SEA, c’est une bonne illustration de la logique « un thème, un groupe, une landing page » (et de ce qu’une machine considère comme un doublon). Ce qu’il faut retenir : le brevet ne dit rien sur l’organique, n’extrapolez pas.
Les ensembles de données requis pour construire et maintenir des campagnes de recherche efficaces sont souvent volumineux. Les inefficiences dans la conception de tels ensembles de données entraînent des répétitions de mots-clés sur plusieurs campagnes, l’affectation d’un nombre excessif de campagnes et/ou de groupes de contenu à la même page de destination, la duplication du même texte de contenu tiers sur plusieurs campagnes et groupes, etc.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Côté SEA, une structure propre (un thème distinct par groupe, une landing page par intention, pas de mots-clés quasi jumeaux répartis dans plusieurs campagnes) est celle vers laquelle le système cherche à converger. Côté SEO, l’enseignement est indirect : des URLs qui ne diffèrent que par des paramètres de tracking sont vues comme une même ressource, donc autant les garder propres et ne pas multiplier les pages qui répondent au même thème. Rien de plus, et c’est déjà un déséquilibre à corriger plutôt qu’un levier de ranking.
Exemple : Votre compte SEA a trois campagnes qui visent « chaussures running homme », « chaussure de running homme » et « running chaussures homme », toutes vers la même fiche avec des paramètres UTM différents. Le système y voit un seul thème et une seule destination : vous gagnez à fusionner en un groupe, ce qui évite aussi de vous mettre en concurrence avec vous-même.
Thèmes : Recherche de mots-clés, Maillage interne, Embeddings, Intention de recherche · Intérêt SEO : 3/10 · Lire le brevet sur Google Patents
Predictive query completion and predictive search results
US-12566784-B2 · déposé le 31 mars 2023, délivré le 3 mars 2026
Inventeurs : Othar Hansson, David Black, Jon M. Wiley et 7 autres
Ce brevet décrit une interface qui n’attend plus que l’internaute valide sa requête : après un court délai sans frappe, elle va chercher des résultats pour les suggestions les plus probables (celles dont la probabilité d’être choisies dépasse un seuil) et les affiche, parfois en groupes distincts. Pour un SEO/GEO, ce n’est pas un signal de ranking, et le texte ne dit rien de nouveau sur la façon dont les pages sont classées. Ce qu’il faut retenir, c’est que la requête « vue » par le moteur peut être une suggestion jamais tapée en entier, et que le terrain de jeu se déplace donc vers l’autocomplétion. Le levier est indirect mais réel, à condition de ne pas lui faire dire plus qu’il ne dit.
Certains systèmes de recherche fournissent également des résultats de recherche prédits avec des suggestions de requête. Cependant, de nombreuses suggestions de requête ne sont pas sélectionnées par un utilisateur. En conséquence, l’utilisateur peut recevoir de nombreux résultats de recherche qui ne satisfont pas le besoin d’information de l’utilisateur.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Les suggestions deviennent une porte d’entrée à part entière : un internaute peut voir vos résultats pour une suggestion qu’il n’a jamais validée. Votre pertinence se joue donc aussi sur les requêtes probables à partir d’un début de saisie (un mot, une syllabe, un bi-gram, c’est-à-dire deux mots consécutifs). Le brevet précise que la probabilité de sélection s’appuie sur l’historique des requêtes et des clics, ce qui rend stratégique le travail sur les requêtes fréquentes et leurs variantes les plus naturelles. Impact direct : être bien classé sur la requête suggérée. Impact indirect : le brevet n’établit pas que cet affichage prédictif compte comme une impression mesurée, donc prudence sur l’interprétation de vos données Search Console. À noter que rien ici ne prouve un fonctionnement identique en production, c’est un mécanisme protégé, pas un comportement confirmé.
Exemple : Un lecteur tape « crawl bud » : si la suggestion « crawl budget » dépasse le seuil de probabilité, ses résultats peuvent s’afficher avant toute validation. Votre page doit donc être solide sur « crawl budget » (la requête complète probable), pas seulement sur le fragment tapé.
Thèmes : Autocomplétion, Intention de recherche, SERP, Positionnement · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Matching search queries to application content
US-12554786-B2 · déposé le 21 mars 2023, délivré le 17 février 2026
Inventeurs : Thomas McColgan, Ana-Cristina Rogoz, Krishna Kanth Tatavarthi et 8 autres
Ce brevet décrit comment Google fait le lien entre une requête et du contenu qui vit dans une application. Il s’appuie pour cela sur les ressources web indexées, et pas seulement sur la fiche de l’app dans le store. Si l’app n’est pas installée sur l’appareil, Google renvoie une réponse personnalisée : un texte dans la langue de la requête, un lien vers l’installation, puis un deep link (lien profond, qui ouvre directement le bon écran de l’app et saute la page d’accueil) une fois l’app installée. Ce n’est pas un signal de ranking classique, donc je ne vais pas vous vendre du rêve. Le levier est indirect, mais il est réel : pour que Google rattache un contenu à une app, il faut que ce contenu existe sur le web, indexable, avec une correspondance claire. Et pour les sites qui ont une app (média, e-commerce, streaming), c’est loin d’être inutile.
De nombreux fournisseurs de contenu offrent des applications, telles que des applications mobiles, qui servent du contenu, tel que des vidéos, de la musique, du texte, etc., aux utilisateurs. Cependant, le contenu disponible par l’intermédiaire de ces applications est souvent indisponible pour les moteurs de recherche, car les moteurs de recherche sont incapables d’indexer le contenu disponible via les applications.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Si vous avez une app, vos pages web indexées servent de pont entre la requête et le contenu interne de l’app. Concrètement, chaque contenu important (titre, produit, média) doit avoir une URL web propre, crawlable, avec un titre et un texte explicites, dans la bonne langue. Le brevet filtre d’abord les ressources par langue de la requête (et parfois par domaine associé à cette langue), donc un site multilingue mal structuré se met lui-même en déséquilibre. À noter aussi que la page web doit être clairement identifiable comme accessible via l’app : la cohérence entre web et app (deep links, association des deux) devient stratégique, pas décorative. L’impact est direct sur la visibilité de l’app dans les résultats, et indirect sur le trafic qui en découle.
Exemple : Une plateforme de streaming musical a une page web par morceau, indexée, avec titre et artiste en clair, plus une app associée. Un utilisateur qui cherche ce morceau sans avoir l’app peut voir une réponse qui nomme le morceau, propose l’installation, puis ouvre l’app directement sur ce titre après installation. Sans page web exploitable, Google n’a rien à rattacher à la requête.
Thèmes : Applications mobiles, SEO international, Positionnement, Intention de recherche · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Generative summaries for search results
US-11769017-B1 · déposé le 20 mars 2023, délivré le 26 septembre 2023
Inventeurs : Matthew K. Gray, John Blitzer, Corinn Herrick et 7 autres
Prolongé par la continuation US-12118325-B2 (15 octobre 2024)
Ce brevet décrit comment Google fabrique un résumé génératif (type AI Overviews) posé au-dessus des résultats de recherche. Le LLM ne part pas seulement de la requête : il digère le contenu de documents déjà sélectionnés comme pertinents, puis rend une synthèse avec des liens vers ses sources. Pour nous, c’est stratégique : être dans le jeu de documents sélectionnés, c’est la condition pour nourrir la réponse. Le brevet ajoute des détails exploitables : certains passages sont rattachés à un document qui les « vérifie », et le résumé peut être révisé selon ce que l’utilisateur a déjà consulté. À noter que c’est un brevet, pas la preuve que tout est déployé tel quel. Mais la direction est claire.
Le traitement du contenu supplémentaire peut, par exemple, atténuer les occurrences où le résumé fondé sur le langage naturel comprend des inexactitudes et/ou peut atténuer les occurrences où le résumé fondé sur le langage naturel est trop spécifié et/ou insuffisamment spécifié.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le point de départ reste la sélection : les documents sont choisis sur des mesures dépendantes de la requête, indépendantes de la requête (qualité intrinsèque) et dépendantes de l’utilisateur, avec en plus des documents issus de requêtes proches. Il faut donc couvrir l’intention principale ET les requêtes voisines, sinon on se prive d’une porte d’entrée. Ensuite, le rattachement d’un passage du résumé à un document qui le confirme pousse à écrire des affirmations nettes, factuelles et vérifiables, faciles à extraire et à citer. Enfin, une visite compte : si l’utilisateur consulte votre page, le résumé révisé peut passer à l’étape suivante, donc votre page doit apporter ce que la synthèse ne donne pas (détail, preuve, cas concret, étape d’après), pas juste répéter la réponse. L’impact est direct (citation dans le résumé) ET indirect (clic, durée de lecture, qui déclenchent la révision).
Exemple : Vous avez un guide sur « comment migrer un site vers HTTPS ». Structurez-le avec des affirmations précises et sourçables par section, puis ajoutez des angles proches (redirections, certificats, mixed content) qui répondent à des requêtes voisines. Ainsi votre page a plus de chances d’alimenter le résumé, et de rester utile une fois que l’utilisateur l’a lue et que la synthèse se met à jour.
Thèmes : IA générative, AI Overviews, Questions-réponses, SERP · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Determining responsive content for a compound query based on a set of generated sub-queries
US-12067040-B2 · déposé le 30 janvier 2023, délivré le 20 août 2024
Inventeurs : Joseph Lange, Mugurel Ionut Andreica et Marcin Nowak-Przygodzki
Ce brevet décrit comment un assistant vocal prend une requête composée (« When were Romania and Poland founded ») et la découpe en sous-requêtes, chacune envoyée comme commande à un agent qui renvoie son contenu. Le système génère plusieurs découpages candidats à partir de patterns (des gabarits de requêtes connus, avec un type d’entité à remplacer par des alias), puis note chaque ensemble selon sa probabilité de coller à l’intention. Il peut aussi préférer la requête non découpée si elle a le meilleur score. Soyons clairs : le cadre est l’assistant vocal et ses agents, pas le moteur de recherche classique, donc le levier direct pour votre SEO reste ténu. Ce qu’il faut retenir, c’est la logique de fond : une requête multi-entités est traitée comme plusieurs questions simples, et la réponse finale peut être recomposée à partir de plusieurs sources.
Bien que divers systèmes informatiques puissent répondre de manière appropriée à de nombreuses requêtes, de nombreux systèmes échouent pour les requêtes composées. Par exemple, de nombreux systèmes informatiques échouent pour une énonciation d’utilisateur de « Quelle heure est-il à Paris, France, quelle est la population, et quelle est la température maximale moyenne en juillet ».
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Pensez vos contenus au niveau de l’entité et de la question unitaire. Une page qui traite plusieurs entités en vrac sera moins facile à réutiliser qu’un contenu où chaque entité a sa réponse nette, identifiable et autonome. Pour le GEO, c’est stratégique : si une réponse est recomposée à partir de plusieurs résultats partiels, mieux vaut être la source qui répond proprement à chaque sous-question plutôt que celle qui noie tout dans un seul bloc. À noter que le brevet ne prouve pas que Google Search fonctionne ainsi : c’est une piste de structuration, pas une règle.
Exemple : Sur un comparatif « fondation de la Roumanie et de la Pologne », prévoyez une section ou une phrase d’ouverture distincte par entité (« La Roumanie a été fondée en… », « La Pologne a été fondée en… »), plutôt qu’un paragraphe fusionné. Chaque sous-question trouve alors sa réponse directement extractible.
Thèmes : Query fan-out, Recherche conversationnelle, Questions-réponses, Embeddings · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Brevets déposés en 2022
Refined search with machine learning
US-12524476-B2 · déposé le 21 décembre 2022, délivré le 13 janvier 2026
Inventeurs : Golden Gopal Krishna, Carl Magnus Borg, Miroslav Bojic et 6 autres
Ce brevet décrit une interface de recherche où le moteur déduit plusieurs critères à partir d’une requête, d’un historique ou d’une page en cours de lecture. Il leur attribue un niveau de confiance, puis expose les critères les moins sûrs sous forme de contrôles cliquables pour affiner le résultat sans retaper de requête. Chaque choix de l’utilisateur (ou son absence de réaction) sert ensuite de signal d’entraînement au composant de machine learning. C’est intéressant pour comprendre la logique, mais le levier SEO direct reste ténu : on parle d’une mécanique d’interface et de boucle de feedback, pas d’un critère de ranking que vous pouvez activer. À noter que le brevet reste sobre sur la façon dont les critères sont extraits d’un contenu. Utile pour le raisonnement, peu pour la checklist.
Même avec ces algorithmes de recherche complexes, toutefois, les techniques de recherche conventionnelles peuvent ne pas fournir un résultat souhaité. Cela peut être dû à un manque d’information, ou, plus couramment, à un échec à utiliser correctement les différentes parties de l’information, telles que quels termes accorder une confiance plus élevée que d’autres, et comment corréler différents termes et actions d’utilisateur pour discerner ce qui importe le plus et comment les utiliser pour obtenir le résultat souhaité.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir : un moteur peut décomposer un contenu en entités (lieux, personnes, marques) pondérées par la confiance, et les entités secondaires deviennent des portes d’entrée pour affiner une recherche. Concrètement, rendez les entités de vos pages non ambiguës (nom complet, contexte clair, cohérence entre titres, texte et données structurées) pour qu’elles soient correctement extraites. Travaillez aussi la satisfaction après le clic : le brevet traite l’absence d’interaction ou une nouvelle recherche comme un signal négatif, et une interaction avec le résultat affiné comme un signal positif. L’impact est indirect, mais cohérent avec une pertinence mesurée par le comportement. Rien dans le texte ne prouve que cela s’applique tel quel au ranking web classique, donc restez prudent.
Exemple : Un article de blog sur une ville cite un parc, une équipe locale et une architecte. Si l’architecte n’est mentionnée qu’au détour d’une phrase, elle sera un critère à faible confiance, donc affinable. Une section dédiée, avec son nom complet et le bâtiment associé, aide le moteur à comprendre cette entité et à vous proposer comme réponse quand l’utilisateur resserre sa recherche dessus.
Thèmes : Intention de recherche, Personnalisation des résultats, Expérience utilisateur, Embeddings · Intérêt SEO : 4/10 · Lire le brevet sur Google Patents
Personalized network searching
US-11547853-B2 · déposé le 9 mai 2022, délivré le 10 janvier 2023
Inventeurs : Gregory Joseph Badros et Stephen Lawrence
Ce brevet décrit un moteur qui fusionne l’index global avec un jeu de données propre à l’utilisateur (favoris, notes, annotations, historique), le tout synchronisé entre ses appareils. Les résultats personnalisés sont marqués, et une publicité est choisie à partir de ces mêmes données. Pour un SEO/GEO, c’est utile à comprendre, mais le levier reste ténu. Tout se joue dans l’espace privé de l’utilisateur, et vous n’y avez aucune prise directe. Ce qu’il faut retenir : le classement n’est pas le même pour tout le monde. À noter que le brevet décrit un mécanisme, pas une garantie de ce qui est déployé aujourd’hui.
En conséquence, les signets que l’utilisateur continue d’utiliser constituent une ressource précieuse pour l’utilisateur. Un utilisateur d’Internet a souvent des difficultés à propager les signets entre les diverses machines dont dépend l’utilisateur.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Vous ne pouvez pas piloter les favoris de quelqu’un, mais vous pouvez travailler ce qui pousse un lecteur à vous garder en mémoire : une ressource qu’on veut retrouver (outil, référentiel, guide de référence), une marque qu’on retape directement, un contenu qui mérite d’être gardé sous la main. L’impact est indirect : si une page est enregistrée, elle peut remonter pour cet utilisateur, et l’historique d’usage entre aussi en jeu. Côté suivi, un rang observé en navigation neutre ne reflète donc qu’une partie de ce que voit l’utilisateur réel. Gardez cette nuance en tête quand vous lisez un écart entre un client et vos relevés de positions.
Exemple : Vous publiez un glossaire ou un comparatif régulièrement mis à jour, conçu pour être consulté plusieurs fois. Les lecteurs qui le mettent en favori ont de bonnes chances de le retrouver bien placé sur leurs requêtes, alors que votre outil de suivi de positions vous affiche un rang plus modeste.
Thèmes : Personnalisation des résultats, Intention de recherche, Autocomplétion, Applications mobiles · Intérêt SEO : 4/10 · Lire le brevet sur Google Patents
Predictive generation of search suggestions
US-12554750-B2 · déposé le 12 avril 2022, délivré le 17 février 2026
Inventeurs : Michal Grabowski, Amanda M. Moore, Alireza Ali et 2 autres
Ce brevet décrit un système qui propose des suggestions et des résultats locaux avant même que l’utilisateur ait validé sa recherche, à partir de sa position, des premiers caractères tapés et de l’historique des clics des autres utilisateurs situés à proximité. Les résultats sont classés selon le nombre de sélections passées, puis regroupés par catégories. Pour un SEO, le levier n’est pas un facteur de ranking classique : on ne peut pas "optimiser" un historique de clics. Il reste réel pour tout ce qui est local, parce que la visibilité se joue ici avant la requête, sur la popularité observée dans une zone et sur la catégorie rattachée à l’établissement. À noter que le brevet reste un document de principe : rien n’indique le poids de chaque signal dans le produit réel, donc on évite de sur-interpréter.
Les utilisateurs de moteurs de recherche s’intéressent souvent à des informations spécifiques à leur emplacement. Par exemple, les utilisateurs peuvent vouloir connaître la météo locale, ou peuvent être intéressés par la politique locale ou le sport.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Pour une activité locale, la visibilité dépend de signaux comportementaux (clics sur votre fiche, popularité dans une zone donnée) et de votre rattachement à la bonne catégorie. Il devient stratégique de soigner la catégorie principale de la fiche d’établissement, la cohérence de l’adresse et de la localisation, et tout ce qui donne envie de cliquer sur votre résultat plutôt que sur celui du voisin (titre, avis, photos, horaires). Il faut aussi travailler les requêtes courtes et partielles du type « type d’activité + ville/quartier », puisque c’est là que la suggestion se déclenche. Impact direct : être proposé avant la saisie complète. Impact indirect : un résultat souvent sélectionné nourrit les logs qui servent ensuite à classer les suivants (effet boule de neige, ou déséquilibre qui s’auto-entretient, selon que vous êtes devant ou derrière).
Exemple : Un restaurant italien de quartier dont la fiche est classée dans la catégorie « restaurant » générique, avec peu de clics, a toutes les chances d’être noyé derrière ses concurrents. En le rattachant à la bonne catégorie (« pizzeria » ou « restaurant italien »), en travaillant l’attractivité de la fiche pour récolter plus de sélections, il augmente ses chances d’apparaître dans le groupe de résultats proposé à un passant qui vient d’ouvrir la recherche.
Thèmes : Autocomplétion, SEO local, Expérience utilisateur, Personnalisation des résultats · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Natural Language Processing with an N-Gram Machine
US-2022171942-A1 · demande de brevet déposée le 15 février 2022
Inventeurs : Ni Lao, Jiazhong Nie et Fan Yang
Ce brevet décrit une architecture de question-réponse en deux temps : un encodeur transforme un texte en graphe de connaissances fait de n-grammes (de petites séquences de mots, avec un horodatage d’ordre d’apparition), puis un « programmeur » traduit la question en mini-programme exécuté sur ce graphe. Pour faire simple, on ne cherche plus la réponse dans le texte brut, on la calcule sur une représentation symbolique de ce texte. C’est intéressant pour comprendre comment une machine peut extraire un fait précis, y compris un fait d’ordre temporel (« qui a fait quoi en premier »). Mais le levier reste ténu. Rien n’indique que ce système tourne dans Search ou dans une réponse générative, et tout se joue à l’entraînement, donc hors de portée d’un consultant.
Le traitement du langage naturel (NLP) peut impliquer de répondre à des questions en langage naturel sur la base d’informations contenues dans des documents en langage naturel. Répondre avec exactitude à de telles questions peut souvent impliquer une analyse sémantique à la fois des questions en langage naturel et des documents. Une analyse sémantique efficace repose souvent sur une base de connaissances élaborée par des humains avec un schéma défini manuellement.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir, c’est une direction de lecture plutôt qu’un levier : plus un fait est énoncé en phrases courtes, explicites et ordonnées, plus il se laisse convertir en énoncés extractibles (sujet, relation, objet) et interroger avec précision. L’ordre des événements compte aussi, puisque le brevet stocke la chronologie d’apparition. Je ne vous dis pas de réécrire vos contenus pour ce brevet (il n’est pas prouvé en production), mais de vérifier que vos pages stratégiques posent leurs faits de façon non ambiguë, avec dates et séquences claires. L’impact est direct sur la lisibilité pour une machine, indirect sur le ranking, et c’est de toute façon une bonne pratique éditoriale.
Exemple : Une page « historique de l’entreprise » qui écrit « En 2015, la société a lancé le produit A, puis en 2018 le produit B » se convertit proprement en énoncés ordonnés. Une page qui noie ces dates dans un paragraphe de storytelling flou rend la question « quel produit est sorti en premier ? » beaucoup plus fragile à résoudre.
Thèmes : Questions-réponses, Embeddings, Knowledge Graph, RAG · Intérêt SEO : 4/10 · Lire le brevet sur Google Patents
Brevet déposé en 2021
Query recommendations for a displayed resource
US-11574013-B1 · déposé le 10 septembre 2021, délivré le 7 février 2023
Inventeurs : Michal Jastrzebski, Aurelien Boffy, Gokhan H. Bakir et 2 autres
Ce brevet décrit un mécanisme où l’utilisateur, sans rien taper ni dire, déclenche une demande de contexte sur la page qu’il consulte (appui long, bouton dédié…). Le serveur génère alors des requêtes candidates à partir du contenu affiché, les note, et ne renvoie que les meilleures sous forme de cartes cliquables. Pour un SEO/GEO, ce n’est pas un signal de ranking : c’est une porte d’entrée vers la recherche qui passe par VOTRE page. Le levier est indirect mais réel : le contenu de la page sert de matière première aux requêtes suggérées. À noter que le brevet reste prudent : il décrit des signaux de scoring possibles, pas une recette garantie.
Les modèles d’interaction typiques exigent que les utilisateurs fournissent une certaine forme de requête utilisateur à un dispositif utilisateur. Par exemple, un utilisateur peut être en train de consulter un article sur une pièce particulière d’équipement sportif sur un smartphone et dire « montrez-moi des avis sur cet article. »
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Les requêtes proposées sont dérivées de ce qui est affiché, avec un poids explicite pour l’apparence visuelle des termes et leur présence dans le titre. Votre title, vos titres et vos termes mis en avant orientent donc les requêtes que Google pourrait suggérer à partir de votre page. Le scoring tient aussi compte de la qualité des résultats pour la requête, de l’engagement et du taux de reformulation : une requête sans résultats ou souvent raffinée est écartée. Concrètement, il faut des titres clairs, des termes-clés visibles et bien hiérarchisés, et une page dont le sujet débouche sur des requêtes qui ont de bons résultats derrière. Impact direct : vous maîtrisez ce que la page « dit » à la machine. Impact indirect : vous influencez les recherches que vos lecteurs lancent ensuite depuis cette page.
Exemple : Sur un article de comparatif de robots tondeuses, un title qui nomme clairement le produit et le critère (« autonomie », « pente maximale ») et des sous-titres bien visibles donnent au système des termes propres à combiner en requêtes de qualité. À l’inverse, un titre vague noyé dans un décor chargé produit des candidats flous, probablement écartés au scoring.
Thèmes : Intention de recherche, Autocomplétion, Questions-réponses, Recherche conversationnelle · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Brevets déposés en 2020
Providing search results based on a compositional query
US-11762933-B2 · déposé le 27 novembre 2020, délivré le 19 septembre 2023
Inventeurs : Jinyu Lou, Ying Chai, Chen Ding et 6 autres
Ce brevet décrit comment Google répond à une requête « composée » du type « banques américaines près de restaurants japonais ». Le système identifie deux types d’entités et une relation entre elles (ici la distance), puis compare des attributs stockés dans un graphe de connaissances ou dans des tables précalculées. Le résultat s’affiche sur une carte ou une frise, avec un curseur pour élargir ou resserrer le critère. Ce n’est pas du ranking web classique : on est sur de la réponse construite à partir d’entités et de leurs attributs. Le levier SEO direct est mince, mais il confirme une logique à garder en tête pour le local et les requêtes relationnelles : ce qui compte, c’est que vos entités soient bien identifiables et que leurs attributs (localisation, type, dates) soient propres et cohérents.
Les moteurs de recherche résolvent généralement des requêtes telles que [Starbucks près de l’aéroport de San Francisco] ou [Films tournés pendant la Seconde Guerre mondiale] en renvoyant une collection de résultats fondée sur un seul critère de localisation fixe ou sur un seul critère temporel fixe.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Pour ces requêtes, la visibilité ne dépend pas d’un classement de pages mais de la présence de votre entité, correctement typée et dotée d’attributs fiables, dans les données que le système interroge. Le levier est donc indirect : soigner les données structurées, la cohérence des informations d’établissement (adresse, catégorie, coordonnées, dates d’événements) et la clarté du type d’entité. Le brevet ne dit pas que ces signaux alimentent le graphe, il décrit seulement ce que le système compare une fois les données disponibles. À noter aussi qu’un terme flou comme « près de » est traduit en seuil par une correspondance prédéfinie, ce qui échappe totalement à votre contrôle.
Exemple : Un cabinet d’avocats cherche à apparaître sur « avocat près d’une gare ». Il vérifie que sa fiche et son balisage indiquent clairement son type d’activité et une adresse précise, de sorte que l’entité puisse être comparée à une gare sur le critère de distance.
Thèmes : Knowledge Graph, Entités et sémantique, SEO local, Questions-réponses · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Surfacing user-specific data records in search
US-11809503-B2 · déposé le 1er juillet 2020, délivré le 7 novembre 2023
Inventeurs : Chengling Chan, Maureen Heymans et Jason L. Smart
Ce brevet décrit un bloc de résultats personnalisé, affiché en haut ou sur le côté de la page. Il s’alimente avec les données privées de l’utilisateur (mails, agendas, réservations de vol ou de restaurant, achats), et sa visibilité dépend de la proximité temporelle de l’événement avec le moment de la requête. Techniquement, c’est intéressant : des règles de déclenchement (knowledge panel, correspondance avec un terme de la requête) décident si ce bloc apparaît, et l’intention est inférée à partir des résultats classiques. Pour un SEO/GEO, le levier reste mince, parce que ces données vivent dans l’espace privé de l’utilisateur, que vous ne contrôlez pas et que vous ne pouvez pas optimiser. Utile à comprendre, pas à activer.
Les utilisateurs de systèmes de recherche recherchent souvent des informations concernant une entité spécifique. Par exemple, les utilisateurs peuvent vouloir en apprendre davantage sur un chanteur qu’ils viennent d’entendre à la radio. Classiquement, l’utilisateur lancerait une recherche pour le chanteur et sélectionnerait parmi une liste de résultats de recherche déterminés comme étant pertinents pour le chanteur.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Aucun levier direct : vos pages ne peuvent pas entrer dans ces enregistrements. L’impact indirect est à garder en tête : sur certaines requêtes à forte intention transactionnelle ou de voyage (réservation, vol, hôtel, restaurant), une SERP peut afficher en tête du contenu personnel qui repousse les résultats organiques. Cela justifie d’être prudent avec les baisses de clics ou d’impressions sur ces requêtes avant de conclure à un problème de contenu, et de ne pas lire une SERP comme identique pour tout le monde. Ce qui reste stratégique, c’est de répondre aux intentions qui précèdent ou suivent la réservation (infos pratiques, annulation, accès, avis), là où le bloc personnel ne répond pas.
Exemple : Un utilisateur a un vol réservé dans deux jours et cherche le nom de la compagnie : sa réservation s’affiche en haut de page, et vos résultats descendent d’un cran. À l’inverse, s’il a un vol datant de plusieurs mois, le seuil de temps n’est pas respecté et l’enregistrement reste discret, voire sur le côté. Votre position moyenne ne bouge pas, mais le clic, lui, se joue différemment selon la personne.
Thèmes : Personnalisation des résultats, Intention de recherche, SERP, Positionnement · Intérêt SEO : 3/10 · Lire le brevet sur Google Patents
Systems and methods for using document activity logs to train machine-learned models for determining document relevance
US-12718022-B2 · déposé le 15 juin 2020, délivré le 25 août 2026
Inventeurs : Weize Kong, Michael Bendersky, Marc Najork et 3 autres
Ce brevet décrit comment entraîner un modèle de similarité sémantique à partir des journaux d’activité de documents (ouverture, partage, édition, déplacement…) : deux fichiers consultés dans la même courte fenêtre de temps sont considérés comme liés, et le modèle apprend à rapprocher leurs contenus. Il est ensuite réutilisé au moment de la recherche pour classer les résultats d’une requête. Le terrain visé, c’est le stockage cloud et les documents privés, là où les clics sont rares et où les liens n’existent pas. Pour un SEO/GEO, le levier est ténu : ces logs d’accès ne sont pas accessibles sur le web public, et rien ne dit que ce mécanisme s’applique au classement de vos pages. Ça reste utile à comprendre comme illustration d’une tendance de fond (apprendre la pertinence à partir du comportement plutôt que des seuls mots), mais sans levier directement activable.
Les systèmes et méthodes de la présente divulgation sont orientés vers une méthode d’entraînement d’un modèle d’appariement sémantique appris par machine. La méthode peut inclure l’obtention d’un premier et d’un second document ainsi que d’un premier et d’un second journal d’activité. La méthode peut inclure la détermination, sur la base du premier journal d’activité du document et du second journal d’activité du document, d’une étiquette de relation indiquant si les documents sont liés.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir, c’est que le brevet ne vous donne aucune action à lancer demain sur un site public : il concerne des environnements privés, sans clics ni liens. Le seul enseignement transposable reste du raisonnement : la similarité sémantique d’un contenu (ses embeddings, des représentations numériques du sens) peut être calibrée sur des usages réels, donc un contenu qui s’inscrit dans un ensemble cohérent de pages consultées ensemble a plus de chances d’être jugé proche d’une requête. Cela plaide, de façon indirecte et prudente, pour des clusters thématiques cohérents et un parcours logique entre contenus, sans prétendre que Google applique ce brevet au web ouvert.
Exemple : Si vous gérez un site de documentation ou un espace client (type base de connaissances), structurez les guides qui sont naturellement lus à la suite (installation, configuration, dépannage) en un parcours clair et maillé : c’est un bon réflexe de pertinence, même si ce brevet ne prouve pas qu’il pèse sur le classement public.
Thèmes : Embeddings, Positionnement, Expérience utilisateur, Intention de recherche · Intérêt SEO : 3/10 · Lire le brevet sur Google Patents
Brevets déposés en 2019
Presenting search result information
US-11775535-B2 · déposé le 11 décembre 2019, délivré le 3 octobre 2023
Inventeurs : Michael Frumkin, Benedict A. Gomes, Christopher Rohrs et 6 autres
Ce brevet décrit un système où les « web notebooks » (des carnets d’utilisateurs avec extraits de pages clippés, annotations, titres et métadonnées) servent de signal de pertinence supplémentaire. Si votre requête colle au contenu d’un carnet qui référence une page, cette page grimpe, même quand son propre texte ne contient pas les termes recherchés. Ces extraits peuvent aussi alimenter le snippet à la place d’un résumé tiré de la page. C’est intellectuellement séduisant : le contenu d’une page se trouve alors qualifié par ce que les autres en disent. Reste que rien ne dit que ce mécanisme tourne aujourd’hui à grande échelle, et que vous ne maîtrisez pas les carnets des internautes. Le levier est donc ténu, utile surtout pour la compréhension.
Le présent document décrit la présentation d’informations de résultats de recherche générées par ordinateur. En général, les résultats de recherche sont présentés comme ayant leur présentation ou leur ordre affectés par le contenu de carnets Web.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Retenez le principe plutôt que la mécanique : la façon dont les utilisateurs décrivent, résument et annotent votre page peut devenir un vecteur de découverte, indépendamment de votre texte. Côté actionnable, soignez les passages « clippables » (définitions nettes, phrases autoportantes, chiffres et visuels bien isolés), car ce sont eux qu’un utilisateur copiera et qui pourraient servir d’extrait. Ne comptez pas dessus comme levier de ranking : c’est un signal indirect, hors de votre contrôle, dont rien ne prouve le déploiement actuel.
Exemple : Un article très technique sur la gestion des budgets de crawl n’emploie jamais l’expression « économiser du crawl ». Un utilisateur le clippe dans un carnet intitulé « économiser du crawl » avec une annotation. Un autre internaute qui tape cette requête voit alors l’article remonter, avec en snippet le passage clippé.
Thèmes : Positionnement, Intention de recherche, Entités et sémantique, Personnalisation des résultats · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Structured user graph to support querying and predictions
US-11397784-B2 · déposé le 14 août 2019, délivré le 26 juillet 2022
Inventeurs : Pranav Khaitan et Shobha Diwakar
Continuation du brevet US-10482139-B2
Ce brevet décrit un graphe de connaissances propre à chaque utilisateur, construit à partir de ses contenus (mails, documents, services connectés…) puis alimenté en continu. Chaque relation entre deux entités porte un poids, renforcé dès qu’un nouveau contenu du même utilisateur la mentionne. Au moment de la requête, ce graphe sert à produire des résultats personnalisés, y compris en parcourant les entités voisines de celle qui est demandée. C’est intéressant pour comprendre où va la personnalisation (et donc les réponses IA), mais le graphe est alimenté par les données privées de l’utilisateur, pas par votre site. Le levier direct est donc ténu : on ne pilote pas ce graphe, on peut seulement s’y rendre plus « reliable ».
Les implémentations de la présente divulgation sont généralement dirigées vers des graphes structurés spécifiques à un utilisateur qui peuvent être utilisés pour prendre en charge des requêtes soumises par des utilisateurs et/ou des prédictions pertinentes pour des utilisateurs. Plus particulièrement, les implémentations de la présente divulgation sont dirigées vers la fourniture d’un graphe structuré spécifique à un utilisateur qui est spécifique à un utilisateur particulier.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir, c’est que deux utilisateurs peuvent voir des résultats différents pour la même requête, parce que les poids du graphe dépendent de leur historique. Un classement « moyen » unique devient donc une fiction : suivre une position globale ne suffit plus. Le levier indirect est de rendre vos entités (marque, produits, auteurs) claires et cohérentes, avec des relations explicites entre elles (données structurées, maillage, vocabulaire stable), pour que les systèmes puissent les rattacher sans ambiguïté aux entités déjà présentes dans le graphe d’un utilisateur. Autre point : le parcours des nœuds voisins favorise les marques associées à l’entité recherchée, ce qui plaide pour un travail d’écosystème d’entités plutôt que de mots-clés isolés. À nuancer : le brevet ne dit pas que le web public alimente ces poids, et je ne vous vendrai pas un levier qui n’y est pas.
Exemple : Un utilisateur réserve régulièrement des vols via un service de voyage et reçoit des confirmations par mail : la relation « utilisateur – compagnie X » se renforce dans son graphe. Quand il cherche une destination, les résultats peuvent mettre en avant des contenus liés à cette compagnie. Si votre site de voyage a des entités clairement définies et reliées (destinations, compagnies, partenaires), vous êtes plus facile à raccrocher à ce voisinage.
Thèmes : Personnalisation des résultats, Knowledge Graph, Entités et sémantique, Intention de recherche · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Evaluating semantic interpretations of a search query
US-10521479-B2 · déposé le 20 mai 2019, délivré le 31 décembre 2019
Inventeurs : Ashish Venugopal, Jakob D. Uszkoreit, John Blitzer et 1 autre
Continuation du brevet US-10353964-B2
Ce brevet décrit comment Google tranche entre plusieurs sens possibles d’une requête ambiguë, quand un bout de la requête peut désigner plusieurs entités différentes. Pour chaque interprétation, le moteur fabrique une requête « complétée » à partir d’une requête canonique (un gabarit dont la partie entité est incomplète), relance la recherche, puis compare les résultats obtenus à ceux de la requête d’origine. L’interprétation dont les résultats ressemblent le plus à l’original est retenue. Ce n’est pas un signal de ranking au sens strict, mais ça dit beaucoup sur la manière dont l’ambiguïté d’entité se résout : par le comportement de la SERP (la page de résultats), pas par une simple déclaration de votre part. Levier indirect, mais réel.
Cependant, certaines requêtes de recherche peuvent être vagues ou ambiguës et peuvent ne pas être facilement associées à une intention particulière. Par exemple, une requête qui énonce « l’âge de Washington » pourrait se référer, par exemple, au président George Washington, à l’acteur Denzel Washington, à l’État de Washington, ou à Washington D.C. La détermination de l’intention de l’utilisateur associée à de telles requêtes ambiguës peut être difficile.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Si votre requête cible contient un terme qui peut désigner plusieurs entités, le moteur la complète en interne avec les termes d’une requête canonique, puis compare les SERP. Votre page a donc plus de chances d’être rattachée à la bonne interprétation si elle partage ses attributs, ses mots-clés associés et son contexte avec les pages qui dominent déjà cette interprétation. Concrètement, levez l’ambiguïté dans le contenu : nommez l’entité complète dès le titre et l’intro, et gardez un vocabulaire cohérent avec le sens visé. Soyez nuancé toutefois : le brevet décrit un mécanisme de sélection d’intention, pas une garantie de classement. À noter aussi que les métriques de similarité citées (intersection, différence, fréquence de mots-clés, ordre des résultats) sont des options, pas des facteurs prouvés comme décisifs.
Exemple : Vous publiez sur « jaguar » pour le véhicule : si vos pages parlent de la marque automobile sans jamais la nommer en entier et mélangent le vocabulaire animalier, la requête complétée « jaguar voiture » aura des résultats éloignés des vôtres. Un titre et un champ lexical sans équivoque rapprochent votre page de la SERP de la bonne interprétation.
Thèmes : Intention de recherche, Entités et sémantique, Positionnement, Embeddings · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Ranking image search results using machine learning models
US-2020201915-A1 · demande de brevet déposée le 31 janvier 2019
Inventeurs : Manas Ashok Pathak, Sundeep Tirumalareddy, Wenyuan Yin et 4 autres
Ce brevet décrit un classement des résultats Google Images où un seul modèle de machine learning note chaque couple image + page d’atterrissage. Il ne s’appuie plus sur des fonctions de signaux séparées, figées, pondérées de la même façon pour toutes les requêtes. Le modèle avale ensemble la requête, l’image (pixels, embedding) et la page (texte, titre, auteur, date, liens, placement de l’image). Pour faire simple, le poids de chaque signal change selon la requête. Ce n’est pas un levier unique à actionner, mais ça dit clairement ce que Google regarde, et ça confirme que l’image ne se juge jamais seule.
Certains moteurs de recherche d’images conventionnels, c’est-à-dire des moteurs de recherche configurés pour identifier des images sur des pages d’atterrissage, par exemple sur des pages web sur Internet, en réponse à des requêtes de recherche reçues, génèrent des signaux séparés à partir i) des caractéristiques de l’image et ii) des caractéristiques de la page d’atterrissage, puis combinent les signaux séparés selon un schéma de pondération fixe qui est le même pour chaque requête de recherche reçue.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir c’est que l’unité de classement, c’est le couple image + page, pas l’image isolée. Vous optimisez donc les deux ensemble : le contexte de la page (titre, texte autour, alt, ancre des liens, fraîcheur, langue) et la place de l’image dans la page (position, taille affichée, prominence). Une image bien mise en avant, décrite par un alt et un texte voisin cohérents, sur une page pertinente et à jour, donne mécaniquement plus de matière au modèle. Comme les pondérations varient selon la requête, il n’y a pas de recette unique : on teste par type de requête (produit, tuto, inspiration…). À noter : le brevet cite aussi l’embedding de l’image, donc la qualité visuelle et la pertinence du sujet comptent en direct, pas seulement via le texte.
Exemple : Vous avez une page « comment tailler un rosier » avec la photo clé noyée en bas, en miniature, avec un alt vide. Remontez-la près du texte concerné, affichez-la en taille correcte, donnez-lui un alt descriptif et une légende cohérente avec le titre de la page : vous avez amélioré, d’un coup, les signaux image ET page que le modèle lit ensemble.
Thèmes : Positionnement, Images et vidéos, Embeddings, Fraîcheur du contenu · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Canonicalizing search queries to natural language questions
US-2020167379-A1 · demande de brevet déposée le 18 janvier 2019
Inventeurs : Manaal Faruqui et Dipanjan Das
Ce brevet décrit un système en deux temps : un classifieur juge si la requête est « bien formée » (grammaticale, sans faute, formulée comme une question explicite). Si ce n’est pas le cas, un modèle de réécriture (séquence à séquence, un réseau de neurones qui transforme une suite de mots en une autre) produit une variante en question naturelle, et c’est elle qui est cherchée. Le même procédé sert aussi à reformuler les « recherches associées » affichées à l’utilisateur. Pas de signal de ranking direct, donc pas de panique. Mais l’impact indirect est réel : la requête qui est matchée contre vos contenus n’est pas toujours celle que l’internaute a tapée.
Les techniques décrites ici sont dirigées vers le traitement d’une requête de recherche en langage naturel afin de déterminer si la requête de recherche en langage naturel est bien formée, et sinon, d’utiliser un modèle de canonisation entraîné pour générer une variante bien formée de la requête de recherche en langage naturel.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Les requêtes fragmentaires (« prix assurance auto jeune conducteur ») peuvent être réécrites en questions complètes avant la recherche. Ce qu’il faut retenir : vos contenus gagnent à répondre aussi à la forme question de vos requêtes cibles, avec une formulation explicite en titre ou en intertitre suivie d’une réponse directe. Côté recherches associées, des variantes en question bien formées peuvent être mises en avant, ce qui en fait un terrain de veille pour repérer comment Google « grammaticalise » vos sujets. À noter : le brevet ne dit pas que les questions rankent mieux, il dit que la requête réellement exécutée peut changer. Ça reste un levier de pertinence, pas un hack.
Exemple : Sur une page qui vise « changer plaquettes de frein », je garde mon titre naturel, puis j’ajoute un intertitre « Comment changer les plaquettes de frein de sa voiture ? » avec la réponse en deux ou trois phrases juste en dessous. Si la requête fragmentaire est réécrite en question, ma page colle déjà à la forme réellement recherchée.
Thèmes : Intention de recherche, Recherche conversationnelle, Questions-réponses, Embeddings · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Brevets déposés en 2018
Selecting answer spans from electronic documents using neural networks
US-2020265327-A1 · demande de brevet déposée le 29 octobre 2018
Inventeurs : Thomas Mieczyslaw Kwiatkowski, Ankur P. Parikh et Swabha Swayamdipta
Ce brevet décrit comment Google peut extraire d’un document la portion de texte qui répond à une question, pour la renvoyer en extrait ou en réponse vocale. Le système fonctionne en trois étages de petits réseaux de neurones. Le premier regarde le candidat et son contexte immédiat, le deuxième le confronte à la question au niveau du segment (phrase, paragraphe), le troisième regroupe les occurrences identiques et leur donne un score final. Le brevet cite explicitement les pages web et le couplage avec un moteur de recherche, qui identifie le document puis récupère l’extrait. Pour vous, c’est un levier indirect mais réel : il éclaire ce qui fait qu’un passage est choisi comme réponse. À noter que c’est un brevet d’architecture, pas un guide de rédaction, donc on lit entre les lignes, avec prudence.
Cette spécification décrit un système mis en œuvre sous forme de programmes informatiques sur un ou plusieurs ordinateurs dans un ou plusieurs emplacements qui sélectionne un segment de texte à partir d’un document électronique d’entrée qui répond à une question d’entrée qui comprend une pluralité de jetons de question.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qui compte, c’est la pertinence locale : la réponse est jugée avec son voisinage (le texte à gauche et à droite) et avec le segment qui la contient, confrontés aux mots de la question. Concrètement, il faut écrire la réponse dans un segment court et cohérent, avec les termes de la question à proximité immédiate. Autre point : les mentions répétées d’une même formulation (ou d’entités équivalentes) sont agrégées, donc la cohérence d’un document qui répète la même réponse de façon constante renforce probablement le score de ce candidat. À l’inverse, une réponse noyée dans un paragraphe fourre-tout ou formulée de dix manières divergentes se dilue. Impact direct sur la sélection d’extraits, et indirect sur la visibilité en réponses vocales et en réponses générées. Je reste mesuré : le brevet ne dit pas que Google fonctionne exactement ainsi aujourd’hui, mais la logique est transposable.
Exemple : Sur une page « Combien de temps dure un audit SEO ? », placez la réponse dans le paragraphe juste sous le titre, en reprenant les mots de la question (« la durée d’un audit SEO est de… »), puis redites la même valeur avec la même formulation plus bas plutôt que de la reformuler de trois façons différentes.
Thèmes : Questions-réponses, Embeddings, RAG, Images et vidéos · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Contextual estimation of link information gain
US-11354342-B2 · déposé le 18 octobre 2018, délivré le 7 juin 2022
Inventeurs : Victor Carbune et Pedro Gonnet Anders
Ce brevet décrit un score de « gain d’information » : Google estime ce qu’un document apporte de neuf par rapport à ce que l’utilisateur a déjà vu sur le même sujet. La pertinence seule ne suffit plus, car un contenu parfaitement sur le sujet peut être rétrogradé s’il répète ce qu’on a déjà lu ailleurs. Le calcul passe par un modèle de machine learning qui compare des représentations sémantiques (embeddings, vecteurs de traits), donc pas juste du recoupement de mots. Un contenu qui redit les autres, même très bien, devient un contenu remplaçable. À noter : un brevet n’est pas une preuve de déploiement, mais le principe est cohérent avec ce qu’on observe sur les SERP qui se ressemblent toutes, et il vaut un vrai changement de méthode éditoriale.
Cependant, lorsqu’un ensemble de documents partageant un sujet est identifié, nombre des documents peuvent contenir des informations similaires. Par exemple, un utilisateur peut soumettre une recherche liée à la résolution d’un problème informatique (par exemple, un bug, un logiciel malveillant, une configuration, etc.) et peut ensuite recevoir plusieurs documents qui incluent une liste similaire de solutions, d’étapes correctives, de ressources, etc.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le brief ne doit plus s’arrêter à « couvrir les sous-thèmes que couvrent déjà les 10 premiers résultats ». Il faut décider, avant la rédaction, ce que votre page apporte que les autres n’ont pas : une donnée de première main, un angle, un cas vécu, une nuance, une étape que personne ne détaille. Ce différentiel doit être identifiable sémantiquement, donc porté par du fond et pas par une reformulation. Impact direct : la page a une chance de remonter quand l’utilisateur a déjà consulté d’autres résultats. Impact indirect : dans un usage assistant ou réponse générée, le système tend à éviter de répéter une info déjà énoncée, donc seul le complément a une chance d’être repris. Dernier point, à doser : le score dépend du contexte de l’utilisateur (ce qu’il a déjà vu), donc on ne l’optimise pas à l’aveugle, on augmente simplement la probabilité d’être celui qui apporte quelque chose de neuf.
Exemple : Sur une requête « comment choisir un CRM », si les dix premiers résultats listent les mêmes critères (prix, intégrations, ergonomie), votre guide ajoute un retour d’expérience concret de migration avec les pièges rencontrés. Pour un utilisateur qui a déjà lu deux comparatifs classiques, c’est votre page qui apporte de l’information nouvelle, pas la onzième liste de critères.
Thèmes : Intention de recherche, Personnalisation des résultats, Positionnement, Embeddings · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Attention-based sequence transduction neural networks
US-10452978-B2 · déposé le 28 juin 2018, délivré le 22 octobre 2019
Inventeurs : Noam M. Shazeer, Aidan Nicholas Gomez, Lukasz Mieczyslaw Kaiser et 5 autres
Prolongé par la continuation US-10719764-B2 (21 juillet 2020)
Voilà le brevet du Transformer, l’architecture « Attention is all you need ». Il protège un réseau de neurones qui traite une séquence (une phrase, par exemple) en faisant porter l’attention de chaque mot sur tous les autres. Plus besoin de lire de gauche à droite avec des couches récurrentes. C’est le socle de la compréhension de texte moderne, donc de ce que fabriquent les moteurs et les LLM. Mais ce n’est pas un levier SEO direct. Le brevet ne dit rien de ranking, de crawl ou de sélection de sources. Il vaut surtout pour comprendre pourquoi le contexte, la désambiguïsation et la cohérence d’un texte pèsent autant aujourd’hui (impact indirect, donc, mais réel).
En particulier, le système génère la séquence de sortie en utilisant un réseau neuronal encodeur et un réseau neuronal décodeur qui sont tous deux fondés sur l’attention.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Aucun réglage à activer ici. Ce qu’il faut retenir : chaque mot est interprété par rapport à l’ensemble des autres mots de la séquence, pas isolément. Rédigez donc des passages où le sens se tient sans ambiguïté : sujet nommé explicitement, entités clairement désignées, termes cohérents d’un bout à l’autre. Le contexte environnant influence la lecture de chaque mot, alors la pertinence d’un bloc dépend de la qualité de tout ce qui l’entoure. À noter que ce brevet décrit une architecture générale, pas la manière dont Google s’en sert pour classer ou citer des pages : toute déduction plus fine serait de la spéculation.
Exemple : Une page sur « Jaguar » qui mélange l’animal, la voiture et la marque sans jamais les distinguer fait peser une ambiguïté sur chaque occurrence. Une page qui pose tôt son sujet (« la voiture Jaguar ») et garde un vocabulaire cohérent donne au modèle un contexte net pour interpréter chaque phrase.
Thèmes : IA générative, Embeddings, Recherche conversationnelle, RAG · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Answering entity-seeking queries
US-2019370326-A1 · demande de brevet déposée le 29 mai 2018
Inventeurs : Mugurel Ionut Andreica, Tatsiana Sakhar, Behshad Behzadi et 2 autres
Ce brevet décrit comment Google comprend qu’une requête cherche une entité (un restaurant chinois, un film, un hôtel) plutôt qu’une réponse générique. Pour cela, il découpe la requête en arbre de dépendances (un schéma qui montre quel mot modifie quel autre) et lit le type d’entité dans le mot racine de l’arbre. Une fois le type déterminé, la recherche est restreinte à cette catégorie, puis filtrée par la pertinence de l’entité vis-à-vis des termes de la requête. Aucun signal de ranking ici, soyons clairs : c’est du levier indirect, mais réel. Il touche à la manière dont votre page est rattachée à un type d’entité, et donc à la possibilité d’être retenue comme réponse. Quand la requête est ambiguë, le système peut aussi demander des précisions à l’utilisateur, ce qui change la donne pour les requêtes descriptives.
Un système qui traite des requêtes d’utilisateurs peut recevoir certaines requêtes qui recherchent une ou plusieurs entités et peut recevoir certaines requêtes qui ne recherchent pas une ou plusieurs entités. Par exemple, un système peut recevoir une requête qui recherche une entité, la requête étant « Quel est l’hôtel qui ressemble à une voile », peut identifier une entité qui est le Burj Al Arab Jumeirah, puis fournir une réponse de « Le Burj Al Arab Jumeirah ».
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Rendez le type d’entité de vos pages sans équivoque : un terme de catégorie explicite dans le titre, le H1 et l’introduction, soutenu par des données structurées cohérentes avec ce type. Travaillez aussi les formulations descriptives que les gens utilisent pour désigner une entité sans la nommer (« l’hôtel qui ressemble à une voile »). Le brevet retient d’abord le type, puis la pertinence : une page au type flou risque d’être écartée avant même d’être évaluée. Impact direct sur la clarté de votre ciblage, impact indirect sur votre présence dans les réponses et les commandes vocales ou assistées. À noter que ce n’est pas une garantie : le brevet décrit un mécanisme, pas un facteur de classement mesuré.
Exemple : Une fiche qui s’intitule « Notre cuisine du monde » reste floue sur son type. Si vous la reformulez en « Restaurant chinois à Lyon : carte et horaires », avec le balisage de restaurant correspondant, elle colle au type que le système déduit d’une requête comme « restaurant chinois ouvert tard ».
Thèmes : Intention de recherche, Entités et sémantique, Knowledge Graph, Questions-réponses · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Machine learning to identify opinions in documents
US-10832001-B2 · déposé le 26 avril 2018, délivré le 10 novembre 2020
Inventeurs : Boris Dadachev et Kishore Papineni
Ce brevet décrit un classifieur qui repère, phrase par phrase ou paragraphe par paragraphe, ce qui relève de l’opinion et ce qui n’en relève pas, surtout dans les articles d’actualité. Cette étiquette sert ensuite à choisir des extraits représentatifs, à classer des passages et à regrouper des documents par point de vue dans un affichage informatif. Ce n’est pas un signal de ranking classique, et le texte ne dit pas que ça pèse sur le classement d’une page web. Le levier est indirect mais réel : la façon dont vos passages sont écrits peut décider de ce qui est remonté comme extrait, surtout sur les contenus éditoriaux. À noter que le brevet cible l’actualité, donc inutile de le généraliser à tout type de site.
Les systèmes de production qui sélectionnent et fournissent des documents (p. ex., des articles d’actualité) aux utilisateurs s’appuient presque exclusivement sur des signaux de contenu superficiels (p. ex., des termes et des entités saillants, etc.) et/ou des métadonnées (p. ex., l’importance d’un éditeur, le moment où le contenu a été publié (p. ex., par rapport à d’autres articles), des références (p. ex., des liens) entre des articles, etc.). Ainsi, de tels systèmes de production ne s’appuient généralement pas sur une compréhension nuancée du contenu réel des documents eux-mêmes.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Un passage d’opinion doit pouvoir se lire seul : le brevet parle d’un score d’importance qui mesure la capacité d’un passage à représenter le document sans contexte additionnel. Concrètement, rédigez vos prises de position dans des phrases ou paragraphes autonomes, avec l’entité concernée nommée et la position énoncée sans ambiguïté. Séparez aussi nettement le factuel de l’opinion, et distinguez l’avis de l’auteur de l’opinion rapportée (le modèle multi-classe fait cette différence). Le déséquilibre inverse (opinion noyée dans du reportage neutre ou dans des citations) vous rend moins éligible à ces extraits. Et si plusieurs sources couvrent le même sujet, le regroupement par point de vue favorise la diversité : un angle distinct est donc stratégique, répéter la même position que tout le monde ne l’est pas.
Exemple : Sur un article de test comparatif, plutôt que de diluer votre verdict dans trois paragraphes de description, placez une phrase claire du type « Selon moi, ce modèle ne vaut pas son prix pour un usage pro, et voici pourquoi », avec le produit nommé. Ce passage peut alors être repéré comme opinion et se suffire à lui-même comme extrait.
Thèmes : Questions-réponses, Embeddings, Qualité du contenu, Actualités · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Context scoring adjustments for answer passages
US-11409748-B1 · déposé le 16 mars 2018, délivré le 9 août 2022
Inventeurs : Nitin Gupta, Srinivasan Venkatachary, Lingkun Chu et 1 autre
Continuation du brevet US-9959315-B1
Ce brevet décrit comment Google départage des passages candidats pour répondre à une question (le type d’extrait mis en avant en position zéro ou repris dans une réponse générée). Chaque passage reçoit un score de base, puis un ajustement lié à son contexte : sa position dans la hiérarchie des titres (H1, H2, H3…), la part du bloc source qu’il occupe, et son format en liste quand la question s’y prête. Cette version « continuation » ajoute des seuils précis et des facteurs de boost. Ce qu’il faut retenir : la structure de votre page n’est pas qu’une question de confort de lecture, elle entre directement dans le calcul qui décide quel passage est cité. C’est rare d’avoir un levier aussi lisible, donc stratégique. À nuancer : on parle d’un mécanisme décrit dans un brevet, sans aucun chiffre de pondération, et rien ne dit comment il pèse face aux autres signaux.
Certaines requêtes de question sont mieux servies par des réponses explicatives, qui sont également appelées « longues réponses » ou « passages de réponse ». Par exemple, pour la requête de question [why is the sky blue], une réponse expliquant la diffusion de Rayleigh est utile.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Trois leviers activables. 1) Soignez la hiérarchie des titres : le passage est évalué selon le chemin de titres qui le mène de la racine à sa section, et les sections plus profondes peuvent être pondérées plus fortement. Des titres descriptifs et cohérents avec la question sont donc une vraie matière à scoring (impact direct), pas du décor. 2) Visez des passages qui occupent l’essentiel de leur bloc : le ratio de couverture (caractères du passage divisés par caractères du bloc source) déclenche un boost plus fort au-delà d’un seuil. Mieux vaut une section qui répond de bout en bout qu’une réponse noyée dans un long bloc fourre-tout. 3) Pour les requêtes qui appellent des étapes (« comment faire… »), une liste réellement formatée (numérotée, à puces) est favorisée, avec un boost supplémentaire si elle couvre largement son bloc. Effet indirect : des sections propres, autonomes et bien titrées sont aussi plus faciles à extraire pour les moteurs de réponse génératifs. Gardez l’esprit critique : ne découpez pas tout en listes à tout prix, seulement quand l’intention est procédurale.
Exemple : Un tutoriel « Comment configurer X » où une section H2 « Les étapes de configuration » contient presque uniquement une liste numérotée, sans paragraphes parasites autour, coche le ratio de couverture élevé, le format liste et un titre aligné avec la question. À l’inverse, la même liste noyée au milieu d’un long bloc généraliste, sous un titre vague, part avec un net déséquilibre face à un concurrent mieux structuré.
Thèmes : Questions-réponses, Featured snippet, Intention de recherche, Balisage on-page · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Scoring candidate answer passages
US-10783156-B1 · déposé le 22 février 2018, délivré le 22 septembre 2020
Inventeurs : Steven D. Baker, Srinivasan Venkatachary, Robert Andrew Brennan et 5 autres
Ce brevet décrit comment Google choisit le passage qui s’affiche dans la boîte de réponse (l’answer box, ou « long answer ») quand la requête est une question. Pour faire simple : il extrait des passages candidats des résultats les mieux classés, puis leur attribue un score de réponse. Ce score mélange la proximité avec la requête et des signaux de qualité du passage et de sa source. Vous me direz que c’est du mécanique de moteur. Oui, mais c’est une mécanique qui débouche sur des choix de rédaction très concrets. On n’optimise plus seulement une page, on optimise un passage.
Les utilisateurs des systèmes de recherche recherchent souvent une réponse à une question spécifique, plutôt qu’une liste de ressources. Par exemple, les utilisateurs peuvent vouloir savoir quel temps il fait dans un lieu particulier, un cours actuel pour une action, la capitale d’un État, etc.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Mécaniquement, trois leviers. 1) La pertinence : le score dépend des termes de la requête présents dans le passage, mais aussi des termes typiques des meilleurs résultats (pondérés par leur fréquence dans ces résultats et par l’IDF, c’est-à-dire la rareté du terme dans le corpus). Il faut donc couvrir le vocabulaire du top, pas juste répéter la requête. 2) L’entité attendue : si la question appelle un type d’entité (une date, une personne, un lieu…) et que le passage n’en contient aucune du bon type, son score baisse. Répondez avec la bonne entité, nommée explicitement. 3) La cohérence : le brevet pénalise les passages à cheval sur deux sections et ceux qui commencent par un terme de transition du discours (« Par ailleurs », « Cependant »…). Votre réponse doit tenir seule, dans un bloc local, dès la première phrase. À noter que le score hérite aussi du classement de la page source, de la réputation de la ressource et de la qualité du site. Sans base SEO solide, la meilleure réponse ne suffit pas. Enfin, un passage peut être une phrase ou une cellule de tableau, avec des règles de sélection différentes. Le contenu structuré (tableaux) est donc un vrai candidat.
Exemple : Sur une page « Combien de temps faut-il pour indexer un site ? », placez juste sous le H2 une réponse autonome de deux phrases, qui commence directement par le sujet et non par « Par ailleurs », avec l’entité attendue (une durée) clairement énoncée. Reprenez ensuite le vocabulaire récurrent des pages du top 10, et si la réponse est factuelle, ajoutez un petit tableau propre en complément.
Thèmes : Questions-réponses, Featured snippet, Entités et sémantique, Positionnement · Intérêt SEO : 9/10 · Lire le brevet sur Google Patents
Brevets déposés en 2017
Information extraction from question and answer websites
US-10452694-B2 · déposé le 20 décembre 2017, délivré le 22 octobre 2019
Inventeurs : Wei Lwun Lu, Denis Savenkov, Amarnag Subramanya et 3 autres
Ce brevet décrit comment Google peut alimenter son graphe d’entités (les nœuds sont les entités, les arêtes les relations entre elles) à partir de pages de questions-réponses : forums, FAQ, sites de Q&R. Le système isole la question et la réponse du bruit de la page (menus, pubs, en-têtes), repère l’entité de la question, celle de la réponse, puis déduit le type de relation (conjoint, par exemple) à partir de la formulation. Pour faire simple, une relation n’entre dans le modèle que si elle revient le plus souvent parmi les candidates. Ce n’est pas un signal de ranking : c’est du côté de la compréhension des entités et de la construction des faits. Le levier est donc indirect, mais il est réel, surtout pour le GEO, où la clarté des faits compte beaucoup.
Une page Web d’un site Web de questions-réponses peut être utilisée comme ressource pour déterminer des relations entre des entités qui sont identifiées par la question et la réponse présentées sur la page Web. Par exemple, un système informatique sélectionne une page Web d’un site Web de questions-réponses qui comprend la question, « À qui Barack Obama est-il marié ? » ainsi que la réponse, « Michelle Obama. »
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Vos pages Q&R et FAQ sont potentiellement une matière première pour extraire des faits, à condition d’être lisibles par une machine. Formulez la question de façon explicite, avec l’entité nommée en toutes lettres et une tournure qui porte clairement la relation (« Qui est X marié à ? », « Où se trouve le siège de X ? »). Donnez ensuite une réponse courte, qui désigne une seule entité, avant de développer. Le brevet cite des marqueurs de question (point d’interrogation, mots interrogatifs) et des marqueurs de réponse (« La réponse est… »). Séparez aussi nettement question et réponse dans la mise en page, pour que l’extraction ne les confonde pas avec le reste de la page. À noter que le score dépend de la fréquence : une relation répétée de façon cohérente sur plusieurs sources a plus de chances de s’imposer. Des réponses contradictoires d’une page à l’autre, y compris sur votre propre site, diluent le signal. Ce qu’il faut retenir, c’est que la cohérence des faits sur l’ensemble de vos contenus est stratégique, pas cosmétique. Le brevet ne dit pas que cela améliore un classement : le gain visé est une meilleure compréhension, donc une meilleure chance d’être repris comme fait.
Exemple : Sur la FAQ d’un éditeur de logiciel, écrire « Qui a fondé [Marque] ? » suivi de « [Prénom Nom]. » en tête de réponse, puis le détail, donne un couple entité-relation-entité très net. Une réponse qui commence par trois lignes d’historique sans nommer personne, ou une autre page qui cite un autre fondateur, brouille ce que le système peut en retirer.
Thèmes : Questions-réponses, Entités et sémantique, Knowledge Graph, Données structurées · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Automatic discovery of new entities using graph reconciliation
US-10331706-B1 · déposé le 4 octobre 2017, délivré le 25 juin 2019
Inventeurs : Oksana Yakhnenko et Norases Vesdapunt
Ce brevet décrit comment Google peut découvrir de nouvelles entités à partir du web, puis les proposer pour insertion dans son graphe de connaissances (le Knowledge Graph, sa base d’entités et de relations). Le principe : on extrait des faits de plein de documents, on regroupe ceux qui parlent du même nom et du même type, puis on ne valide l’entité que si plusieurs faits « déterminants » se recoupent entre sources distinctes. Pour faire simple, une entité n’existe pas parce qu’une page le dit, mais parce que plusieurs sources indépendantes disent la même chose. Ce n’est pas un signal de ranking, je ne vais pas vous le vendre comme tel. Mais ça éclaire une logique de corroboration qui pèse directement sur la façon d’exister dans le graphe, donc indirectement sur la visibilité en recherche et dans les réponses générées.
Cependant, le graphe peut manquer d’informations concernant certaines entités. Ces entités peuvent être décrites dans des sources de documents, telles que des pages Web, mais l’ajout manuel des informations pour les entités est lent et ne passe pas à l’échelle. De telles entités manquantes et leurs relations avec d’autres entités réduisent l’utilité de l’interrogation du graphe de données.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Une entité (marque, personne, produit, outil) a de meilleures chances d’être reconnue si des faits identifiants et cohérents la concernant existent sur plusieurs domaines distincts. Le résumé évoque un exemple de trois faits déterminants, et des seuils de fiabilité liés au nombre de domaines et de documents : un bucket (groupe de documents qui partagent la même valeur pour un fait) avec une seule source ou un seul domaine peut être écarté. À noter aussi : un fait dont l’objet existe déjà dans le graphe permet d’ancrer la nouvelle entité. Les faits contradictoires peuvent être éliminés. Il faut donc homogénéiser le nom, le type et les attributs clés partout où vous apparaissez, et les faire relayer par des sources tierces plutôt que seulement par votre site. L’impact est direct sur la reconnaissance de l’entité, et indirect sur ce que les moteurs et les IA peuvent affirmer à votre sujet.
Exemple : Vous lancez un outil SaaS : même nom, même catégorie, même éditeur, même fondateur et même date de création sur votre site, votre page LinkedIn, un annuaire sectoriel et un article de presse. Ces faits se recoupent entre domaines différents et lient l’outil à des entités déjà connues (l’éditeur, la catégorie). Si votre fiche annonce une version sur le site et une autre dans l’annuaire, vous créez du conflit, et vous affaiblissez la corroboration.
Thèmes : Entités et sémantique, Knowledge Graph, Indexation, Questions-réponses · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Brevets déposés en 2016
Search engine
US-10643183-B2 · déposé le 18 octobre 2016, délivré le 5 mai 2020
Inventeurs : Ye Tian, Ghaderi Seyed Reza Mir, Xuejun Tao et 3 autres
Ce brevet décrit un moteur de recherche d’emplois : on entraîne un modèle sur des offres étiquetées (intitulé + métier), on construit des vecteurs par métier, puis on classe la requête dans le métier le plus probable pour renvoyer les offres de cette catégorie. Pour faire simple, une recherche « ninja » ou « guru » peut tomber sur des offres de développeur, même si le mot n’apparaît pas dans le titre. C’est malin, mais c’est un cas verticalisé (l’emploi) : rien ne prouve que la recherche web classique fonctionne ainsi. Ce qu’il faut retenir, c’est la logique de fond : rattacher une requête à une classe (un métier, une intention) plutôt qu’à des mots littéraux. Utile à comprendre, levier direct assez ténu hors des sites d’emploi.
Dans certaines implémentations, un modèle d’identification d’emploi est fourni qui améliore la recherche d’emploi en améliorant la qualité des résultats de recherche fournis en réponse à une requête de recherche d’emploi. Les résultats de recherche sont améliorés parce que le modèle d’identification d’emploi est capable d’identifier des offres d’emploi pertinentes qui passeraient autrement inaperçues par des algorithmes conventionnels en raison des limitations inhérentes à la recherche basée sur des mots-clés.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Si vous travaillez sur un site d’offres d’emploi, un job board ou des pages métiers, ne misez pas tout sur l’intitulé exact : clarifiez le métier sous-jacent (catégorie, famille de métiers, vocabulaire associé, intitulés synonymes) pour que l’offre soit rattachée à la bonne classe. Pour le reste, ça conforte une idée de fond : les moteurs raisonnent de plus en plus en catégories et en intentions, donc la pertinence thématique de la page compte plus que la répétition d’une expression. À noter : c’est une inférence, le brevet ne parle que de recherche d’emploi, donc pas de conclusion hâtive pour le web généraliste.
Exemple : Une offre intitulée « Ninja du code » gagne à mentionner clairement « développeur logiciel » dans le corps, la catégorie et les données structurées, et à être rangée dans la bonne rubrique métier. Elle a ainsi plus de chances de remonter pour des requêtes qui ne contiennent pas le mot « ninja ».
Thèmes : Intention de recherche, Embeddings, E-commerce, SERP · Intérêt SEO : 4/10 · Lire le brevet sur Google Patents
Automatic query pattern generation
US-10467256-B2 · déposé le 3 août 2016, délivré le 5 novembre 2019
Inventeurs : Tomer Shmiel, Dvir Keysar et Vered Cohen
Ce brevet décrit comment Google part de paires requête-document (quelle requête a mené vers quel document) pour repérer des « patterns de requêtes », c’est-à-dire des formes génériques et répétables de requêtes. Il découpe ces patterns en sous-phrases, retrouve d’autres patterns qui partagent ces sous-phrases, leur attribue un classifieur (catégorie de sujet + niveau de spécificité), puis assemble le tout en graphe de similarité. Ce n’est pas un signal de ranking et le brevet ne dit pas comment il pèse dans le classement. Ce qu’il nous apprend, c’est que l’intention est lue aussi bien depuis les documents choisis que depuis le texte de la requête. À noter que le levier est indirect, mais il est réel pour la façon de penser vos clusters de contenu.
Les moteurs de recherche Internet peuvent renvoyer des résultats de recherche en réponse à une requête de recherche soumise par un utilisateur. Certains résultats de recherche peuvent être jugés pertinents par rapport à la requête de recherche de l’utilisateur et d’autres résultats de recherche peuvent être jugés tangents, ou marginalement pertinents. Étant donné que les utilisateurs recherchent généralement des informations utiles, fournir les résultats de recherche les plus pertinents selon les besoins de l’utilisateur peut faire gagner du temps à l’utilisateur et peut supprimer la charge d’avoir à effectuer plusieurs requêtes de recherche pour trouver les informations souhaitées.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir c’est que deux requêtes aux mots différents peuvent atterrir dans le même groupe si elles partagent des sous-phrases et mènent vers des documents proches. Concrètement, votre page est rattachée à une intention (sujet + niveau de spécificité) via les requêtes pour lesquelles elle est consultée, pas seulement via ses mots-clés. Il faut donc cibler une intention précise par page plutôt qu’une liste de mots-clés, soigner les sous-phrases récurrentes de votre thématique (le pattern, pas la variante isolée) et garder un niveau de spécificité cohérent. Une page qui mélange plusieurs niveaux, du généraliste au très pointu, brouille son rattachement, et le brevet évoque justement un élagage des patterns hors intention. Vu l’abstract, tout ceci reste de l’inférence : à prendre comme grille de lecture, pas comme règle prouvée.
Exemple : Sur un site de location de vélos, les requêtes « louer vélo électrique Lyon » et « location VAE week-end Lyon » partagent des sous-phrases et mènent vers les mêmes pages. Plutôt que deux pages quasi jumelles, une page claire sur l’intention « location de vélo électrique, local », et une autre, distincte, sur un niveau plus spécifique (itinéraires, tarifs), évitent de mélanger les intentions.
Thèmes : Intention de recherche, Recherche de mots-clés, Embeddings, Analytics · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Distantly supervised wrapper induction for semi-structured documents
US-10977573-B1 · déposé le 15 avril 2016, délivré le 13 avril 2021
Inventeurs : Jeffrey Dalton, Karthik Raman, Evgeniy Gabrilovich et 2 autres
Ce brevet décrit comment Google peut enrichir son knowledge base (graphe de faits du type <sujet, prédicat, objet>) en apprenant à extraire des données de pages qui partagent un même gabarit, sans annotation humaine. Le principe : on prend des pages dont l’entité principale est déjà connue, on projette les faits connus sur la structure de la page, et on en déduit un extracteur (un « wrapper ») applicable aux autres pages du même site. C’est de l’extraction pure, pas du ranking : aucun signal de classement n’est évoqué. L’intérêt est donc indirect, mais réel pour qui travaille les entités, les pages type fiche ou profil et la cohérence de template. Levier ténu, mais pas inutile à comprendre.
L’ajout d’entités et de relations à une base de connaissances a généralement été un processus manuel, rendant la création de grandes bases de connaissances difficile et lente. Ainsi, bien que la base de connaissances puisse inclure des informations sur des millions d’entités, la base de connaissances peut néanmoins rester incomplète.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Les pages qui gagnent à être « lues » par ce type de système sont celles dont la structure est stable et régulière : même gabarit, entité principale clairement positionnée (titre, URL), attributs toujours présentés au même endroit et sous le même libellé. Le brevet filtre explicitement les pages bruitées ou qui contiennent trop peu de prédicats connus, et traite les incohérences comme des exemples négatifs. Un template propre et une information factuelle cohérente d’une page à l’autre augmentent donc la probabilité que vos faits soient extraits correctement (impact direct), et reprennent ensuite dans le graphe de connaissances, donc dans les réponses et les AI Overviews (impact indirect). À noter que le brevet ne garantit rien sur l’usage final : il dit seulement qu’un fait dépassant un seuil de probabilité peut être ajouté à la base.
Exemple : Vous gérez un annuaire de 3 000 fiches de restaurants : si le nom est dans le title et l’URL, que l’adresse, le téléphone et le type de cuisine sont toujours dans les mêmes blocs avec les mêmes libellés, l’extracteur apprend le motif et capte vos faits sur toutes les fiches. Si chaque fiche a sa propre mise en page et des libellés différents, vous brouillez le signal, et vos pages risquent d’être écartées comme bruitées.
Thèmes : Knowledge Graph, Entités et sémantique, Embeddings, Questions-réponses · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Anchor tag indexing in a web crawler system
US-10210256-B2 · déposé le 1er avril 2016, délivré le 19 février 2019
Inventeurs : Huican Zhu, Jeffrey Dean, Sanjay Ghemawat et 2 autres
Continuation du brevet US-9305091-B2
Ce brevet décrit comment Google rattache le texte placé autour d’un lien (l’ancre, mais aussi le texte voisin, dans une certaine distance) à la page cible, et pas seulement à la page source. Résultat : un terme peut être associé à une URL que Google n’a même pas encore crawlée, ou à une page qui n’a presque pas de texte (image, audio). Ce n’est pas nouveau comme idée, mais c’est un rappel précieux : ce que les autres disent de vous pèse dans l’index, en plus de ce que vous dites de vous. Le levier est indirect mais réel, et il touche le netlinking comme le maillage interne. À noter que le brevet cite aussi le PageRank, calculé comme une somme de contributions des pages qui pointent vers la cible : l’autorité et le vocabulaire voyagent par le même tuyau.
Les moteurs de recherche fournissent une source puissante de documents indexés provenant d’Internet qui peuvent être rapidement parcourus. Cependant, à mesure que le nombre de documents sur Internet croît, les périodes de temps entre le moment où une page est explorée par un robot et le moment où elle peut être indexée et mise à disposition d’un moteur de recherche deviennent toujours plus longues.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le contexte autour de vos liens entrants et internes est une donnée d’indexation à part entière. Soignez le texte d’ancre ET la phrase qui l’entoure, car le terme présent dans cette zone peut être associé à la page cible. Variez et gardez des ancres descriptives pour que le vocabulaire attaché à chaque URL colle à son sujet. Pour les pages pauvres en texte (visuels, audio, pages récentes pas encore crawlées), les liens qui les décrivent bien servent de description de substitution. Ce qu’il faut retenir : une ancre vague (« cliquez ici ») est une occasion perdue, et un maillage mal pensé crée un déséquilibre entre ce que vos pages disent d’elles-mêmes et ce que le reste du site en dit.
Exemple : Vous publiez une page de ressources illustrée par une infographie, avec peu de texte. Vos articles qui la citent écrivent « infographie comparatif des balises hreflang » dans l’ancre et la phrase autour : ces termes peuvent être associés à la page cible, même si son propre contenu est maigre.
Thèmes : Crawl, Indexation, Maillage interne, Positionnement · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Ranking documents based on user behavior and/or feature data
US-10152520-B1 · déposé le 30 mars 2016, délivré le 11 décembre 2018
Inventeurs : Jeffrey A. Dean, Corin Anderson et Alexis Battle
Continuation du brevet US-9305099-B1
Ce brevet est une continuation de la famille « reasonable surfer » : Google estime la probabilité qu’un lien soit cliqué selon ses caractéristiques, puis s’en sert pour pondérer la valeur transmise par ce lien. Les revendications sont précises : le contexte avant et après le lien, les mots de l’ancre et leur nombre, plus des attributs de la page source et de la page cible. Ce n’est pas un détail d’ingénieur. Pour un SEO, tous les liens ne se valent pas, et la valeur d’un lien dépend de sa probabilité d’être cliqué. Je reste prudent : le brevet décrit un cadre et ne dit pas si, ni à quel degré, il tourne aujourd’hui en production, ni quels poids sont appliqués.
Le World Wide Web (« web ») contient une vaste quantité d’informations. Localiser une portion souhaitée des informations, cependant, peut être difficile.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ça justifie d’évaluer un lien (en netlinking comme en maillage interne) sur sa capacité à être réellement cliqué, pas sur sa seule existence. Concrètement, regardez la cohérence de l’ancre avec ce qui l’entoure, sa longueur, le texte autour, la place du lien dans la page source, la pertinence de la page source par rapport à la cible. Le brevet évoque aussi le cumul : plusieurs liens vers la même page s’additionnent, chacun pondéré selon ses caractéristiques. Un lien discret, noyé dans un footer ou posé sans contexte, a donc probablement un poids plus faible qu’un lien éditorial visible. À noter que le brevet parle de comportements agrégés sur des classes de liens, pas de votre site en particulier : on ne peut pas le « piloter » finement, mais on peut éviter les liens à faible probabilité de clic.
Exemple : Vous avez le choix entre un lien en ancre « cliquez ici » dans un bloc de liens en bas de page, et un lien contextuel de quelques mots descriptifs au milieu d’un paragraphe qui traite du sujet de la page cible. Selon la logique du brevet, le second a plus de chances d’être cliqué, donc d’être mieux pondéré. C’est lui qu’il faut viser, que ce soit en maillage interne ou en demande de lien externe.
Thèmes : Positionnement, Backlinks, Expérience utilisateur, Intention de recherche · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Brevets déposés en 2015
Producing a ranking for pages using distances in a web-link graph
US-9953049-B1 · déposé le 19 octobre 2015, délivré le 24 avril 2018
Inventeur : Nissan Hajaj
Continuation du brevet US-9165040-B1
Ce brevet décrit un PageRank « réinventé » en distances : on part de pages de confiance (les seeds), on donne une longueur à chaque lien, et on calcule le plus court chemin jusqu’à chaque page. Plus une page est proche d’une seed, mieux elle est notée. La version continuation précise que la longueur d’un lien dépend du nombre de liens sortants de la page source (plus elle en distribue, plus le lien est « long » et peu favorable), et que le score se déduit de la k-ième seed la plus proche, avec k entre 1 et n exclus. Autrement dit : être proche d’une seule bonne seed ne suffit pas. À noter que ça reste un brevet, pas une confirmation de ce qui tourne en production. Mais le raisonnement est cohérent avec ce qu’on observe sur le terrain, et il donne des pistes de maillage et de netlinking assez concrètes.
Cependant, la formulation simple de l’Équation (1) pour calculer le PageRank est vulnérable aux manipulations. Certaines pages Web (appelées « pages de spam ») peuvent être conçues pour utiliser diverses techniques afin d’obtenir des PageRanks artificiellement gonflés, par exemple, en formant des « fermes de liens » ou en créant des « boucles ».
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Pensez vos liens en distance, pas en volume. Un lien depuis une page de confiance qui en distribue peu pèse davantage (impact direct), et un lien qui vient d’une page noyée parmi des dizaines de sorties se dilue. Comme le score repose sur la k-ième seed la plus proche, avec k supérieur à 1, il vaut mieux être proche de plusieurs sources fiables que très proche d’une seule (impact indirect : ça pousse à diversifier le profil de liens). En interne, raccourcissez le chemin entre vos pages stratégiques et vos pages les plus fortes, et évitez de diluer le jus dans des pages hubs qui crachent des centaines de liens. Gardez la nuance : les seeds ne sont pas connues, donc on raisonne par proxy (sites d’autorité de votre thématique), pas par certitude.
Exemple : Votre page service est liée depuis un article de blog très fort mais qui contient 80 liens sortants : le lien est « long ». Un lien depuis une page de ressource sobre, avec 5 liens, vous rapproche davantage de la source de confiance. Et si cette page-là est citée par deux ou trois sites de référence différents, vous gagnez aussi sur le critère de la k-ième seed.
Thèmes : Positionnement, Backlinks, Intention de recherche, Analytics · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Quality visit measure for controlling computer response to query associated with physical location
US-10366422-B2 · déposé le 9 septembre 2015, délivré le 30 juillet 2019
Inventeur : Krzysztof Duleba
Ce brevet décrit un signal de classement local, la « quality visit measure », qui ne se contente pas de compter les passages : il pondère les visites répétées d’une même personne. Les avis, les mentions web et les données déclarées par le propriétaire sont jugés incomplets ou biaisés, donc Google lui préfère la présence physique observée (position de l’appareil, demandes d’itinéraire, check-ins, géotags). En gros, un lieu où on revient vaut plus qu’un lieu où on passe une fois. Pour un SEO local, c’est un signal qu’on ne pilote pas directement. Mais il change ce qu’on cherche à provoquer : de la fidélité, pas juste du trafic.
Cependant, le fait de se fier uniquement à de tels aspects peut présenter un ou plusieurs inconvénients. Par exemple, de tels aspects peuvent ne pas être disponibles pour de nombreux emplacements physiques, peuvent contenir un biais important, peuvent être obsolètes, peuvent ne pas être fondés sur des données fiables, et/ou peuvent ne pas inclure certains aspects uniques.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Mécaniquement, ça déplace l’effort du « récolter des avis » vers « faire revenir les gens » et « les faire venir à plusieurs ». Le brevet valorise aussi l’effet recommandation (une visite après la recommandation d’un tiers) et le « venu avec un ami ». À noter que le brevet mentionne un décalage (C0) qui atténue le poids de la mesure quand il y a peu de données : sur un lieu peu fréquenté, le signal pèse moins. Concrètement : soignez la fiche d’établissement pour déclencher des demandes d’itinéraire, travaillez la fidélisation (offres de retour, programmes de fidélité, incitations à venir à plusieurs), encouragez le bouche-à-oreille. Et gardez l’esprit critique : le brevet décrit un mécanisme possible, pas la preuve qu’il est actif tel quel dans le classement local aujourd’hui.
Exemple : Un restaurant avec peu d’avis mais une clientèle d’habitués qui revient chaque semaine peut, sur ce principe, être mieux jugé qu’un voisin très visité par des touristes de passage. Une offre « venez à deux » ou une carte de fidélité ne sert donc pas qu’à votre chiffre d’affaires : elle nourrit aussi, indirectement, le signal que Google pourrait lire.
Thèmes : SEO local, Expérience utilisateur, Positionnement, Réseaux sociaux · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Computerized systems and methods for extracting and storing information regarding entities
US-10198491-B1 · déposé le 6 juillet 2015, délivré le 5 février 2019
Inventeurs : Christopher Semturs, Lode Vandevenne, Danila Sinopalnikov et 5 autres
Ce brevet décrit comment Google (ou en tout cas un moteur) repère une entité qu’il ne connaît pas encore dans une page, puis lui colle une classe en regardant ce qui l’entoure : les entités déjà connues à proximité et le contexte lexical autour. En gros, une entité nouvelle est « comprise » par ses voisins de phrase. Pour faire simple, c’est du bootstrap : le moteur apprend le nouveau à partir du connu. Ça ne vous donne pas un signal de ranking à activer d’un clic, mais ça éclaire mécaniquement la façon dont votre marque, votre produit ou votre concept va être catégorisé. Votre texte autour du nom fait le travail de classification.
Cependant, les bases de connaissances conventionnelles peuvent ne pas fournir d’informations à jour ou fiables concernant des entités et d’autres informations souhaitées par les utilisateurs.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Quand vous introduisez une entité peu ou pas connue (marque, outil, produit, personne, concept), ce qui la classe, c’est la proximité dans le texte avec des entités déjà bien identifiées et un vocabulaire qui les relie sans ambiguïté. Donc : placez le nom à côté de ses entités de rattachement (catégorie, marché, concurrents connus, termes du domaine), avec des formulations explicites du type « X est un outil de… ». Le brevet décrit aussi un affinement itératif : plus d’entités connues voisines, y compris sur d’autres documents, peuvent mettre à jour la classe. La cohérence du contexte d’une page à l’autre compte donc (impact direct ET indirect). À noter aussi : la classe peut hériter des attributs d’une superclasse, donc une classification propre vous place dans le bon périmètre sémantique. À l’inverse, un nom isolé, entouré de contexte flou ou mixte, risque d’être mal classé, avec un score de confiance faible.
Exemple : Vous lancez un outil au nom inventé. Dans vos pages, écrivez « Zorbix, un outil d’audit de logs pour le SEO technique, comparable à [outils connus du domaine] », plutôt qu’un vague « Zorbix vous aide à passer au niveau supérieur ». Dans le premier cas, le moteur dispose de voisins connus et d’un contexte lexical clair pour classer l’entité.
Thèmes : Entités et sémantique, Knowledge Graph, Indexation, Intention de recherche · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Site quality score
US-9760641-B1 · déposé le 11 mai 2015, délivré le 12 septembre 2017
Inventeurs : April R. Lehman et Navneet Panda
Continuation du brevet US-9031929-B1
Ce brevet décrit un score de qualité calculé au niveau du site, sous forme de ratio. Au numérateur : les requêtes uniques qui visent le site (une marque, un nom, une requête navigationnelle, un « site label »). Au dénominateur : les requêtes uniques après lesquelles un utilisateur a cliqué sur un résultat de ce site. Cette continuation précise que le score entre explicitement dans le calcul de classement des résultats, donc qu’il pèse au moment du ranking et pas seulement comme métrique abstraite. Pour un SEO/GEO, c’est un signal de marque et de demande qui se traduit en levier de ranking : une marque recherchée pèse sur la façon dont on est classé. À noter que le résumé ne donne ni la formule exacte, ni le poids du signal, ni le sens précis dans lequel le ratio joue. Je reste donc prudent sur l’ampleur réelle.
Cette spécification décrit comment un système peut déterminer un score pour un site, par exemple, un site Web ou autre collection de ressources de données, tel qu’il est vu par un moteur de recherche, qui représente une mesure de la qualité du site. Le score est déterminé à partir de quantités indiquant des actions d’utilisateurs consistant à rechercher et à préférer des sites particuliers et les ressources trouvées dans des sites particuliers.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : La notoriété de marque, mesurée par les requêtes qui nomment votre site, devient un actif SEO à part entière, au même titre que les liens ou le contenu. Concrètement, travailler la demande de marque (nom de marque, nom + sujet, requêtes navigationnelles) a un impact direct sur le score, et un impact indirect via la confiance globale accordée au site. L’autre versant, c’est la capacité du site à capter des clics sur un large éventail de requêtes : un site qui n’est cliqué que sur des requêtes génériques sans jamais être recherché par son nom pèse un déséquilibre dans le ratio. Pensez donc en triptyque : cohérence du nom de marque, présence sur les requêtes où l’on vous cherche vraiment, et résultats qui méritent le clic. Reste à ne pas en faire un dogme, car l’effet chiffré n’est pas documenté ici.
Exemple : Un site e-commerce dont personne ne tape le nom dans Google mais qui ramasse du trafic sur des requêtes génériques a un profil fragile. En alimentant sa notoriété (newsletter, PR, contenus de référence qui font mémoriser le nom), il génère des requêtes « nom + produit » et renforce le signal de marque que ce score cherche à mesurer.
Thèmes : Positionnement, Expérience utilisateur, Intention de recherche, Analytics · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Systems and methods for improving the ranking of news articles
US-10459926-B2 · déposé le 27 avril 2015, délivré le 29 octobre 2019
Inventeurs : Michael Curtiss, Krishna A. Bharat et Michael Schmitt
Ce brevet décrit comment Google News ajuste le classement d’articles selon la qualité de leur source, calculée à partir de plusieurs métriques. Le plus parlant : le nombre d’entités nommées (personnes, lieux, organisations) qu’un article est seul à citer dans son cluster, c’est-à-dire le groupe d’articles qui traitent du même sujet. Pour faire simple, on récompense la source qui apporte de l’info originale, pas celle qui recopie la dépêche. À noter que ça vise le news, donc je ne le généraliserais pas à tout le web sans nuance (un brevet n’est pas une preuve d’usage en production). Mais le raisonnement, lui, est transposable : l’originalité factuelle et la rapidité sont des critères de qualité assumés.
Un système classe des résultats. Le système peut recevoir une liste de liens. Le système peut identifier une source avec laquelle chacun des liens est associé et classer la liste des liens sur la base, au moins en partie, d’une qualité des sources identifiées.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Si vous travaillez sur du contenu d’actualité ou éditorial, cherchez à être la source qui ajoute des éléments que les autres n’ont pas : noms, lieux, organisations cités et absents des articles concurrents. Publiez vite sur un événement (le score « breaking » décroît avec le délai, avec un seuil au-delà duquel il tombe à zéro), évitez le contenu dupliqué ou syndiqué, et travaillez la régularité de production d’articles non dupliqués. Impact direct : meilleur placement face à des sources moins originales sur un même sujet. Impact indirect : la qualité se calcule au niveau de la source, donc un site qui empile du contenu recyclé tire tout son domaine vers le bas.
Exemple : Sur une actualité sectorielle, au lieu de reformuler le communiqué de presse comme tout le monde, vous contactez l’entreprise concernée et citez un responsable, un site et un partenaire que les autres articles ne mentionnent pas. Votre article apporte alors des entités originales dans son cluster, ce qui est précisément le signal décrit.
Thèmes : Positionnement, Actualités, Entités et sémantique, Intention de recherche · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Re-ranking resources based on categorical quality
US-2019155948-A1 · demande de brevet déposée le 31 mars 2015
Inventeurs : Trystan G. Upstill, Abhishek Das, Jeongwoo Ko et 2 autres
Ce brevet décrit un re-ranking sélectif, appliqué seulement sur les requêtes dites « catégorielles » (du genre « hôtels à Lisbonne » ou « logiciel de facturation », où l’internaute cherche une catégorie, pas un site précis). Google prend le haut de la SERP, vérifie si ce lot de résultats est globalement solide (indépendamment des scores de pertinence pour la requête), et si oui, il réordonne ce sous-ensemble avec un score de qualité distinct. Pour faire simple, la pertinence brute ne fait plus tout le travail : les ressources populaires et autoritaires de la catégorie passent devant. Le classement initial n’est donc pas forcément le classement final. À noter : le brevet décrit un mécanisme, pas une garantie d’usage en production, donc on reste prudent.
Les systèmes et procédés décrits ci-dessous reclassent des ressources pour une requête catégorielle large en fonction de leur qualité correspondante dans la catégorie à laquelle la requête catégorielle correspond. L’ensemble des résultats de recherche reclassés est plus susceptible de montrer les sites web et les ressources qui servent le mieux la catégorie.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Sur les requêtes catégorielles, être dans le top-N ne suffit pas : il faut aussi ressembler à une ressource de référence pour la catégorie. Les signaux cités sont l’historique navigationnel (des requêtes qui mènent massivement vers votre site, via les logs de requêtes et de clics), la proximité thématique et le volume de sélections dans les résultats, avec des données qui peuvent remonter au niveau du domaine. Concrètement, cela pousse à travailler la notoriété de marque et la demande de marque associée à la catégorie (impact direct), et à bâtir un domaine cohérent sur son sujet (impact indirect). À l’inverse, sur les requêtes navigationnelles ou de réponse directe, ce re-ranking n’intervient pas, donc inutile d’y chercher ce levier.
Exemple : Vous avez un site de comparatifs positionné en 6e sur une requête large de catégorie, face à des acteurs installés. Si le lot de résultats passe le seuil de qualité, ceux dont les requêtes de marque et les clics sont forts peuvent être remontés. Votre priorité devient alors de renforcer la demande de marque et la cohérence thématique du domaine, plutôt que d’optimiser une énième balise title.
Thèmes : Positionnement, Intention de recherche, Expérience utilisateur, Qualité du contenu · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Evaluating semantic interpretations of a search query
US-10353964-B2 · déposé le 11 mars 2015, délivré le 16 juillet 2019
Inventeurs : Ashish Venugopal, Jakob D. Uszkoreit, John Blitzer et 1 autre
Prolongé par la continuation US-10521479-B2 (31 décembre 2019)
Ce brevet décrit comment Google tranche entre plusieurs sens possibles d’une requête ambiguë (un titre qui peut être un livre, un film ou un personnage, par exemple). Pour faire simple, il reformule la requête avec des termes issus de chaque intention candidate, relance la recherche, puis compare les résultats obtenus à ceux de la requête d’origine. Plus les deux listes se recoupent (intersection, ordre, fréquence de mots-clés), plus l’interprétation est jugée probable. Ce n’est pas un signal de ranking que vous pouvez actionner directement, mais ça éclaire la façon dont l’intention est validée par les résultats déjà en place. À noter que le brevet précise que ce procédé s’appuie sur des signaux déjà intégrés dans le classement (clics, trafic, données utilisateur), sans les analyser séparément.
Cependant, certaines requêtes de recherche peuvent être vagues ou ambiguës et peuvent ne pas être facilement associées à une intention particulière. Par exemple, une requête qui énonce « l’âge de Washington » pourrait se rapporter, par exemple, au président George Washington, à l’acteur Denzel Washington, à l’État de Washington ou à Washington D.C. Déterminer l’intention de l’utilisateur associée à de telles requêtes ambiguës peut être difficile.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Sur une requête ambiguë, votre page est mieux placée si votre contenu s’aligne sur l’intention dominante, celle dont les résultats ressemblent le plus à la SERP d’origine. Il faut donc que le vocabulaire de la page (nature de l’entité, termes de contexte qui la désambiguïsent) colle à l’intention visée, et pas seulement au nom de l’entité. À l’inverse, si vous ciblez une intention minoritaire, vous jouez contre le déséquilibre de la SERP : mieux vaut la cibler avec une requête qualifiée que de lutter sur le terme nu. Ce que je retiens, c’est que la lecture de la SERP actuelle reste votre meilleur outil de diagnostic d’intention. Prudence tout de même : le brevet décrit une évaluation, pas une garantie que Google l’applique ainsi sur chaque requête.
Exemple : Vous avez une page sur une entité au nom partagé entre un film et un livre, et la SERP penche massivement côté film. Si votre page parle du livre sans le dire clairement (pas de « roman », « auteur », « édition » dans le titre ou l’introduction), elle risque de se retrouver dans le lot de l’intention minoritaire, voire hors-sujet. Ajouter ces termes de désambiguïsation, ou viser directement la requête qualifiée, est le geste le plus stratégique.
Thèmes : Intention de recherche, Entités et sémantique, Positionnement, Embeddings · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Brevets déposés en 2014
Autocompletion using previously submitted query data
US-9740780-B1 · déposé le 1er décembre 2014, délivré le 22 août 2017
Inventeurs : Michael Herscovici, Dan Guez et Hyung-Jin Kim
Ce brevet décrit une autocomplétion qui ne se contente pas de matcher le début de ce que tape l’internaute. Elle s’appuie aussi sur l’historique des requêtes et sur le comportement observé après les recherches précédentes : clics, temps passé sur un document, langue, localisation. Les mêmes logs de clics servent à la fois à reclasser les résultats et à proposer des suggestions. Pour un SEO, ça ne se pilote pas directement (on n’achète pas une suggestion), mais ça éclaire un point stratégique : la visibilité dans les suggestions et la satisfaction réelle sur les pages sont liées. Les suggestions reflètent ce que les gens font, pas seulement ce qu’ils tapent. À noter que le brevet reste un descriptif d’architecture, sans pondération chiffrée ni garantie qu’un signal précis pèse davantage qu’un autre.
Un procédé mis en œuvre par ordinateur pour traiter des informations de requête comprend la réception d’informations de requête au niveau d’un système serveur. Les informations de requête comprennent une partie d’une requête d’un demandeur de recherche. Le procédé comprend également l’obtention d’un ensemble de requêtes prédites pertinentes par rapport à la partie de la requête du demandeur de recherche sur la base de la partie de la requête du demandeur de recherche et de données indicatives du comportement du demandeur de recherche par rapport à des requêtes précédemment soumises.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Les suggestions étant conditionnées par le comportement passé (clics sur les documents, langue, localisation), travailler l’intention et la satisfaction sur vos pages a un impact direct sur le classement ET un impact indirect sur les requêtes qui seront proposées aux utilisateurs. Concrètement : un contenu qui répond vraiment à la requête (pas de retour en arrière vers la SERP) nourrit le même socle de signaux que celui qui sert au ranking. Côté recherche de mots-clés, l’autocomplétion est un reflet de comportements agrégés, donc à lire selon la langue et le pays ciblés. Le brevet prévoit aussi un second jeu de suggestions à la demande, dédoublonné par rapport au premier, ce qui laisse penser que des variantes de longue traîne apparaissent en deuxième rideau. Par prudence : ce sont des pistes de lecture, pas des leviers mesurés.
Exemple : Vous visez une requête partiellement tapée du type « logiciel facturation » : comparez les suggestions en France, en Belgique et en Suisse, et en navigation privée comme connecté. Si les complétions varient, adaptez vos pages et vos intitulés à ces formulations locales, puis vérifiez que le contenu répond bien à l’intention derrière chacune pour éviter le rebond vers la SERP.
Thèmes : Autocomplétion, Personnalisation des résultats, Expérience utilisateur, Intention de recherche · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Propagating query classifications
US-9659097-B1 · déposé le 21 août 2014, délivré le 23 mai 2017
Inventeurs : Henele I. Adams et Hyung-Jin Kim
Continuation du brevet US-8838587-B1
Ce brevet décrit comment Google attribue une classification (une étiquette d’intention, type « local », « actualité », etc.) à une requête en regardant les sessions de recherche. Pour faire simple : si les requêtes et documents qui reviennent souvent autour d’une requête sont déjà classés, celle-ci hérite de la classification, avec un seuil à franchir. Cette étiquette se propage ensuite aux reformulations faites par le même utilisateur dans la même session. Vous ne piloterez pas ce mécanisme directement, mais il éclaire la façon dont l’intention est inférée et étendue, et ça compte pour le ciblage. Votre page est jugée dans un parcours, pas isolée.
Étant donné la brièveté de nombreuses requêtes, les classifications de requêtes basées sur une requête elle-même peuvent être difficiles à déterminer avec précision. Par exemple, la requête « lincoln » pourrait être classée comme se rapportant à une figure historique (par exemple, le président Lincoln), à une localisation géographique (par exemple, Lincoln, Nebr.), à un produit (par exemple, la marque de voiture Lincoln), etc.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : L’intention d’une requête n’est pas décidée seule : elle est déduite des requêtes voisines et des documents associés dans les sessions, puis étendue aux reformulations. Concrètement, travaillez les clusters de requêtes d’un même parcours (requête initiale, affinages, variantes) plutôt que des mots-clés isolés, et alignez le type de contenu sur l’intention dominante de ce parcours. À noter que les documents retenus côté clics le sont aussi selon le temps passé après sélection : une page qui renvoie vite le visiteur vers la SERP (la page de résultats) est un mauvais candidat pour porter l’intention. L’impact est direct sur la pertinence perçue de la page, et indirect sur les reformulations qui héritent de la même étiquette. Reste à nuancer : le brevet ne donne aucun seuil chiffré, et ce n’est pas un signal de ranking activable en soi.
Exemple : Si les internautes enchaînent « meilleur aspirateur robot » puis « aspirateur robot poils d’animaux » dans une même session, la classification de intention (comparatif/achat) de la première peut se propager à la seconde. Une page de test comparatif qui retient l’utilisateur longtemps colle au parcours, alors qu’une fiche produit isolée sur la reformulation risque d’être décalée.
Thèmes : Intention de recherche, Entités et sémantique, Questions-réponses, Positionnement · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Context scoring adjustments for answer passages
US-9959315-B1 · déposé le 31 janvier 2014, délivré le 1er mai 2018
Inventeurs : Nitin Gupta, Srinivasan Venkatachary, Lingkun Chu et 1 autre
Prolongé par la continuation US-11409748-B1 (9 août 2022)
Voilà un brevet qui parle directement à celles et ceux qui bossent la position zéro et les réponses générées. Google ne choisit pas un passage uniquement parce qu’il répond bien à la question : il le repondère avec le contexte structurel de la page. Concrètement, la hiérarchie des titres (H1, H2, H3…) devient un signal de sélection. Pour faire simple, votre balisage n’est pas de la déco, il pèse mécaniquement dans le score. Et c’est du concret, pas de la théorie : le brevet détaille les facteurs un par un, donc on peut les travailler.
Certaines requêtes de question sont mieux servies par des réponses explicatives, qui sont également appelées « longues réponses » ou « passages de réponse ». Par exemple, pour la requête de question [pourquoi le ciel est bleu], une réponse expliquant la diffusion de Rayleigh est utile.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Structurez vos pages comme un plan que la machine peut lire. 1) Hiérarchie de titres propre et profonde : la profondeur du titre dans l’arbre fait monter le score, avec des boosts différents selon un seuil de profondeur. Un H3 bien rangé sous un H2 pertinent peut donc valoir mieux qu’un contenu à plat. 2) Titres qui reprennent la formulation de la question : la similarité entre la requête et le titre compte, et le brevet compare aussi la requête au titre + titre parent + ancêtres. Le fil d’Ariane des titres doit donc raconter la même histoire que la question. 3) Passage qui couvre l’essentiel de sa section : le ratio entre la longueur du passage et celle du bloc d’où il vient augmente le score. Évitez de noyer la réponse dans trois paragraphes de blabla, une section = une réponse nette. 4) Phrase-question juste avant la réponse : si elle matche la requête, boost. 5) Pour les requêtes « comment faire » (étapes), une vraie liste (ol/ul) reçoit un boost de liste. À noter que ces signaux sont en partie indépendants de la requête : ils dépendent de la qualité de structure de la page, pas des mots-clés.
Exemple : Une page « Comment changer un pneu » : un H1, puis un H2 « Comment changer un pneu crevé ? » avec en dessous une liste numérotée courte d’étapes, plutôt qu’un H2 vague type « Nos conseils » suivi d’un pavé de texte. Le titre colle à la requête, la liste répond au besoin « étapes », et le passage occupe l’essentiel de sa section : trois leviers cumulés pour que ce bloc passe devant en answer box.
Thèmes : Questions-réponses, Featured snippet, Intention de recherche, Balisage on-page · Intérêt SEO : 9/10 · Lire le brevet sur Google Patents
Brevets déposés en 2013
Structured user graph to support querying and predictions
US-10482139-B2 · déposé le 5 novembre 2013, délivré le 19 novembre 2019
Inventeurs : Pranav Khaitan et Shobha Diwakar
Prolongé par la continuation US-11397784-B2 (26 juillet 2022)
Ce brevet décrit un graphe de connaissances propre à chaque utilisateur. Il est alimenté par ses mails, son agenda, ses photos, ses avis, ses check-ins (et sa recherche, forcément), puis interrogé pour répondre à des requêtes personnalisées ou prédire ses activités et ses déplacements. Le mécanisme est malin : chaque lien entre une activité et une période a un poids qui monte quand elle est répétée et qui baisse sans renforcement. On ne répond qu’au-dessus d’un seuil. Mais soyons honnêtes : tout ça se passe dans les données privées de l’utilisateur, donc vous n’avez aucun levier direct dessus. C’est utile pour comprendre la direction (personnalisation poussée), pas pour changer votre checklist du lundi matin.
Les mises en œuvre de la présente divulgation sont généralement dirigées vers des graphes structurés spécifiques à l’utilisateur qui peuvent être utilisés pour prendre en charge des requêtes soumises par des utilisateurs et/ou des prédictions pertinentes pour des utilisateurs. Plus particulièrement, les mises en œuvre de la présente divulgation sont dirigées vers la fourniture d’un graphe structuré spécifique à l’utilisateur qui est spécifique à un utilisateur particulier.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir, c’est que la SERP peut mécaniquement varier d’un utilisateur à l’autre selon son historique d’activités réelles. Un rang moyen ou un classement figé deviennent donc des indicateurs à relativiser. Côté contenu, le seul levier indirect : être clair sur les entités (lieux, activités, périodes) et leurs relations, pour être facilement rattaché à ces intentions personnelles. Et mieux vaut un signal répété et cohérent qu’un one-shot, puisque ce brevet repose sur le renforcement. Mais c’est une lecture de ma part, le brevet ne parle pas de contenu de sites web.
Exemple : Un site de randonnées ou de tourisme local qui traite chaque lieu avec ses activités et ses saisons, de façon explicite et cohérente, est plus facile à relier à un utilisateur dont le graphe indique qu’il part régulièrement en montagne chaque été. À l’inverse, vous ne pouvez pas « injecter » quoi que ce soit dans ce graphe : testez vos positions avec des profils variés, plutôt que de vous fier à un seul classement.
Thèmes : Knowledge Graph, Entités et sémantique, Intention de recherche, Personnalisation des résultats · Intérêt SEO : 4/10 · Lire le brevet sur Google Patents
Predicting site quality
US-9767157-B2 · déposé le 15 mars 2013, délivré le 19 septembre 2017
Inventeurs : Navneet Panda et Yun Zhou
Ce brevet décrit comment Google peut prédire la qualité d’un site entier sans qu’il ait été noté au préalable. Pour faire simple, il regarde sur quelle proportion de pages du site apparaissent certaines expressions (des n-grammes de 2 à 5 mots), puis compare avec des sites déjà notés. Cette prédiction sert ensuite de signal de qualité de site dans le ranking, pour les sites qui n’ont pas de score de référence. Ce qu’il faut retenir : la qualité se juge ici à l’échelle du site, pas page par page, et le vocabulaire récurrent d’un site devient mécaniquement un indice de sa qualité. Reste à nuancer : le brevet ne dit pas quelles phrases sont « bonnes » ou « mauvaises », donc pas de liste magique à recopier (et tant mieux 😉).
Cette spécification décrit comment un système peut déterminer un score pour un site, par exemple un site web ou une autre collection de ressources de données, destiné à être utilisé dans le classement par un moteur de recherche, qui représente une mesure de qualité pour le site. Le score de qualité du site pour un site peut être utilisé comme un signal pour classer des ressources, ou pour classer des résultats de recherche qui identifient des ressources, qui se trouvent sur un site par rapport à des ressources trouvées sur un autre site.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Votre site est lu comme un tout : la façon dont vos expressions se répartissent sur l’ensemble de vos pages pèse sur un score de qualité qui peut s’appliquer à chacune de vos URLs. Du contenu faible ou calibré à la chaîne, répété sur beaucoup de pages, peut donc tirer tout le site vers le bas, alors qu’un vocabulaire riche et cohérent avec votre expertise tire dans l’autre sens. Cela renforce l’intérêt d’élaguer ou d’améliorer les pages médiocres plutôt que d’empiler du volume, et de soigner la qualité de manière homogène. À noter que les textes associés aux pages, comme les ancres, peuvent aussi entrer dans le calcul, donc le maillage interne compte aussi. Autre point : un site neuf ou peu connu peut être jugé avant d’avoir acquis la moindre réputation, uniquement sur sa signature lexicale. Enfin, si trop peu de phrases sont connues du modèle, aucune prédiction n’est faite.
Exemple : Vous gérez un site de niche avec 300 pages dont 200 sont des fiches générées à partir du même gabarit, avec les mêmes tournures partout. Ces expressions très présentes sur une grande part des pages peuvent, si le modèle les associe à des sites de faible qualité, tirer vers le bas le score prédit de tout le site, y compris pour vos meilleurs articles. Réécrire ou fusionner ces fiches, ou les désindexer, rééquilibre la signature lexicale du site.
Thèmes : Positionnement, Qualité du contenu, Spam, Recherche de mots-clés · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Question answering using entity references in unstructured data
US-9477759-B2 · déposé le 15 mars 2013, délivré le 25 octobre 2016
Inventeurs : Dvir Keysar et Tomer Shmiel
Prolongé par la continuation US-10339190-B2 (2 juillet 2019)
Ce brevet décrit comment Google peut répondre à une question de type « qui ? » sans base de données curatée : il prend les résultats de recherche les mieux classés, en extrait les entités citées (personnes, lieux, films…), puis fait un vote pondéré. L’entité la plus citée, avec un poids plus fort pour les pages haut placées, devient la réponse. Ce qui compte pour vous : la réponse ne se joue plus seulement au niveau de la page, mais au niveau de l’entité, agrégée sur un corpus. On ne classe pas des pages, on fait voter des mentions. À noter que c’est un brevet, donc rien ne prouve que ce mécanisme tourne tel quel aujourd’hui. Mais la logique est très proche de ce que font les moteurs de réponse et les IA génératives, et elle donne des pistes assez concrètes.
Des méthodes, des systèmes et des supports lisibles par ordinateur sont fournis pour la réconciliation collective.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Trois leviers, à nuancer. 1) Être bien classé reste le prérequis : les mentions des pages du haut de classement pèsent plus lourd dans le vote (impact direct). 2) Nommer clairement les entités dans le texte, avec une forme cohérente d’une page à l’autre, facilite leur extraction et leur comptage. Une entité citée de façon vague ou sous des formes variées se fait mal agréger (impact indirect). 3) La fréquence est normalisée par la longueur du document, donc gonfler un texte avec des répétitions ne sert à rien : c’est la pertinence de la mention qui compte, pas le volume. Le brevet évoque aussi un score de topicalité lié aux liens entrants et sortants, ce qui rappelle que l’autorité de la source garde son rôle. Enfin, si deux entités sont à égalité, Google regarde plus bas dans les résultats : être cité de façon cohérente même sur des pages moyennes peut faire la différence.
Exemple : Vous travaillez sur un site de cinéma et visez des requêtes du type « qui a réalisé tel film ». Plutôt que de noter le nom du réalisateur une fois, noyé dans un paragraphe, nommez-le explicitement et de façon uniforme dans le titre, l’intro et les données structurées de chaque fiche. Votre page, si elle est bien classée, apporte alors une mention nette au vote, au lieu d’une mention ambiguë que l’extraction risque de rater.
Thèmes : Questions-réponses, Entités et sémantique, Positionnement, Knowledge Graph · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Question answering to populate knowledge base
US-10108700-B2 · déposé le 15 mars 2013, délivré le 23 octobre 2018
Inventeurs : Rahul Gupta, Shaohua Sun, John Blitzer et 2 autres
Ce brevet décrit une boucle fermée : Google repère dans son knowledge graph (sa base d’entités et de leurs propriétés) une donnée manquante, périmée ou contradictoire, génère une question ciblée, l’envoie à un moteur de réponse (recherche web, question answering, index de questions déjà traitées), puis réécrit la réponse dans le graphe. Pour faire simple : le graphe se répare tout seul en posant des questions à la recherche. Vous me direz que c’est du plomberie interne, et vous avez en partie raison, rien ici ne ressemble à un facteur de ranking. Mais le levier indirect est réel : si votre site fait partie des sources qui répondent bien à ces questions ciblées, vous alimentez le graphe, et pas seulement les résultats.
La présente divulgation concerne généralement la mise à jour d’informations dans une base de données. Des données ont précédemment été mises à jour par, par exemple, une saisie utilisateur.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Les requêtes générées sont tirées du type d’entité, de la propriété manquante et de termes de désambiguïsation (des valeurs déjà connues de l’entité). Une page qui associe clairement l’entité, son contexte et la valeur recherchée dans une formulation directe (une phrase claire, pas noyée dans le décor) a plus de chances d’être retenue comme réponse. À noter que le brevet prévoit aussi la détection de données périmées via un conflit avec l’historique de recherche : garder vos infos factuelles à jour, et cohérentes d’une page à l’autre, devient stratégique. Impact direct sur la fiabilité de vos pages comme source, indirect sur la présence et l’exactitude de votre entité dans les knowledge panels et les réponses générées. Reste à garder l’esprit critique : le brevet ne dit pas quelles sources sont choisies ni comment elles sont pondérées.
Exemple : Une marque dont le fondateur ou la date de création est absent du graphe : la requête générée ressemblera à « [nom de la marque] date de création ». Si votre page « À propos » l’énonce noir sur blanc, avec le nom exact de l’entité à côté, vous êtes bien placé pour fournir la valeur qui comblera le trou.
Thèmes : Questions-réponses, Knowledge Graph, Entités et sémantique, Intention de recherche · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Providing search results using augmented search queries
US-10055462-B2 · déposé le 15 mars 2013, délivré le 21 août 2018
Inventeurs : Emily Moxley et Sean Liu
Ce brevet décrit comment Google gère une requête qui contient une référence d’entité ambiguë (typiquement un nom de personne partagé par plusieurs individus). Il sépare d’abord les entités dans les résultats, puis il extrait des attributs de ces résultats (titres, personnes associées, thèmes) et propose des requêtes enrichies du type « entité + attribut » que l’utilisateur peut cliquer. Pour faire simple : c’est le mécanisme derrière les suggestions de raffinement sur les noms ambigus. Il ne vous donne pas un signal de ranking, mais il montre quels attributs de vos contenus servent de levier pour être rattaché à la bonne entité, et c’est un levier indirect réel. À noter : je m’en tiens à ce que le brevet décrit, il ne dit rien de la mise en production exacte.
Les moteurs de recherche reçoivent des requêtes de recherche contenant une référence à une personne, telle que le nom de la personne. Les résultats de ces requêtes ne sont souvent pas suffisamment organisés, pas assez complets, ou autrement pas présentés d’une manière utile.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Les attributs sont extraits des résultats eux-mêmes, à partir de données structurées (knowledge graph, graphe social) ou non structurées (le texte de vos pages), puis classés selon leur fréquence d’apparition et leur position par rapport à la référence d’entité. Si votre nom, votre marque ou votre sujet est ambigu, vous avez donc intérêt à répéter de façon cohérente les mêmes attributs distinctifs (fonction, domaine, lieu, thématique) tout près de la mention de l’entité, dans le texte comme dans le balisage. Impact direct ET indirect : vous aidez Google à vous distinguer des homonymes, et vous augmentez la chance que les requêtes enrichies générées à partir des résultats pointent vers votre périmètre plutôt que vers celui d’un autre. Ce qui reste flou, c’est le poids réel de ce classement en production. Je ne ferais donc pas de ce brevet un dogme, mais une raison de plus de soigner la désambiguïsation.
Exemple : Vous gérez le site d’un consultant dont le nom est partagé par plusieurs personnes. Plutôt que de laisser son nom isolé, vous le faites systématiquement suivre de la même fonction et du même domaine (« Prénom Nom, consultant SEO à Lyon ») dans le titre, l’intro, la page « à propos » et le balisage Person. Ces attributs deviennent les plus fréquents et les mieux placés autour de l’entité, donc les meilleurs candidats pour les raffinements proposés.
Thèmes : Intention de recherche, Entités et sémantique, Knowledge Graph, Autocomplétion · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Ranking events
US-9424360-B2 · déposé le 12 mars 2013, délivré le 23 août 2016
Inventeurs : Kavi J. Goel, Toshihiro Yoshino, Yang-Hua Chu et 4 autres
Ce brevet décrit comment Google classe des événements pour un lieu et une période donnés, avec un score de popularité bâti sur plusieurs signaux. Le principal : combien de sites mentionnent l’événement, et à quelle position remonte la meilleure mention dans les résultats d’une requête du type « lieu + événements ». Autour, on trouve des garde-fous : démotion si les mentions sont concentrées sur des billetteries, prise en compte de la page officielle, de la popularité des entités liées, de la catégorie et de la capacité de la salle. Un second passage de re-ranking pénalise les doublons et les événements trop similaires. Attention, c’est un brevet sur un cas précis (les événements locaux), donc pas une loi générale du ranking. Mais il montre une logique de pertinence transposable, et le levier est réel pour qui travaille l’événementiel ou le local.
Étant donné que de nombreux événements dans une région géographique peuvent se produire au même moment ou à des moments se chevauchant, les personnes intéressées peuvent parfois avoir du mal à déterminer à quels événements assister. Par exemple, des personnes peuvent ignorer que des événements présentant un intérêt sont programmés pour se produire ou peuvent avoir des difficultés à identifier les événements les plus intéressants lorsque plusieurs événements se déroulent.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Pour un événement, la visibilité dépend de la quantité de sites tiers qui le citent ET de la nature de ces sites : si tout vient de billetteries, le score est démoté. Il faut donc travailler les mentions éditoriales (presse locale, agendas, blogs, offices de tourisme), soigner une page officielle unique et bien identifiée, et clarifier les entités associées (artiste, lieu, organisateur). Le re-ranking anti-doublons signale aussi qu’inonder une SERP de pages quasi identiques est contre-productif : on gagne à différencier chaque événement (catégorie, attributs, angle) plutôt qu’à dupliquer. Impact direct sur l’événement lui-même, indirect sur la perception de l’entité organisatrice.
Exemple : Vous gérez le site d’un festival : plutôt que de compter uniquement sur la billetterie partenaire, vous poussez des mentions dans les agendas locaux et la presse régionale, avec une page officielle claire (lieu, dates, artistes). Et pour une série de concerts très proches, vous donnez à chaque page un angle distinct plutôt que des clones, pour ne pas vous faire écraser par la logique de suppression des similaires.
Thèmes : Positionnement, Intention de recherche, SEO local, Entités et sémantique · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Brevets déposés en 2012
Selectively generating alternative queries
US-9135307-B1 · déposé le 27 décembre 2012, délivré le 15 septembre 2015
Inventeurs : Navneet Panda, April R. Lehman et Trystan G. Upstill
Ce brevet décrit un garde-fou de qualité posé sur les résultats. Si le haut du classement d’une requête est dominé par des sites déjà étiquetés « basse qualité » (au moins N résultats), Google ne se contente pas de servir la liste telle quelle. Il va chercher une requête alternative dans une table de correspondances précalculée, vérifie que les premiers résultats de cette requête viennent majoritairement de sites « haute qualité » (au moins M), puis injecte un de ces résultats dans la réponse à la requête d’origine. Ce qu’il faut retenir : la qualité se juge ici au niveau du site, pas seulement de la page. Et un site mal étiqueté peut se faire doubler par une page venue d’une requête voisine. À noter que le brevet reste prudent sur les détails (seuils N et M non chiffrés, classification « équivalente »), donc pas de règle magique à en tirer.
La présente spécification concerne l’augmentation sélective des résultats de recherche Internet avec des résultats de recherche provenant de sites identifiés comme étant des sites de haute qualité.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le levier est indirect ET direct. Indirect : la réputation globale du site pèse sur vos chances d’apparaître, même avec une page très pertinente, puisque le test porte sur la liste des sites de basse ou de haute qualité. Direct : sur une requête où le haut de SERP est truffé de sites faibles, une place est à prendre, mais seulement si vous êtes sur un domaine perçu comme fiable et positionné sur la requête alternative (reformulation par synonyme ou concept voisin). Il est donc stratégique de couvrir les variantes sémantiques proches de vos requêtes cibles, et d’assainir le site (pages minces, contenu bas de gamme) plutôt que de peaufiner une page isolée. Pour faire simple : sur un domaine étiqueté faible, la meilleure page du monde part avec un handicap.
Exemple : Vous visez une requête de niche dont le top 10 est occupé par des fermes de contenu et des sites d’avis douteux. Si votre site est solide, travaillez aussi la requête voisine (synonyme, formulation plus précise) sur laquelle les sites de qualité dominent : votre page peut alors être réinjectée dans les résultats de la requête d’origine, même sans y être classée à la base.
Thèmes : Positionnement, Query fan-out, Intention de recherche, Qualité du contenu · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Ranking search results based on entity metrics
US-10235423-B2 · déposé le 12 décembre 2012, délivré le 19 mars 2019
Inventeurs : Hongda Shen, David Francois Huynh, Grace Chung et 3 autres
Ce brevet décrit un classement des résultats qui s’appuie sur le Knowledge Graph (la base d’entités et de relations de Google), pas seulement sur la correspondance avec les mots de la requête. Chaque résultat reçoit plusieurs métriques (relatedness, type d’entité notable, contribution, prix), pondérées selon le type d’entité et son domaine (Films, Livres, Personnes, Lieux). Au moins une métrique est indépendante de la requête : un signal d’entité peut donc peser sans qu’un seul mot-clé n’ait été tapé. Il ne fournit pas de formule à optimiser, et rien ne dit que c’est appliqué tel quel au web search. Reste que c’est un bon rappel : pour une entité, la notoriété et la cohérence du graphe comptent autant que le texte de la page. Le levier est indirect mais réel.
Des méthodes, des systèmes et des supports lisibles par ordinateur sont fournis pour classer des résultats de recherche. Un système de recherche peut déterminer plusieurs métriques sur la base de résultats de recherche. Le système de recherche peut déterminer des poids pour les métriques, les poids étant fondés en partie sur le type d’entité inclus dans la recherche.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Travaillez la reconnaissance de votre entité (marque, personne, produit, lieu) comme un actif à part entière, en plus du ciblage de mots-clés. Cela passe par une identité claire et cohérente sur le web, des données structurées qui la décrivent, et des mentions de qualité qui l’associent aux bonnes entités voisines (c’est la logique de la relatedness, fondée sur la co-occurrence : l’entité et ses voisines apparaissent proches dans les textes). Visez aussi les signaux de reconnaissance propres à votre secteur (avis critiques, distinctions), car la pondération change selon le domaine. Impact direct sur les requêtes centrées sur une entité, indirect sur le reste. À noter : ce que le brevet cite comme exemples (Oscars, critiques) ne se transpose pas mécaniquement à tous les secteurs, donc prudence sur l’extrapolation.
Exemple : Vous gérez le site d’un auteur ou d’un réalisateur : plutôt que de publier dix pages optimisées sur des variantes de mots-clés, consolidez sa fiche d’entité (balisage Person/Book/Movie, liens vers ses profils de référence) et obtenez des mentions et critiques sur des sources reconnues du domaine, qui l’associent à ses œuvres et à ses entités proches.
Thèmes : Positionnement, Knowledge Graph, Entités et sémantique, SERP · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Providing search results based on sorted properties
US-9256682-B1 · déposé le 5 décembre 2012, délivré le 9 février 2016
Inventeurs : Yiming Li et Zhenyu Gu
Prolongé par la continuation US-9875320-B1 (23 janvier 2018)
Ce brevet décrit comment Google décide, pour une entité donnée, quelle relation mérite d’être mise en avant. Prenons Tom Hanks : ses films en tant qu’acteur ou en tant que réalisateur ? Pour trancher, chaque entité liée reçoit un score (basé notamment sur la co-occurrence dans les contenus), puis ces scores sont additionnés par propriété. La propriété qui pèse le plus devient la « face » dominante de l’entité. Ce n’est pas un levier de ranking direct, mais ça éclaire la façon dont une entité se construit. À noter que le brevet reste un mécanisme de knowledge graph, pas un guide de rédaction : on en tire du raisonnement, pas une recette.
Les moteurs de recherche fournissent parfois à un utilisateur des informations en réponse à une requête qui peuvent ne pas être exactement celles qui étaient désirées. Cela peut se produire dans des cas où un sujet de la requête peut être considéré sous différentes perspectives.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Les propriétés d’une entité se hiérarchisent selon le poids cumulé des entités qui lui sont associées dans les contenus. Pour un SEO/GEO, cela rend stratégique la cohérence de vos co-occurrences : si vous voulez que votre marque, votre auteur ou votre produit soit perçu sous un angle précis (expert en X plutôt que généraliste), il faut que les entités associées à cet angle reviennent de façon répétée et claire autour de lui, sur votre site comme ailleurs. L’impact est direct sur la désambiguïsation du « sens dominant » et indirect sur les formats qui s’appuient sur le graphe (panneaux de connaissances, réponses d’IA). À l’inverse, un contenu qui disperse les angles dilue le déséquilibre en votre faveur. Les types et sous-types sont aussi agrégés, donc mieux vaut un positionnement lisible dans une même famille thématique. Nuance : le brevet ne précise pas dans quelle mesure ce signal pèse sur le classement des pages.
Exemple : Vous gérez le site d’un consultant qui veut être identifié comme spécialiste du SEO technique, mais ses pages mentionnent surtout du content marketing. Recentrez les contenus, les bios et les mentions externes sur les entités du SEO technique (crawl, indexation, logs) pour que cette propriété l’emporte sur les autres dans l’association à son nom.
Thèmes : Knowledge Graph, Entités et sémantique, Positionnement, Intention de recherche · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Ranking search results
US-8682892-B1 · déposé le 28 septembre 2012, délivré le 25 mars 2014
Inventeurs : Navneet Panda et Vladimir Ofitserov
Ce brevet décrit un facteur de modification appliqué par groupe de ressources (typiquement un domaine ou un hôte). Il repose sur le rapport entre les liens entrants indépendants et les « reference queries », c’est-à-dire les requêtes d’utilisateurs qui visent clairement ce site. Si beaucoup de gens cherchent votre marque ou votre site mais que peu de sites indépendants font un lien vers vous, le déséquilibre est mal vu : les scores initiaux de vos pages peuvent être rabotés. Vous me direz que c’est un brevet, pas une confirmation de ce qui tourne en production, et vous aurez raison. Mais c’est un signal de qualité au niveau du site entier, assez rare à voir décrit aussi précisément, avec un impact direct ET indirect sur l’ensemble de vos pages.
Les moteurs de recherche Internet visent à identifier des ressources, par exemple des pages web, des images, des documents texte, du contenu multimédia, qui sont pertinentes pour les besoins d’un utilisateur et à présenter des informations sur les ressources d’une manière qui est la plus utile pour l’utilisateur. Les moteurs de recherche Internet renvoient généralement un ensemble de résultats de recherche, dont chacun identifie une ressource, en réponse à une requête soumise par un utilisateur.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Surveillez le déséquilibre entre demande de marque et autorité externe. Une notoriété sans liens indépendants (sites vraiment distincts, pas un réseau de domaines liés entre eux ni des doublons) est un profil à risque de démotion. À noter que le mécanisme est borné : il ne touche pas les requêtes navigationnelles (quelqu’un qui cherche votre site précis), ni les résultats à faible score initial, et son effet est lissé sur les très bons scores. Le levier est donc stratégique sur les requêtes informationnelles, pas sur la marque. Un netlinking cohérent avec la demande réelle compte plus qu’un volume de liens brut, et les liens entre vos propres domaines ou sites apparentés ne comptent pas comme indépendants.
Exemple : Un site de niche qui a gagné en notoriété via la pub, les réseaux sociaux ou la newsletter voit sa marque beaucoup recherchée, mais n’a que quelques liens de sites tiers indépendants. Ses pages peuvent perdre des places sur des requêtes génériques, alors que sa requête de marque reste intacte. Le chantier consiste à obtenir des mentions et des liens de sources réellement distinctes pour rééquilibrer le ratio.
Thèmes : Positionnement, Backlinks, Intention de recherche, Contenu dupliqué · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Document scoring based on traffic associated with a document
US-9767478-B2 · déposé le 14 septembre 2012, délivré le 19 septembre 2017
Inventeur : Steve Lawrence
Continuation du brevet US-8316029-B2
Le titre et l’abstract parlent de trafic et de publicités dans le document, mais les revendications délivrées portent sur autre chose : la baisse du nombre de liens pointant vers une page entre deux périodes. Si cette baisse s’accompagne de liens restants peu pondérés, la page est jugée « périmée » (stale) et son score descend. C’est donc une lecture de la fraîcheur par le profil de liens, pas par la date de mise à jour affichée. Le brevet cite aussi d’autres signaux historiques (date d’inception, mises à jour du contenu, trafic, comportement utilisateur, historique de ranking), mais seul le volet liens est réellement revendiqué. Le levier est indirect mais réel, à condition de ne pas lui faire dire plus que ce qu’il dit : on ne sait pas, à partir de ce texte, si Google l’applique tel quel aujourd’hui.
Les deux catégories de moteurs de recherche s’efforcent de fournir des résultats de haute qualité pour une requête de recherche. Il existe plusieurs facteurs qui peuvent affecter la qualité des résultats générés par un moteur de recherche.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Surveillez la dynamique de vos backlinks dans le temps, pas seulement leur stock. Une page qui perd des liens sans en regagner, et dont les liens restants pèsent peu, ressemble à un document en fin de vie. Il y a un impact direct (le score de la page baisse) ET indirect : les liens sortant de ces pages « périmées » peuvent être ignorés ou atténués dans le score des documents qu’ils pointent. Un lien reçu d’une page qui s’éteint vaut donc moins que son apparence ne le laisse croire. Côté stratégie, on entretient ses pages piliers (mise à jour réelle, nouveaux liens, relais) et on évalue la durabilité d’une source avant d’en convoiter un lien.
Exemple : Votre guide de référence a accumulé ses liens il y a quelques années, puis plus rien : le nombre de liens baisse et ceux qui restent sont faibles. Relancez-le avec du contenu réellement refondu, puis un travail de netlinking et de relais pour recréer un flux de liens frais, plutôt que de changer la date de publication en espérant que ça suffise.
Thèmes : Positionnement, Fraîcheur du contenu, Backlinks, Contenu dupliqué · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Information extraction from a database
US-8589387-B1 · déposé le 14 septembre 2012, délivré le 19 novembre 2013
Inventeur : Sergey Brin
Continuation du brevet US-8332371-B1
Ce brevet décrit DIPRE : on part de quelques exemples (des tuples, par exemple un titre de livre + son auteur), on repère comment ils sont écrits dans les pages (texte avant, texte au milieu, texte après), on en déduit un gabarit, puis on s’en sert pour aller chercher plein d’autres tuples. Et on recommence. Pour faire simple, c’est une machine à apprendre des faits à partir de la structure répétée des pages web. Ce qu’il faut retenir, c’est que ce n’est pas un signal de ranking, et le brevet ne dit pas que Google l’applique à votre site. Mais il éclaire une mécanique : un fait est d’autant plus crédible qu’il est confirmé par plusieurs motifs distincts. Utile à comprendre, levier ténu.
L’Internet, et plus particulièrement le World Wide Web (« Web »), est un vaste dépôt d’informations qui est extrêmement distribué, tant dans l’emplacement que dans la manière dont l’information est stockée. Par exemple, un type particulier de données tel que des listes de restaurants peut être dispersé sur des milliers de sources d’information indépendantes (par exemple, des hôtes) dans de nombreux formats différents.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Mécaniquement, un fait (nom, auteur, prix, attribut) qui apparaît dans plusieurs formats cohérents a plus de chances d’être retenu comme fiable qu’un fait isolé dans un seul gabarit. Le brevet décrit un seuil de corroboration : un tuple vu par un seul pattern peut être écarté. Côté actionnable : gardez des gabarits de pages réguliers et prévisibles (même séquence « libellé / valeur » d’une fiche à l’autre), et assurez la cohérence de vos données clés d’une page à l’autre et d’un endroit du web à l’autre. Un format stable aide à extraire vos informations, et une info répétée de façon cohérente aide à les valider. À noter que le brevet est pensé pour du texte brut, donc ça ne remplace pas les données structurées, ça les complète. Je ne vais pas non plus vous inventer un impact chiffré : il n’y en a pas dans le texte.
Exemple : Vous gérez un annuaire ou un catalogue : si chaque fiche suit le même schéma (« Auteur : X – Éditeur : Y ») et que ces infos se retrouvent à l’identique sur d’autres sources, elles sont faciles à extraire et à recouper. Si vos fiches changent de format selon les pages et se contredisent entre elles, vous cassez la corroboration.
Thèmes : Intention de recherche, Embeddings, Entités et sémantique, Indexation · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Representative document selection for a set of duplicate documents
US-8868559-B2 · déposé le 30 août 2012, délivré le 21 octobre 2014
Inventeurs : Daniel Dulitz, Alexandre A. Verstak, Sanjay Ghemawat et 1 autre
Continuation du brevet US-8260781-B2
Ce brevet décrit comment Google gère les contenus en double au moment du crawl : il regroupe les pages quasi identiques (via une empreinte, un « fingerprint », sorte de signature du contenu), puis n’en garde qu’une seule dans l’index. Le choix du représentant ne dépend pas de l’ordre de découverte mais d’un score indépendant de la requête (type PageRank, c’est-à-dire une valeur d’importance calculée en amont). Ce qui compte pour nous : dans un cluster de doublons, vous n’êtes pas là pour partager le gâteau, un seul survit. Et le texte d’ancre des liens pointant vers les copies est rattaché à la page retenue. À noter que c’est un brevet, pas une confirmation de ce qui tourne aujourd’hui, donc à prendre avec l’esprit critique habituel.
Des documents dupliqués, partageant le même contenu, sont identifiés par un système de robot d’indexation Web. Lors de la réception d’un document nouvellement exploré, un ensemble de documents précédemment explorés, le cas échéant, partageant le même contenu que le document nouvellement exploré est identifié.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Si vous laissez coexister plusieurs URL au contenu identique ou quasi identique (paramètres, variantes http/https, www ou pas, versions imprimables, contenus syndiqués), vous laissez Google choisir à votre place, et le choix se fait à l’importance, pas à la préférence. Le brevet prévoit un seuil : un nouveau venu ne remplace le représentant en place que s’il est nettement meilleur, donc un canonical instable ou ambigu peut vous laisser sur la mauvaise URL. Impact direct : l’URL indexée n’est peut-être pas celle que vous voulez. Impact indirect : les ancres et les signaux de liens des doublons sont agrégés sur le représentant, donc consolider (redirections 301, canonicals cohérents, maillage interne qui pointe toujours vers la version cible) évite de diluer et de laisser le hasard trancher. Pertinent aussi côté GEO : une seule version propre à citer vaut mieux que cinq copies concurrentes.
Exemple : Vous avez une fiche produit accessible en trois URL (avec et sans paramètre de tri, plus une version syndiquée chez un partenaire) : si la version partenaire a plus d’autorité, c’est elle qui peut devenir le représentant et récupérer les ancres. Redirigez et canonicalisez vers votre URL, et faites pointer tous vos liens internes dessus, pour que le cluster se résolve en votre faveur.
Thèmes : Contenu dupliqué, Indexation, Crawl, Maillage interne · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Changing a rank of a document by applying a rank transition function
US-8924380-B1 · déposé le 13 août 2012, délivré le 30 décembre 2014
Inventeur : Ross Koningstein
Continuation du brevet US-8244722-B1
Ce brevet décrit un Google qui ne fait pas passer un document de son rang A à son rang B d’un coup, mais via une fonction de transition (amortie, ou « initialement inverse », donc qui commence par aller dans le mauvais sens). Pendant cette période, les facteurs de ranking du document n’ont pas bougé, et le moteur observe si le webmaster réagit quand même. Si oui, c’est un indice de manipulation, et le spam peut être désigné sur le document, le site, le domaine, un lien ou une page qui le cite. Pour vous, ça ne donne pas une technique à appliquer, mais ça change la lecture des variations de positions : un mouvement n’est pas forcément un verdict, et la réaction qu’on y oppose peut devenir un signal. C’est un levier indirect, mais réel, sur la discipline de pilotage.
Une telle manipulation des résultats de recherche dégrade la qualité des résultats de recherche fournis par les moteurs de recherche existants.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Face à une variation de position, ne touchez pas à tout dans la foulée : un rang peut osciller (parfois à l’inverse de ce qu’on attend) sans qu’il y ait de changement de fond. Si vous retouchez liens, ancres ou contenu à chaque soubresaut, vous produisez exactement le comportement réactif que le brevet décrit comme suspect. Isolez les changements, laissez passer la période de stabilisation, puis analysez. À noter : le brevet reste théorique et rien ne prouve ici qu’il soit appliqué tel quel, donc on garde l’esprit critique.
Exemple : Votre page passe de la position 4 à 9 après une modif, puis remonte à 6 quelques jours plus tard. Plutôt que de empiler de nouveaux liens ou de réécrire le contenu en panique dès le premier recul, vous attendez, vous suivez la courbe sur plusieurs semaines et vous ne jugez l’effet qu’une fois la position stabilisée.
Thèmes : Positionnement, Fraîcheur du contenu, Spam, Intention de recherche · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Site quality score
US-9031929-B1 · déposé le 27 juin 2012, délivré le 12 mai 2015
Inventeurs : April R. Lehman et Navneet Panda
Prolongé par la continuation US-9760641-B1 (12 septembre 2017)
Ce brevet décrit un score de qualité calculé au niveau du site entier, à partir de deux comptages de requêtes uniques. Le premier compte les requêtes qui visent explicitement le site (nom de marque, alias, opérateur site:, requête jugée navigationnelle). Le second compte les requêtes qui ont fini par un clic sur une page du site. Le score est un ratio entre les deux, avec un seuil soustrait au numérateur et un dénominateur amorti par une puissance comprise entre 0 et 1. Il sert à classer les sites les uns par rapport aux autres, et il entre aussi dans le calcul du score de chaque page. Autrement dit, être cherché pour de bon pèse plus que simplement apparaître au passage. Ça valide noir sur blanc une intuition que beaucoup de SEO ont déjà : la marque est un signal de qualité, pas un simple bonus.
Cette spécification décrit comment un système peut déterminer un score pour un site, par exemple un site web ou une autre collection de ressources de données, tel qu’il est vu par un moteur de recherche, qui représente une mesure de la qualité du site. Le score est déterminé à partir de quantités indiquant des actions d’utilisateurs consistant à rechercher et à préférer des sites particuliers et les ressources trouvées dans des sites particuliers.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Un site qui récolte des clics sur plein de requêtes génériques mais que personne ne cherche par son nom est déséquilibré dans ce modèle : le dénominateur grossit, le numérateur reste faible. Le levier stratégique est donc de faire grossir la demande de marque (requêtes avec le nom du site, ses alias, ses variantes), pas seulement le trafic non-brand. À noter que l’amortissement par la puissance fait que le trafic générique n’est pas pénalisé de façon linéaire, mais il dilue quand même le ratio. L’impact est direct (le score de site influence le classement entre sites) ET indirect (il alimente le score de chaque ressource du site). Reste à garder l’esprit critique : le brevet ne donne aucune valeur de score cible, et rien ne dit à quel point ce signal pèse aujourd’hui face aux autres.
Exemple : Deux sites de recettes se partagent le même volume de clics organiques. Le premier est souvent cherché par son nom (« nomdusite gratin dauphinois », alias, requêtes navigationnelles), le second n’existe que via des requêtes anonymes de longue traîne. Le premier aura un numérateur plus fort pour un dénominateur comparable, donc un meilleur score de site. Pour le second, mieux vaut investir dans la notoriété de marque (newsletter, présence récurrente, contenus qui donnent envie de revenir) plutôt que dans une énième page de longue traîne.
Thèmes : Expérience utilisateur, Positionnement, Analytics · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Classifying sites as low quality sites
US-9002832-B1 · déposé le 4 juin 2012, délivré le 7 avril 2015
Inventeurs : Rajan Patel, Zhihuan Qiu et Chung Tin Kwok
Ce brevet décrit un mécanisme de rétrogradation (démotion) d’un site entier, et le critère n’est pas son contenu : c’est la qualité des pages qui font des liens vers lui. Pour faire simple, Google note chaque page qui pointe vers vous, les range dans des paniers (« vital », « good », « bad » dans l’exemple), compte les paniers, calcule un ratio pondéré, et si ce ratio passe sous un seuil, le site est classé « low quality » puis son score de ranking est réduit. Mécaniquement, ça veut dire que le profil de liens se juge en distribution, pas en volume. Et ça arrive avec un filtre de diversité (liens de navigation/boilerplate écartés, pages d’un même site dédoublonnées) : empiler 500 liens du même endroit ne change presque rien. Attention, c’est un brevet : rien ne dit que c’est appliqué tel quel aujourd’hui (et les vérifications avant impact sur le ranking sont mentionnées).
Un système de recherche peut déterminer un score de qualité de lien pour un site en utilisant une distribution de scores de qualité de ressources des ressources reliant au site. Le système de recherche peut classer le site comme un site de faible qualité si le score de qualité de lien est inférieur à un score seuil.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Auditez votre profil de liens par niveau de qualité des sources, pas par nombre. Un lien venant d’une source forte pèse plus (pondération plus haute pour les pages « vital »), alors qu’une masse de liens faibles tire le ratio vers le bas, jusqu’au seuil de démotion. Cherchez la diversité : des domaines, des contextes et des thématiques différents, car les liens d’un même site ou d’un même contexte de contenu sont réduits à un ou quelques représentants. Les liens en navigation, footer ou sidebar (boilerplate) sont écartés du calcul : ne comptez pas dessus. Côté désaveu et netlinking, le bon réflexe est donc de savoir quelle part de votre profil est « mauvaise », pas combien de liens vous avez.
Exemple : Un site a 300 liens, dont 280 viennent de pages d’annuaires et de réseaux de blogs du même réseau (donc dédoublonnés à un ou quelques représentants) et 5 de médias solides. Le ratio pondéré ne décolle pas, et le risque est de passer sous le seuil. Mieux vaut 15 liens de sources variées et pertinentes, car c’est la distribution qui pèse, pas le volume brut.
Thèmes : Backlinks, Spam, Positionnement, Qualité du contenu · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
System and method for determining similar topics
US-8458197-B1 · déposé le 31 janvier 2012, délivré le 4 juin 2013
Inventeur : Michael Jeffrey Procopio
Ce brevet décrit un moteur qui juge que deux sujets sont proches non pas parce que leurs textes se ressemblent, mais parce que les mêmes personnes s’y retrouvent, avec une autorité et un intérêt comparables. Pour faire simple, chaque topic devient une « signature » (un vecteur : une liste de valeurs, une par utilisateur), et on compare ces signatures par similarité cosinus. À noter que le brevet parle d’utilisateurs, d’autorité et d’intérêt, sans jamais dire que cela alimente le ranking web : on est sur du regroupement de topics et de la recommandation. Il est utile pour comprendre comment une proximité thématique peut se construire sur les personnes, pas sur les mots. Le levier direct reste ténu et je ne vais pas vous vendre autre chose.
De nombreux utilisateurs différents peuvent interagir avec des informations et des données stockées dans des bases de données. Les utilisateurs peuvent, par exemple, interagir avec un ou plusieurs documents comprenant du contenu lié à un ou plusieurs sujets. Il peut être souhaitable de déterminer et/ou d’identifier des sujets similaires ou liés à un sujet donné.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir, c’est que la proximité entre deux sujets peut dépendre de qui s’y rattache, pas seulement du vocabulaire. Pour vous, l’impact est indirect : une marque ou un auteur identifié comme autorité sur un sujet peut contribuer à rapprocher ce sujet de ses voisins. Cela plaide pour une cohérence thématique assumée (mêmes auteurs ou entités sur un cluster de sujets liés) plutôt qu’un éparpillement. Par prudence : le brevet ne dit pas que Google applique cela au classement des pages, donc c’est une grille de lecture, pas une règle à appliquer à la lettre.
Exemple : Un site dont les mêmes experts signent et sont reconnus à la fois sur « SEO technique » et sur « logs serveur » envoie un signal de proximité entre ces deux sujets. À l’inverse, des auteurs différents sur chaque sujet, sans lien entre eux, brouillent ce rapprochement.
Thèmes : Embeddings, Entités et sémantique, Intention de recherche, Knowledge Graph · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Ranking documents based on user behavior and/or feature data
US-9305099-B1 · déposé le 10 janvier 2012, délivré le 5 avril 2016
Inventeurs : Jeffrey A. Dean, Corin Anderson et Alexis Battle
Prolongé par la continuation US-10152520-B1 (11 décembre 2018)
Voici le fameux brevet du « reasonable surfer » (l’internaute raisonnable). L’idée : tous les liens ne se valent pas, et Google estime la probabilité qu’un lien soit réellement cliqué pour décider du poids qu’il transmet. Il l’apprend en comparant les caractéristiques des liens cliqués avec celles des liens ignorés, à partir du comportement des utilisateurs. Pour un SEO, ça change la lecture d’un lien : ce n’est pas le nombre qui compte, c’est la probabilité qu’on le suive. À noter qu’un brevet décrit un mécanisme possible, pas la preuve de son usage tel quel aujourd’hui. Mais la logique est assez structurante pour guider vos décisions de netlinking et de maillage.
Le World Wide Web (« web ») contient une vaste quantité d’informations. Localiser une portion désirée des informations, cependant, peut être difficile. Ce problème est aggravé du fait que la quantité d’informations sur le web et le nombre de nouveaux utilisateurs inexpérimentés dans la recherche sur le web augmentent rapidement.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Pour le netlinking comme pour le maillage interne, arrêtez de compter les liens et évaluez leur probabilité de clic. Le brevet liste les signaux : position dans la page (corps de texte plutôt que footer ou liste noyée), taille et couleur de police, lien en image ou en texte, anchor text et contexte autour, adéquation thématique entre la page source et l’ancre, lien vers une URL de redirection. Concrètement, un lien éditorial, visible et pertinent dans le contenu principal pèse plus qu’un lien de pied de page, de mentions légales ou d’encart pub. Impact direct : la qualité de l’emplacement d’un backlink. Impact indirect : un lien qui ne se clique jamais risque de ne rien transmettre, donc vos liens internes devraient aussi servir l’utilisateur, pas seulement le crawl. Soyez nuancé : ce modèle ne dit pas que les liens « faibles » sont toxiques, juste qu’ils sont sous-pondérés.
Exemple : Entre deux backlinks de même domaine, celui placé dans le premier tiers d’un article sur votre thématique, avec une ancre naturelle et un contexte pertinent, vaut mécaniquement plus qu’un lien dans une liste de partenaires en pied de page. De même, sur votre site, un lien contextuel vers votre page stratégique dans le corps d’un article aura plus de poids qu’un lien noyé dans un méga-menu.
Thèmes : Positionnement, Backlinks, Expérience utilisateur, Intention de recherche · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Determining quality of linked documents
US-8825645-B1 · déposé le 6 janvier 2012, délivré le 2 septembre 2014
Inventeurs : Krishna Bharat, Amit Singhal et Paul Haahr
Continuation du brevet US-8176056-B1
Ce brevet décrit un PageRank « corrigé » : avant de compter les liens entrants, Google regroupe les documents qui se ressemblent trop (même hôte, IP proches, graphe de liens, trafic) en ensembles affiliés. Ensuite, au lieu d’additionner tous les liens venant d’un même ensemble, il ne retient que la contribution la plus forte (un opérateur « max »). Pour faire simple : 50 liens depuis 50 pages d’un même propriétaire, mécaniquement, ça ne vaut pas 50 votes. Ça en vaut un. Les votes se comptent par entité indépendante, pas par URL. Reste à noter que c’est un brevet et que rien ne dit comment ça tourne aujourd’hui, mais la logique est cohérente avec ce qu’on observe sur le terrain.
Un composant de classement classe des documents, tels que des pages web ou des sites web, afin d’obtenir un score de classement qui définit un jugement de qualité du document. Le score de classement d’un document particulier est basé sur le score de classement des documents qui y renvoient et basé sur l’affiliation parmi les documents.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Arrêtez de raisonner en volume de liens et raisonnez en diversité de sources réellement indépendantes. Les liens sitewide, les réseaux de sites sur la même IP ou le même hébergeur, les maillages entre vos propres domaines, et les multiples liens d’un même site vers vous se retrouvent écrasés en un seul signal : le meilleur. Côté audit, regardez le nombre de domaines/entités distincts qui pointent vers vous, pas le total de backlinks. Côté netlinking, un deuxième lien depuis un site déjà acquis apporte peu. Un lien depuis un nouvel écosystème apporte beaucoup plus. À noter aussi que la contribution est divisée par le nombre de liens sortants de la page source : une page qui n’envoie que quelques liens pèse plus par lien qu’une page-annuaire.
Exemple : Vous avez 40 liens depuis le blog d’un partenaire (même hôte, même IP) et 4 liens depuis 4 sites de médias sans lien entre eux. Dans la logique du brevet, les 40 liens se réduisent à la contribution du meilleur d’entre eux, alors que les 4 sites indépendants comptent chacun. Pour votre prochain budget de netlinking, mieux vaut viser 4 nouveaux domaines sans lien entre eux qu’un 41e lien sur le blog du partenaire.
Thèmes : Positionnement, Backlinks, Contenu dupliqué, Intention de recherche · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Brevets déposés en 2011
Anchor tag indexing in a web crawler system
US-9305091-B2 · déposé le 18 novembre 2011, délivré le 5 avril 2016
Inventeurs : Huican Zhu, Jeffrey Dean, Sanjay Ghemawat et 2 autres
Continuation du brevet US-8484548-B1
Prolongé par la continuation US-10210256-B2 (19 février 2019)
Ce brevet décrit comment le crawler de Google récupère le texte d’ancre (et le texte situé à une distance prédéfinie du lien) dans les pages sources, puis le rattache à la page cible dans l’index. Les termes qui viennent de l’extérieur deviennent donc des termes cherchables pour la page visée. Le brevet le dit noir sur blanc : une page qui vous cite peut vous décrire mieux que vous ne le faites vous-même. Rien de neuf sur le principe (l’ancre compte, on le sait), mais le détail du contexte « à proximité du lien » et la possibilité d’indexer avant même d’avoir crawlé la cible donnent de la substance à un levier qu’on traite souvent trop grossièrement. Le vocabulaire qui vous entoure sur le web participe à votre pertinence, que vous le contrôliez ou non.
Cependant, à mesure que le nombre de documents sur l’Internet croît, il faut des périodes de temps de plus en plus longues entre le moment où une page est explorée par un robot et le moment où elle peut être indexée et rendue disponible à un moteur de recherche. En outre, il faut des périodes de temps de plus en plus longues pour remplacer ou mettre à jour une page une fois qu’elle a été indexée.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ne raisonnez plus seulement en « ancre exacte ou pas ». Regardez aussi la phrase autour du lien, puisque le texte situé à une certaine distance du lien est lui aussi capté et associé à votre page. Pour vos liens entrants, qu’ils soient obtenus par netlinking ou par relations presse, le contexte éditorial compte autant que l’ancre : une mention bien décrite dans son paragraphe apporte des termes pertinents à votre cible. C’est aussi stratégique pour les ressources pauvres en texte (images, vidéos, outils, fichiers), qui sont décrites presque uniquement par ceux qui les citent. À noter que le brevet lie aussi la carte des liens au calcul d’un PageRank (une métrique de pertinence indépendante de la requête) : les liens ont donc un impact direct sur les termes indexés ET indirect sur l’autorité. Gardez de la nuance : le brevet décrit l’architecture d’indexation, pas le poids relatif de ces signaux au classement.
Exemple : Vous publiez un outil gratuit de calcul de budget crawl, avec une page très légère en texte. Si un article de blog le cite avec « ce calculateur de budget de crawl pour sites e-commerce », ces termes peuvent être indexés pour votre page. Vous pouvez donc fournir aux partenaires une courte description contextuelle et pas seulement une URL à coller.
Thèmes : Crawl, Indexation, Backlinks, Maillage interne · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Information extraction from a database
US-8332371-B1 · déposé le 23 septembre 2011, délivré le 11 décembre 2012
Inventeur : Sergey Brin
Continuation du brevet US-8037065-B1
Prolongé par la continuation US-8589387-B1 (19 novembre 2013)
Ce brevet décrit une boucle d’extraction qui part de quelques exemples connus (par exemple un couple auteur/titre), repère comment ils apparaissent dans les pages, en déduit un gabarit, puis s’en sert pour récupérer de nouveaux couples. Cette version ajoute un garde-fou : le gabarit n’est utilisé que s’il est assez spécifique, soit par la longueur des chaînes qui le délimitent, soit par le nombre d’occurrences qui le confirment. C’est un mécanisme d’extraction de faits à partir du web, pas un signal de ranking. Il ne dit rien sur la façon dont Google classe vos pages. Il éclaire en revanche, de manière indirecte, comment des relations (entités, attributs, listes) peuvent être aspirées depuis des contenus structurés de façon répétitive. Utile pour comprendre, mince pour agir.
Des techniques pour extraire des informations d’une base de données sont fournies. Une base de données telle que le Web est recherchée pour des occurrences de tuples d’informations. Les occurrences des tuples d’informations qui ont été trouvées dans la base de données sont analysées afin d’identifier un schéma selon lequel les tuples d’informations ont été stockés.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Des informations présentées de façon régulière et cohérente, avec le même ordre et les mêmes délimiteurs d’une page à l’autre, sont plus faciles à repérer et à généraliser. À noter que le seuil de spécificité joue dans les deux sens : un gabarit appuyé sur peu d’occurrences est écarté, donc la répétition de la même structure sur plusieurs pages (les vôtres et celles d’autres sites) renforce la chance qu’une relation soit retenue. Le matching se fait sur des chaînes littérales, pas sur du sens abstrait : la cohérence de la formulation compte. Le levier est indirect et reste une hypothèse de lecture. Le brevet ne dit pas que Google l’applique ainsi à votre site, ni que c’est lié au ranking.
Exemple : Sur un site d’annuaire ou de fiches produits, gardez partout le même schéma pour afficher les attributs (« Marque : X – Modèle : Y », toujours dans le même ordre, avec les mêmes libellés). Ce gabarit régulier est celui qu’un système d’induction de patterns repère le plus facilement, ce qui facilite l’extraction fiable de vos couples marque/modèle.
Thèmes : Intention de recherche, Embeddings, Questions-réponses, Entités et sémantique · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Document scoring based on document content update
US-8549014-B2 · déposé le 14 septembre 2011, délivré le 1er octobre 2013
Inventeurs : Anurag Acharya, Jeffrey Dean, Paul Haahr et 4 autres
Division du brevet US-8112426-B2
Ce brevet décrit un score qui ne regarde pas seulement les liens qui pointent vers une page, mais comment leurs ancres (le texte cliquable du lien) évoluent dans le temps. Si les ancres se multiplient, restent cohérentes avec le contenu de la page et sont récentes, la page gagne du terrain face à des documents plus statiques. À noter que si l’ancre ne colle plus au sujet de la page, elle est ignorée dans le calcul. Ce n’est pas un levier qu’on actionne d’un clic (on ne contrôle pas les ancres des autres), mais ça change la façon de penser le netlinking : la dynamique compte autant que le stock. Reste une nuance : c’est un brevet, pas la preuve d’un facteur en production, et son poids réel face aux autres signaux reste inconnu.
De plus, les documents « obsolètes » (c’est-à-dire les documents qui n’ont pas été mis à jour pendant une période de temps et qui contiennent donc des données obsolètes) peuvent être classés plus haut que les documents « plus frais » (c’est-à-dire les documents qui ont été mis à jour plus récemment et qui contiennent donc des données plus récentes). Dans certains contextes particuliers, les documents obsolètes mieux classés dégradent les résultats de recherche.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Pensez le netlinking comme une trajectoire, pas comme un stock. Visez des liens dont l’ancre décrit réellement le contenu, acquis de façon régulière et récente, plutôt que des pics ponctuels puis le silence. Quand vous remaniez en profondeur le sujet d’une page, les anciennes ancres deviennent du poids mort (elles peuvent être écartées du score), donc mieux vaut créer une nouvelle URL ou relancer une vraie dynamique de liens sur le nouveau sujet. Et pour les pages piliers, entretenez-les : un contenu vivant donne des raisons de le citer à nouveau, avec des ancres fraîches (impact direct sur le score, et indirect sur la visibilité).
Exemple : Vous avez un guide sur l’audit de logs, très lié il y a trois ans avec des ancres du type « analyse de logs SEO ». Si vous le mettez à jour et le republiez avec de nouvelles données, il a plus de chances de recevoir de nouveaux liens aux ancres cohérentes, et c’est cette accélération (plus que le vieux stock) que le brevet récompense. À l’inverse, si vous transformez cette page en page produit sans rapport, les anciennes ancres seront considérées comme déconnectées et ne vous aideront plus.
Thèmes : Backlinks, Fraîcheur du contenu, Positionnement, Entités et sémantique · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Agent rank
US-9002856-B2 · déposé le 5 août 2011, délivré le 7 avril 2015
Inventeurs : David Minogue et Paul A. Tucker
Continuation du brevet US-8296293-B2
Agent Rank, c’est l’idée de noter les auteurs, éditeurs et relecteurs (les « agents ») plutôt que seulement les pages. Chaque contenu est signé numériquement, la signature rattache le contenu à un agent, et la réputation de l’agent se propage ensuite façon PageRank sur le graphe de références. Pour faire simple : un contenu signé par un agent réputé passe devant un contenu non signé ou signé par un agent moins crédible. Attention, c’est un brevet, pas une preuve que Google l’applique tel quel aujourd’hui. Mais il pose noir sur blanc une logique (réputation d’auteur, par sujet, difficile à gagner et facile à perdre) qui colle pile à ce qu’on appelle E-E-A-T. Pas un levier direct, mais un cadre de raisonnement solide.
En général, toutefois, il est difficile de corréler le contenu sur une source d’information avec les agents responsables de la création ou de la publication de ce contenu. Par exemple, un auteur individuel peut contribuer du contenu à plusieurs sources d’information, le contenu au sein d’une seule source d’information peut provenir de plusieurs agents, ou la propriété et le contrôle des sources d’information peuvent changer au fil du temps.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir c’est que la réputation peut se jouer au niveau de l’entité auteur/éditeur, pas seulement de l’URL. Mécaniquement, ça pousse à rendre l’attribution non ambiguë : auteurs identifiés, rôles clairs (auteur, relecteur, éditeur), cohérence thématique de ce qu’ils signent, et mentions venant d’agents eux-mêmes réputés. Le brevet décrit une réputation contextuelle (forte sur un sujet, faible sur un autre) : mieux vaut donc ne pas faire signer à un même expert tout et n’importe quoi. Et comme le score est difficile à monter et facile à faire chuter, endosser du contenu faible a un coût, direct ET indirect. À noter aussi : le contenu non signé peut être attribué au propriétaire du site, donc la réputation du domaine reste le filet de sécurité.
Exemple : Sur un site santé, plutôt qu’un « Rédaction » générique, vous affichez un auteur nommé avec sa fiche, un relecteur identifié, et vous gardez chaque expert sur son périmètre. Vous obtenez une attribution claire et un historique thématique cohérent, exactement ce qu’un modèle de réputation d’agent pourrait exploiter.
Thèmes : Autorité, Knowledge Graph, Entités et sémantique, Données structurées · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Representative document selection for sets of duplicate documents in a web crawler system
US-8260781-B2 · déposé le 19 juillet 2011, délivré le 4 septembre 2012
Inventeurs : Daniel Dulitz, Alexandre A. Verstak, Sanjay Ghemawat et 1 autre
Continuation du brevet US-7984054-B2
Prolongé par la continuation US-8868559-B2 (21 octobre 2014)
Ce brevet décrit comment Google gère les doublons au moment de l’indexation. Les documents au contenu identique sont regroupés grâce à une empreinte de longueur fixe (une sorte de « code-barres » du contenu). Un seul représentant est choisi dans chaque groupe, et c’est lui seul qui entre dans l’index. Le critère de choix est un score indépendant de la requête, décrit comme un indicateur d’importance ou de popularité, proche d’un PageRank. Ce qu’il faut retenir : pour du contenu strictement identique, vous ne jouez pas à armes égales avec vos copies. Une seule version survit, et ce n’est pas forcément la vôtre. Pour rester nuancé, le brevet ne dit rien des quasi-doublons ni des signaux précis qui composent ce score. Le levier est donc réel, mais il reste indirect.
Des documents en double sont détectés dans un système d’exploration web. Lors de la réception d’un document nouvellement exploré, un ensemble de documents, le cas échéant, partageant le même contenu que le document nouvellement exploré est identifié.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Si vous avez plusieurs URL au contenu strictement identique (paramètres, versions http/https, www ou non, pages syndiquées, miroirs), vous laissez Google choisir le représentant à partir d’un score d’importance. Les autres copies sont exclues de l’index, et de tout traitement aval. Le plus utile est donc de consolider vous-même : redirections 301, canonicals cohérents, liens internes et externes orientés vers l’URL que vous voulez voir indexée. Ainsi, c’est elle qui accumule le score. Cela réduit aussi le gaspillage de crawl, puisque les copies exclues n’apportent rien. Dans les faits, un canonical n’est qu’un signal parmi d’autres, il faut donc aligner tous les autres signaux dans le même sens.
Exemple : Une fiche produit est accessible via trois URL (avec et sans paramètre de tracking, plus une version dans une catégorie), toutes au contenu identique. Si les liens internes et les backlinks se dispersent entre elles, Google peut retenir celle que vous ne vouliez pas. En redirigeant et en pointant tous les liens vers l’URL canonique, vous concentrez le score sur la version que vous voulez voir ranker.
Thèmes : Crawl, Indexation, Contenu dupliqué, Positionnement · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Document scoring based on document content update
US-8527524-B2 · déposé le 30 juin 2011, délivré le 3 septembre 2013
Inventeurs : Anurag Acharya, Jeffrey Dean, Paul Haahr et 4 autres
Division du brevet US-8112426-B2
Ce brevet décrit un signal d’historique : Google compare les thématiques d’une page à deux moments différents et regarde comment leur nombre évolue. Ce n’est pas la simple fraîcheur (« la page a changé ») qui compte, c’est la nature du changement. Un pic soudain de sujets, ou la disparition d’un sujet qui était là avant, peut classer le page comme suspecte (spam), et le score sert ensuite de modificateur de la pertinence par rapport à la requête. À noter que c’est un brevet, donc rien ne prouve que ce soit appliqué tel quel aujourd’hui. Mais la logique est cohérente avec ce qu’on observe sur les sites rachetés ou les pages « recyclées », et elle donne un garde-fou concret pour vos refontes éditoriales. Une page qui bouge brutalement de thématique prend un risque.
De même, les documents « obsolètes » (c’est-à-dire les documents qui n’ont pas été mis à jour pendant une période de temps et contiennent donc des données obsolètes) peuvent être classés plus haut que les documents « plus frais » (c’est-à-dire les documents qui ont été mis à jour plus récemment et contiennent donc des données plus récentes). Dans certains contextes particuliers, les documents obsolètes mieux classés dégradent les résultats de recherche.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Faites évoluer vos contenus de façon cohérente avec leur sujet d’origine : enrichissez, mettez à jour, approfondissez, plutôt que d’ajouter d’un coup une série de thématiques éloignées ou de retirer un angle qui faisait la pertinence de la page. Si un changement de cap est nécessaire, créez une nouvelle URL plutôt que de transformer l’ancienne. Gardez aussi un historique de vos modifications importantes pour pouvoir relier une variation de visibilité à un changement de profil thématique (impact direct sur la page, mais aussi indirect sur le site si le schéma se répète).
Exemple : Un article de blog bien positionné sur « audit SEO technique » est remanié pour ajouter des sections sur le crypto, les assurances et le tourisme afin de capter du trafic, tout en supprimant la partie sur le crawl. Le nombre de thématiques explose et un sujet d’origine disparaît : c’est exactement le profil que le brevet associe à une manipulation, avec un risque de rétrogradation. Mieux vaut approfondir l’audit et publier le reste sur des pages dédiées.
Thèmes : Positionnement, Spam, Fraîcheur du contenu, Qualité du contenu · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Document scoring based on document content update
US-8234273-B2 · déposé le 30 juin 2011, délivré le 31 juillet 2012
Inventeurs : Anurag Acharya, Jeffrey Dean, Paul Haahr et 4 autres
Division du brevet US-8112426-B2
Ce brevet décrit une fraîcheur calculée de façon relative : Google ne regarde pas seulement la date de mise à jour d’une page, il la compare à la date moyenne de changement des autres résultats qui répondent à la même requête. Votre page est donc jugée par rapport à ses concurrentes directes, pas dans l’absolu. Le signal peut aussi servir de modificateur sur le score de pertinence classique, ou parfois d’ordre de tri à lui seul. Reste une nuance : c’est un brevet, rien ne dit comment ni à quel point c’est appliqué aujourd’hui, et le texte précise que ça joue « quand c’est approprié », donc surtout sur les requêtes où l’actualité de l’information compte. Le levier est réel, mais il dépend de la requête.
De plus, les documents « périmés » (c.-à-d., les documents qui n’ont pas été mis à jour pendant une certaine période et qui, par conséquent, contiennent des données périmées) peuvent être classés plus haut que les documents « plus frais » (c.-à-d., les documents qui ont été mis à jour plus récemment et qui, par conséquent, contiennent des données plus récentes). Dans certains contextes particuliers, les documents périmés mieux classés dégradent les résultats de recherche.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Évaluez la fraîcheur requête par requête, en vous comparant au cohorte de résultats en place, pas à un calendrier de mise à jour universel. Sur les requêtes où l’information évolue, une page nettement plus entretenue que ses voisines se démarque, et une page nettement plus ancienne se fait distancer. Le brevet détecte les changements en surveillant les termes les plus fréquents du document (stop words exclus), donc les vrais changements de fond comptent, pas le toilettage cosmétique. Modifier une date ou un bandeau sans toucher au contenu porteur de sens, c’est stratégiquement inutile. À l’inverse, sur les sujets intemporels, courir après la mise à jour est du temps perdu.
Exemple : Sur une requête comparative où tous les concurrents n’ont pas bougé depuis longtemps, une mise à jour réelle de votre page (données, sections, termes clés du sujet) vous place en décalage positif par rapport à la moyenne du top. Sur un guide évergreen, retoucher trois virgules chaque mois n’apporte rien : le changement doit porter sur le vocabulaire central de la page.
Thèmes : Fraîcheur du contenu, Positionnement, Intention de recherche, Qualité du contenu · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Agent rank
US-8296293-B2 · déposé le 11 mai 2011, délivré le 23 octobre 2012
Inventeurs : David Minogue et Paul A. Tucker
Continuation du brevet US-8224826-B2
Prolongé par la continuation US-9002856-B2 (7 avril 2015)
Agent Rank, c’est l’idée de rattacher la réputation à un agent identifiable (auteur, éditeur, relecteur, publisher) plutôt qu’à une simple URL. Le lien passe par une signature numérique posée sur le contenu, parfois sur un simple fragment de page (texte, image, commentaire, pub). Le score de l’agent est calculé façon PageRank, sur un graphe d’agents et de contenus qui se citent, puis il alimente un score de qualité indépendant de la requête. Le détail qui compte : la signature peut être portable (la réputation suit l’agent d’un site à l’autre) ou fixée à un site, une page ou une URL. Pour faire simple, c’est le E-E-A-T version cryptographique. À noter que rien ne prouve qu’un brevet de ce type soit appliqué tel quel : on lit une logique, pas une confirmation d’usage.
En général, cependant, il est difficile de corréler le contenu d’une source d’information avec les agents responsables de la création ou de la publication de ce contenu. Par exemple, un auteur individuel peut contribuer du contenu à plusieurs sources d’information, le contenu au sein d’une seule source d’information peut provenir de plusieurs agents, ou la propriété et le contrôle des sources d’information peuvent changer au fil du temps.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir, c’est que l’attribution claire devient un actif stratégique : des auteurs et relecteurs identifiables, cohérents d’une page à l’autre, avec une expertise rattachée à des thématiques précises (le brevet évoque des scores différents selon le rôle et le sujet). Il y a un impact direct ET indirect : direct, si le contenu signé d’un agent réputé est favorisé face à du contenu anonyme ; indirect, parce que les citations venant d’agents bien classés pèsent plus lourd que le volume brut de liens. Pensez aussi à séparer ce que vous assumez (contenu éditorial) de ce qui est tiers (commentaires, pub), puisque la responsabilité peut se découper au niveau du fragment. Et sans signature, le contenu non signé est vraisemblablement rattaché au propriétaire du site : votre réputation de domaine joue donc aussi ce rôle par défaut.
Exemple : Un site santé publie ses articles avec un relecteur médical nommé, présent sur toutes ses pages avec une fiche auteur cohérente et des citations d’autres sources bien établies : l’agent construit une réputation sur le thème « médical », distincte de celle d’un rédacteur lifestyle. À l’inverse, des articles anonymes ou signés « Équipe rédaction » n’accumulent aucune réputation propre.
Thèmes : Autorité, E-E-A-T, Données structurées, Positionnement · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Methods and systems for identifying paraphrases from an index of information items and associated sentence fragments
US-8290963-B1 · déposé le 2 mai 2011, délivré le 16 octobre 2012
Inventeurs : Alexandru Marius Pasca et Peter Szabolcs Dienes
Continuation du brevet US-7937396-B1
Ce brevet décrit comment Google (ou plutôt le système décrit) fabrique un dictionnaire de paraphrases sans les écrire à la main. Le principe : deux fragments de phrases qui pointent vers la même information (une même date, une même entité, un même concept) sont alignés mot à mot. Les mots communs hors stop words servent d’ancre, les mots qui diffèrent deviennent le candidat de paraphrase. Ensuite, on ne garde que les paires qui reviennent assez souvent. Donc : la répétition fait la validation. C’est utile pour comprendre comment un moteur apprend que deux formulations disent la même chose, mais le levier direct pour vous reste ténu (pas de signal de ranking, rien de pilotable).
Différents mots et expressions peuvent être utilisés dans des documents et des requêtes de recherche qui ont la même signification ou une signification similaire. De tels mots et phases peuvent être désignés comme des paraphrases. Les paraphrases identifiées ou connues peuvent être utiles dans la synthèse de documents, la recherche d’information et l’extraction d’information.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir, c’est que mécaniquement, une équivalence entre deux formulations n’entre dans la ressource que si elle apparaît de façon récurrente autour d’un même fait. Pour vous, cela plaide pour deux réflexes : être cohérent et factuel autour d’une entité ou d’un fait (même information, formulée de plusieurs façons naturelles) plutôt que de ressasser une seule tournure, et ne pas vous épuiser à bourrer des synonymes en pensant « couvrir » la requête. Le moteur est censé faire le rapprochement tout seul, à condition que le fait ancré soit clair. À noter que c’est de l’inférence de ma part : le brevet décrit la construction d’une ressource lexicale, pas un critère de classement.
Exemple : Sur une page qui parle d’un événement daté ou d’une entité précise, vous écrivez « a racheté », « a fait l’acquisition de », « est passé sous le contrôle de », selon le contexte éditorial. Inutile de forcer chaque variante dans le même paragraphe : si ces formulations reviennent autour du même fait, c’est exactement le genre de paire qu’un système de ce type apprend à rapprocher.
Thèmes : Embeddings, Entités et sémantique, Questions-réponses, Knowledge Graph · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Methods and systems for identifying paraphrases from an index of information items and associated sentence fragments
US-8280893-B1 · déposé le 2 mai 2011, délivré le 2 octobre 2012
Inventeurs : Alexandru Marius Pasca et Peter Szabolcs Dienes
Continuation du brevet US-7937396-B1
Ce brevet décrit comment Google peut fabriquer tout seul un dictionnaire de paraphrases. Il repère des fragments de phrases rattachés à la même date, la même entité ou le même concept. Il aligne les mots communs, isole les mots qui diffèrent, puis garde la paire seulement si elle revient assez souvent. Au bout, un moteur de recherche reçoit une requête, retrouve les termes équivalents dans cet index et cherche des documents avec ces termes-là. Pour faire simple : la requête exacte n’est pas le seul chemin vers votre page. Le brevet décrit le mécanisme, pas la façon dont Google l’applique aujourd’hui. Le levier est donc indirect, mais il est réel.
Des mots et des expressions différents peuvent être utilisés dans des documents et des requêtes de recherche qui ont la même signification ou une signification similaire. De tels mots et phrases peuvent être appelés paraphrases.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Mécaniquement, une page peut remonter sur une requête dont elle ne contient pas les mots, si Google a appris que votre formulation en est une paraphrase fréquente. Ce qui compte, c’est la pertinence autour de l’entité ou du concept, plus que la répétition du mot-clé exact. Donc vous n’avez pas besoin de dupliquer la même idée sous dix tournures. Couvrez le sujet avec le vocabulaire naturel de votre audience, et variez les formulations là où elles sont réellement utilisées. À noter que le filtre de fréquence joue contre les tournures isolées : une paraphrase rare ou idiosyncratique a peu de chances d’être retenue. Mieux vaut donc s’appuyer sur les formulations courantes que sur des variantes exotiques. Ce qu’il faut retenir, c’est qu’on optimise pour une intention et une entité, pas pour une chaîne de caractères.
Exemple : Vous rédigez une page sur « résilier un abonnement » sans jamais écrire « se désabonner ». Si l’index de paraphrases a associé les deux formulations, une requête avec « se désabonner » peut être étendue aux termes équivalents, et votre page entre dans le jeu. Votre travail consiste à bien couvrir le sujet avec le vocabulaire que vos lecteurs emploient vraiment.
Thèmes : Embeddings, Intention de recherche, Questions-réponses, Query fan-out · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Ranking video articles
US-8189685-B1 · déposé le 31 mars 2011, délivré le 29 mai 2012
Inventeurs : Shahid Choudhry, John Piscitello, Christopher Richard Uhlik et 6 autres
Continuation du brevet US-7933338-B1
Ce brevet décrit un système de recherche vidéo qui classe des « video articles » (des contenus reçus de diffuseurs ou de fournisseurs) avec un score calculé côté serveur. Ce score combine des données propres à la diffusion (plage horaire, notation, estimation de coût fournie par un tiers, actions des utilisateurs) et des métadonnées (nom, sous-titre, texte associé). Soyons honnêtes : il vise d’abord un univers de broadcast, pas YouTube ni le SEO vidéo tel qu’on le pratique tous les jours. Je ne vais donc pas vous vendre un « facteur de ranking confirmé » (ce serait de l’enfumage). Ce qu’il faut retenir, c’est la logique : le classement vidéo ne repose pas que sur le texte, il mêle le contenu, des signaux de qualité et des signaux d’usage.
Cependant, ces applications de recherche ne fournissent aucune indication quant à l’endroit où les termes de recherche sont situés dans les fichiers graphiques ou vidéo. En outre, ces applications de recherche peuvent retourner des résultats de recherche peu fiables, puisqu’il y a relativement peu de données pour classer ou noter les résultats de recherche selon le contenu des fichiers graphiques ou vidéo qui sont pertinents ou utiles pour l’utilisateur pour la requête de recherche et pour localiser les résultats de recherche selon le contenu des fichiers vidéo.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Pour la vidéo, travaillez les deux jambes, sans déséquilibre. D’un côté, des métadonnées propres : titre, sous-titre et texte associé (description, transcription) doivent porter la pertinence. De l’autre, les signaux extérieurs au texte : notations, interactions des utilisateurs, contexte temporel de diffusion ou de publication. Impact direct : le texte autour de la vidéo reste lu pour la classer. Impact indirect : l’engagement et l’évaluation du contenu peuvent peser sur sa position. À noter que le brevet décrit une revendication, pas une confirmation de ce que Google applique sur votre SERP : on garde l’esprit critique et on teste.
Exemple : Vous publiez une vidéo de formation sur une page produit : soignez le titre, un sous-titre explicite et une transcription complète (les métadonnées), puis poussez les signaux d’usage (vues complètes, retours, notes) plutôt que de compter sur le seul texte de la page.
Thèmes : Positionnement, Images et vidéos, Expérience utilisateur, Intention de recherche · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Brevets déposés en 2010
Document scoring based on document inception date
US-8521749-B2 · déposé le 12 octobre 2010, délivré le 27 août 2013
Inventeurs : Matt Cutts, Jeffrey Dean, Paul Haahr et 4 autres
Continuation du brevet US-7840572-B2
Ce brevet décrit un score de classement fondé sur la vitesse à laquelle un document accumule des liens, et non sur le nombre brut de liens ni sur l’âge seul. Concrètement, on divise la quantité de liens (vers ou depuis le document) par le temps écoulé depuis sa « date d’inception ». Cette date peut être la première indexation, la première découverte d’un lien, l’enregistrement du domaine, la première citation ou le moment où le site atteint un seuil de pages. À noter que c’est une continuation : le périmètre est resserré sur ce seul calcul de taux de liens. Un brevet n’est pas une preuve d’usage en production, donc on reste prudent. Mais il éclaire une logique de pertinence temporelle plutôt utile à garder en tête.
De plus, les documents « stales » (c’est-à-dire ces documents qui n’ont pas été mis à jour pendant une période de temps et, ainsi, contiennent des données stales) peuvent être classés plus haut que les documents « plus frais » (c’est-à-dire ces documents qui ont été mis à jour plus récemment et, ainsi, contiennent des données plus récentes). Dans certains contextes particuliers, les documents stales mieux classés dégradent les résultats de recherche.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le rythme d’acquisition de liens compte autant que le stock : un profil de liens se juge aussi sur sa dynamique dans le temps. Un document jeune qui attire des liens régulièrement peut donc ressortir mieux qu’une page ancienne qui a accumulé son capital puis stagné. Sur le plan stratégique, cela pousse à planifier le netlinking dans la durée, avec un flux continu dès le lancement, plutôt qu’en pics ponctuels. Impact direct : le démarrage d’une page ou d’un site pèse. Impact indirect : la date d’inception peut partir de la découverte par le crawler, donc faire indexer et découvrir vite une page évite de laisser filer le chronomètre. Le brevet ne chiffre rien, il n’y a donc pas de seuil à viser, seulement une direction.
Exemple : Deux guides publiés le même mois : le premier récolte quelques liens chaque semaine grâce à des relais réguliers, le second a reçu une grosse vague de liens le premier jour, puis plus rien. Sur ce modèle, le premier affiche un taux moyen de création de liens plus soutenu dans la durée, et c’est lui qui a le plus de chances de passer devant.
Thèmes : Positionnement, Backlinks, Fraîcheur du contenu, Crawl · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Scoring local search results based on location prominence
US-8046371-B2 · déposé le 29 septembre 2010, délivré le 25 octobre 2011
Inventeurs : Brian O’Clair, Daniel Egnor et Lawrence E. Greenfield
Ce brevet décrit un classement local en deux régimes. Si votre fiche est dans la zone visée (une ville citée dans la requête, ou la fenêtre de carte affichée), elle est scorée sur un « facteur de proéminence » qui ignore la distance ET la pertinence vis-à-vis de la requête. Hors zone, on retombe sur de la distance pure. Pour faire simple : dans la zone, c’est la notoriété de l’entreprise qui trie, pas la proximité avec le centre-ville. À noter que c’est la description d’un brevet, pas la preuve que Google l’applique tel quel. Mais l’angle est rare et franchement actionnable pour un SEO local.
Lors de l’attribution de scores aux résultats, un moteur de recherche local peut identifier un emplacement au sein de la zone géographique. Cet emplacement identifié peut être associé à l’emplacement de l’hôtel de ville, du centre-ville ou d’un centre géographique de la zone.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le facteur de proéminence s’appuie sur des signaux off-page liés à l’entreprise, indépendants de la zone et de la requête : document reconnu comme autorité pour l’entreprise, nombre et score des documents qui la mentionnent, volume de documents d’avis, notes, langue des avis, logs d’interactions utilisateurs, données financières, ancienneté. Concrètement, une fois dans la zone, on ne gagne plus avec « je suis plus près », on gagne avec « on parle plus et mieux de moi ». Le travail stratégique, c’est donc la réputation et la visibilité de l’entité business : avis (volume, notes, diversité des plateformes), citations et mentions tierces, un site clairement identifié comme la source officielle, et des signaux d’usage. Autre conséquence : le brevet prévoit des facteurs pondérés, donc le déséquilibre sur un seul levier (beaucoup d’avis mais aucune mention ailleurs) a probablement un effet limité. Impact direct sur le ranking local dans la zone, et indirect sur tout ce qui nourrit la notoriété de la marque.
Exemple : Deux plombiers sont dans la même ville visée par la requête : l’un est à 200 m du centre mais avec peu d’avis et quasi aucune mention externe, l’autre est à 5 km mais ancien, bien noté, cité sur plusieurs sites et avec un site officiel bien identifié. Dans ce modèle, le second peut passer devant, puisque la distance n’entre pas dans son score de proéminence.
Thèmes : SEO local, Positionnement, Autorité, Expérience utilisateur · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Determining user intent from query patterns
US-8868548-B2 · déposé le 22 juillet 2010, délivré le 21 octobre 2014
Inventeur : Yair Kurzion
Ce brevet décrit un système qui repère des termes de reformulation récurrents (les « intent refining query terms »), s’en sert pour deviner l’intention d’une session, puis rebooste ou rétrograde des documents selon ce que les utilisateurs de sessions similaires ont cliqué. Bon, soyons clairs : c’est pas un nouveau facteur de ranking à cocher dans un audit. Mais mécaniquement, ça confirme qu’un classement peut se déformer selon l’intention déduite du parcours, pas seulement selon la requête brute. Votre page est jugée dans le contexte de la session. À noter que le levier est indirect : on ne pilote pas un signal de clic, on travaille la pertinence face à l’intention.
Procédés, systèmes et produits de programme permettant d’identifier l’intention de l’utilisateur à partir de modèles de requêtes comprenant, dans une mise en œuvre, un procédé comprenant l’identification d’une requête actuelle comprenant un terme de requête, et l’obtention de résultats de recherche répondant à la requête actuelle.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir c’est que, pour une même requête, deux intentions différentes peuvent donner deux classements différents, et que le comportement collectif sert de signal de correction. Trois actions concrètes. 1) Repérez les termes de reformulation qui reviennent autour de vos requêtes cibles (via vos propres données de recherche, vos suggestions, vos requêtes associées) et traitez-les comme des intentions distinctes. 2) Alignez chaque page sur une intention claire, plutôt qu’une page fourre-tout qui ne satisfait personne, car un document moins sélectionné sous une intention donnée est mécaniquement rétrogradé. 3) Soignez ce qui fait choisir votre résultat, titre et snippet compris, car le signal repose sur la fréquence de sélection comparée à la population générale. Le brevet précise aussi que l’ajustement dépend d’un niveau de confiance lié au volume de sessions : l’effet joue donc surtout sur des requêtes avec assez de données.
Exemple : Sur une requête ambiguë du type « jaguar », si beaucoup de sessions passent par un terme de reformulation comme « voiture » ou « animal », le système associe cette intention à la session. Votre page auto qui est davantage cliquée dans ces sessions-là est boostée, et une page généraliste qui s’adresse à tout le monde est reléguée. Je vous conseille donc de faire une page par intention, pas une page pour les deux.
Thèmes : Intention de recherche, Expérience utilisateur, Positionnement, Analytics · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Determining quality of linked documents
US-8176056-B1 · déposé le 20 juillet 2010, délivré le 8 mai 2012
Inventeurs : Krishna Bharat, Amit Singhal et Paul Haahr
Continuation du brevet US-7783639-B1
Prolongé par la continuation US-8825645-B1 (2 septembre 2014)
Ce brevet décrit un PageRank qui tient compte de l’affiliation entre les sites qui se lient. Si les liens viennent de documents proches (même hostname, IP similaire, trafic corrélé, structure de graphe), ils ne comptent pas comme des votes indépendants. Dans les faits, un groupe de sites « frères » ne pèse pas plus qu’un seul, alors que des sources réellement indépendantes s’additionnent. C’est une suite de brevet, donc le principe est ancien, mais la règle est ici formalisée noir sur blanc : somme si l’affiliation est faible, maximum si elle est forte. Ce n’est pas une preuve de ce qui tourne aujourd’hui en production, mais le raisonnement est cohérent et il remet en perspective bien des stratégies de netlinking.
Un composant de classement classe des documents, tels que des pages web ou des sites web, afin d’obtenir un score de classement qui définit un jugement de qualité du document. Le score de classement d’un document particulier est basé sur le score de classement des documents qui y renvoient et basé sur une affiliation entre les documents.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Un lien de plus depuis un site déjà affilié à vos autres sources n’ajoute presque rien : seul le meilleur lien du groupe compte. La stratégie utile consiste donc à viser la diversité réelle des sources (hébergeurs, IP, propriétaires, graphes de liens distincts) plutôt que le volume. Les réseaux de sites sur la même infra, les multiples sous-domaines d’un même éditeur ou les PBN mal cloisonnés sont exposés à ce « collapse » : vous payez N liens pour le poids d’un seul. À noter que le poids de chaque lien est aussi dilué par le nombre de liens sortants de la page source, donc une page qui distribue 200 liens donne peu à chacun. Cela vaut pour votre propre maillage : concentrer le jus sur peu de liens bien placés reste plus rentable que l’arrosage.
Exemple : Vous obtenez 10 liens depuis 10 sites d’un même groupe média, hébergés sur la même IP et se citant entre eux : le système peut les traiter comme fortement affiliés et ne retenir que le plus fort. Trois liens depuis des sites vraiment indépendants (hébergement, propriétaire et audience distincts) s’additionnent, eux, et pèsent plus lourd.
Thèmes : Positionnement, Backlinks, Contenu dupliqué, Maillage interne · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Search result plusbox including restricted results
US-2011016108-A1 · demande de brevet déposée le 19 juillet 2010
Inventeurs : Matias Pelenur, Samarth Keshava et Jeremy Silber
Ce brevet décrit le « plusbox » : Google limite le nombre de résultats d’un même site dans la première réponse, puis ajoute un petit contrôle (« Afficher plus de résultats ») qui déplie les autres pages du même domaine, sans relancer de recherche. Le problème posé, c’est l’arbitrage entre qualité et diversité : on évite qu’un seul host monopolise la SERP, tout en laissant l’utilisateur creuser. Ce n’est pas un signal de ranking, soyons honnêtes. Mais ça dit quelque chose de stratégique : sur une requête donnée, le moteur filtre d’abord par source, puis classe les pages à l’intérieur de cette source. Le levier est indirect, mais il est réel.
Les moteurs de recherche traditionnels peuvent avoir des difficultés lorsqu’ils décident entre fournir aux utilisateurs un plus grand nombre de résultats provenant d’un seul site web hautement pertinent (qualité des résultats) et fournir aux utilisateurs des résultats diversifiés provenant de divers sites web (diversité des résultats). Pour surmonter ce défi technique, les moteurs de recherche traditionnels limitent l’affichage des résultats provenant d’un hôte ou d’un domaine particulier.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Vous ne jouez pas à « combien de pages mon site place sur la requête », mais à « quelle page représente mon site en premier, et lesquelles sont prêtes derrière ». Le brevet évoque aussi un traitement des résultats additionnels (tri, suppression des doublons, fusion des résultats similaires, regroupement par hiérarchie). Des pages quasi identiques ont donc de bonnes chances de se neutraliser entre elles. Concrètement : une page canonique claire et pertinente par intention, un maillage et une arborescence lisibles, et des pages secondaires qui apportent un angle distinct plutôt qu’une variante. À noter que ce sont des déductions du brevet, pas une garantie de ce qui s’affiche aujourd’hui.
Exemple : Votre site a cinq articles sur « audit de maillage interne » qui se recoupent. Un seul s’affiche, les autres se retrouvent dans le dépliant (voire fusionnés comme doublons). Si vous consolidez en un guide solide et gardez deux pages vraiment distinctes (outil, étude de cas), le résultat visible est le bon et les pages du dépliant ont un intérêt propre.
Thèmes : SERP, Positionnement, Intention de recherche, Maillage interne · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Propagating query classifications
US-8838587-B1 · déposé le 19 avril 2010, délivré le 16 septembre 2014
Inventeurs : Henele I. Adams et Hyung-Jin Kim
Prolongé par la continuation US-9659097-B1 (23 mai 2017)
Ce brevet décrit comment Google décide qu’une requête relève d’une catégorie (produit, image/vidéo, géographique, actualités, contenu adulte) sans se contenter de lire le texte de la requête. Il regarde les entités (documents, sites, domaines ou autres requêtes) que les utilisateurs ont jugées pertinentes via leurs clics, leur temps passé ou leurs achats, et il regarde aussi quelles classes ces entités portent déjà. Si la majorité d’entre elles, et surtout les mieux placées en pertinence, partagent la même classe, la requête hérite de cette étiquette. Pour faire simple : l’intention d’une requête se déduit de ceux qui la satisfont. Le levier est indirect, vous ne tapez pas dans un réglage, mais il est réel : la classe de votre page ou de votre site peut peser sur la manière dont Google lit l’intention et sur les formats de résultats qu’il déclenche.
Étant donné la brièveté de nombreuses requêtes, les classifications de requêtes fondées sur une requête elle-même peuvent être difficiles à déterminer avec précision. Par exemple, la requête « lincoln » pourrait être classée comme se rapportant à une figure historique (par exemple, le président Lincoln), à une localisation géographique (par exemple, Lincoln, Nebr.), à un produit (par exemple, la marque de voiture Lincoln), etc.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Pour qu’une requête bascule vers l’intention que vous visez (transactionnelle, locale, actualité…), il ne suffit pas d’y avoir une page : il faut que les entités les plus pertinentes aux yeux des utilisateurs, donc les mieux servies en comportement, soient clairement du bon type. Cela rend stratégique la cohérence de type de page et de site (une vraie fiche produit avec prix, description, disponibilité, pas un article déguisé), puisque la classe se propage depuis les entités et pas seulement depuis le texte. À noter que le brevet exige un volume minimum de données comportementales : une page peu visitée ou peu cliquée pèse mécaniquement peu dans le calcul, donc votre influence sur la classification passe d’abord par l’engagement réel. Ce qu’il faut retenir : la classification d’une requête dépend du top des résultats, pas d’une seule URL. Visez donc la cohérence de type sur l’ensemble de vos pages positionnées, pas sur une page isolée. Restons prudents : le brevet ne dit pas comment ces poids se traduisent en position, il décrit une entrée du ranking (filtres, formats, présentation), pas un facteur à optimiser directement.
Exemple : Sur une requête ambiguë du type « nom de modèle + avis », si les résultats les plus cliqués et les plus longtemps consultés sont des fiches marchandes classées « produit », la requête peut être étiquetée produit et déclencher un affichage avec prix et disponibilité. Un site qui y répond avec un article purement éditorial, sans données produit, a donc moins de chances d’être aligné avec l’intention que Google a inférée.
Thèmes : Intention de recherche, Expérience utilisateur, Positionnement, Entités et sémantique · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Ranking documents based on user behavior and/or feature data
US-8117209-B1 · déposé le 19 mars 2010, délivré le 14 février 2012
Inventeurs : Jeffrey A. Dean, Corin Anderson et Alexis Battle
Continuation du brevet US-7716225-B1
Ce brevet est une continuation du « reasonable surfer » : plutôt que de donner le même poids à tous les liens d’une page, Google estime la probabilité qu’un lien soit réellement cliqué. Le modèle s’appuie sur les caractéristiques du lien et sur le comportement des utilisateurs, y compris leur classe. Il apprend à partir d’exemples positifs (lien cliqué) et négatifs (lien ignoré avant que l’utilisateur quitte la page). Ça ne bouleverse pas votre quotidien, mais ça confirme un déséquilibre : un lien n’a pas la même valeur selon sa place, son apparence et sa probabilité d’être cliqué. À noter que le brevet décrit un mécanisme, pas la preuve qu’il tourne tel quel en production.
Le World Wide Web (« web ») contient une vaste quantité d’informations. Localiser une portion désirée des informations, cependant, peut être difficile. Ce problème est aggravé parce que la quantité d’informations sur le web et le nombre de nouveaux utilisateurs inexpérimentés dans la recherche sur le web augmentent rapidement.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Un lien noyé dans un footer ou une zone que personne ne clique transmet probablement moins qu’un lien éditorial visible, pertinent pour le lecteur et placé là où il a une chance d’être suivi. Concrètement, il faut juger vos liens internes et vos backlinks sur leur probabilité de clic, pas sur leur seul nombre. Le brevet prévoit aussi des règles globales (valables partout) et des règles propres à un document, donc la mise en page d’une page donnée peut jouer localement. Côté netlinking, un lien dans un contexte où il sera lu et cliqué est stratégique, alors qu’un lien « décoratif » est plutôt inutile. Reste à nuancer : on ne sait pas quels attributs pèsent réellement, donc on teste et on reste prudent.
Exemple : Entre deux liens vers votre page produit, l’un dans un paragraphe éditorial avec une ancre qui répond à la question du lecteur, l’autre dans un bloc de 80 liens en pied de page, le premier a de bien meilleures chances d’être cliqué. Il est donc, selon ce modèle, celui qui porte le plus de poids. Je déplacerais vos liens importants vers le corps du contenu.
Thèmes : Expérience utilisateur, Positionnement, Personnalisation des résultats, Intention de recherche · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Information extraction from a database
US-8037065-B1 · déposé le 19 janvier 2010, délivré le 11 octobre 2011
Inventeur : Sergey Brin
Division du brevet US-7650330-B1
Prolongé par la continuation US-8332371-B1 (11 décembre 2012)
Ce brevet décrit une méthode d’extraction d’information par amorçage. On part de quelques « tuples » (par exemple un couple auteur/titre), on cherche où ils apparaissent sur le Web, on repère le motif de mise en forme autour d’eux, puis on s’en sert pour dénicher d’autres couples, et on recommence. Pour faire simple : la machine apprend à lire vos pages en observant comment une information est habituellement posée dans le texte. Ce n’est pas un signal de ranking, et le brevet ne dit rien sur la façon dont Google classe quoi que ce soit. Mais ça éclaire la manière dont des faits et des entités peuvent être aspirés depuis du texte non structuré, sans balisage. Le levier est donc indirect, mais réel.
L’Internet, et plus particulièrement le World Wide Web (« Web »), est un vaste dépôt d’informations qui est extrêmement distribué, tant dans l’emplacement que dans la manière dont l’information est stockée. Par exemple, un type particulier de données tel que des listes de restaurants peut être dispersé à travers des milliers de sources d’information indépendantes (par exemple, des hôtes) dans de nombreux formats différents.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qui compte, c’est la régularité. Le système généralise à partir de contextes similaires (URL, texte avant, texte entre les champs, texte après), et il filtre par spécificité et par recoupement entre plusieurs motifs avant d’accepter un fait. Concrètement, une information présentée toujours de la même façon, sur un gabarit stable et dans une section d’URL cohérente, a plus de chances d’être extraite proprement. Et une information confirmée par plusieurs sources indépendantes passe mieux la vérification. Côté GEO, cela plaide pour des faits en phrases explicites, cohérents d’une page à l’autre, plutôt que des formulations changeantes. À noter que le brevet décrit un mécanisme générique d’extraction : rien n’indique qu’il soit appliqué tel quel à votre site. Les données structurées restent un complément évident, pas un substitut.
Exemple : Vous gérez un annuaire de 500 fiches produit : si chacune présente la marque, le modèle et le prix selon la même formulation et le même gabarit HTML, un motif se dégage facilement et l’extraction est fiable. Si chaque rédacteur tourne ça à sa sauce, le motif devient flou et l’info a moins de chances d’être recoupée.
Thèmes : Crawl, Intention de recherche, Entités et sémantique, Embeddings · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Ranking documents
US-8244722-B1 · déposé le 5 janvier 2010, délivré le 14 août 2012
Inventeur : Ross Koningstein
Prolongé par la continuation US-8924380-B1 (30 décembre 2014)
Ce brevet décrit un piège à manipulateurs. Quand les facteurs de ranking d’un document changent, Google n’affiche pas tout de suite le nouveau rang : il fait transiter le document par une trajectoire artificielle (hausse puis baisse, délai, réaction inattendue). Ensuite, il observe si les facteurs (les liens, typiquement) bougent en écho à cette trajectoire. Si oui, c’est qu’un humain réagit aux variations, donc qu’il manipule, et le document peut être rétrogradé, voire le site, le domaine ou les liens associés. Pour vous, ça ne change pas la rédaction de vos contenus, mais ça éclaire une chose : réagir à chaud à chaque mouvement de SERP, c’est potentiellement se signaler. À noter que c’est un brevet, pas la preuve d’un déploiement : on ne sait pas s’il tourne, ni à quelle échelle. Le levier reste donc indirect, il porte sur la discipline d’analyse plus que sur une action de contenu.
Les techniques de spamming modifiant le classement, telles que le spamming d’index et le spamming de liens, comprennent un ensemble de techniques par lesquelles les fournisseurs d’informations tentent de tromper un moteur de recherche afin de classer leurs informations (ou celles de leurs clients) au sommet ou près du sommet de la liste des résultats de recherche. Certaines des techniques utilisées par les spammeurs modifiant le classement comprennent le bourrage de mots-clés, le texte invisible, le texte minuscule, les redirections de pages, le bourrage de balises META et la manipulation basée sur des liens.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ne pilotez pas vos optimisations (netlinking, ancres, ajustements on-page) en réaction immédiate aux oscillations de position. Pendant une phase de transition, un rang peut bouger sans que rien n’ait changé côté facteurs : ce bruit n’est pas forcément un signal exploitable. Raisonnez sur des fenêtres de temps longues, groupez vos modifications, évitez les corrélations trop visibles entre un mouvement de rang et une vague de liens ou de changements de page. Et si vous pratiquez le link building agressif, le risque est direct ET indirect : la page peut être démotée, et les entités liées (site, domaine, liens) peuvent en pâtir.
Exemple : Une page grimpe puis retombe en quelques jours après une modif. Plutôt que de lui injecter aussitôt une salve de backlinks pour « rattraper », vous attendez, vous documentez, et vous n’agissez que si la tendance se confirme sur plusieurs semaines : vous évitez d’offrir à Google la corrélation rang/réaction qu’il cherche.
Thèmes : Positionnement, Spam, Intention de recherche, Analytics · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Brevets déposés en 2009
Representative document selection for sets of duplicate documents in a web crawler system
US-7984054-B2 · déposé le 1er décembre 2009, délivré le 19 juillet 2011
Inventeurs : Daniel Dulitz, Alexandre A. Verstak, Sanjay Ghemawat et 1 autre
Division du brevet US-7627613-B1
Prolongé par la continuation US-8260781-B2 (4 septembre 2012)
Ce brevet décrit comment le crawler de Google traite les doublons : il ne les indexe pas chacun de son côté, il les regroupe en un ensemble et désigne un seul représentant, choisi sur un score indépendant de la requête (type PageRank). Seul ce représentant est indexé, et les traitements en aval peuvent aussi l’ignorer, les autres copies. Le tout se joue très tôt, avant l’indexation, via une empreinte (fingerprint) du contenu, c’est-à-dire une signature de longueur fixe : même signature, même contenu. À noter que c’est un brevet ancien et que le résumé ne dit rien de l’état actuel du système, donc on garde un peu d’esprit critique. Reste que la logique de fond (un seul gagnant par cluster de doublons, désigné par un score d’importance) est directement exploitable.
Cependant, à mesure que le nombre de documents sur Internet augmente, il faut des périodes de plus en plus longues entre le moment où une page web est explorée par un robot et le moment où elle peut être indexée et mise à la disposition d’un moteur de recherche. En outre, il faut des périodes de plus en plus longues pour remplacer ou mettre à jour une page une fois qu’elle a été indexée.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Quand vous avez plusieurs URL au contenu identique, vous ne décidez pas seulement d’un problème de « duplicate content » : vous déclenchez une compétition interne où l’URL au score d’importance le plus élevé devient le représentant, et les autres sont exclues de l’index (l’ensemble peut même être borné en taille, donc les copies les plus faibles sont écartées). Le déséquilibre est donc à créer volontairement : concentrez liens internes, liens externes et signaux de redirection sur l’URL que vous voulez voir indexée, sinon c’est le crawler qui tranche à votre place. Le brevet précise aussi que les redirections permanentes sont enregistrées sans suivre la cible, et que les liens sortants pointant vers elles sont réécrits vers l’URL cible : une 301 propre consolide donc, de façon directe ET indirecte, les signaux de liens vers la bonne URL. Les redirections temporaires, elles, n’indiquent aucune URL préférée.
Exemple : Un site e-commerce expose la même fiche produit en http/https, avec et sans paramètres de tri, sur trois URL. Si vous laissez les liens internes se disperser entre elles, la version retenue peut être celle que vous ne vouliez pas. En faisant des 301 vers une seule URL et en alignant maillage et canoniques sur elle, vous lui donnez le meilleur score du groupe, donc le statut de représentant.
Thèmes : Contenu dupliqué, Crawl, Indexation, Positionnement · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
System for user driven ranking of web pages
US-7716205-B1 · déposé le 29 octobre 2009, délivré le 11 mai 2010
Inventeur : Borislav Agapiev
Ce brevet remplace l’hypothèse du « surfeur aléatoire » du PageRank classique (chaque lien sortant d’une page a la même chance d’être cliqué) par des probabilités mesurées sur de vrais clics. Une extension de navigateur observe quel lien est choisi depuis quelle page, compte chaque sélection, et ces compteurs alimentent la même équation de PageRank avec amortissement. Le stockage passe par une table de hachage distribuée (une base répartie entre plein de machines), et le résultat sert à ordonner les résultats de recherche. Rien ne dit que Google l’applique tel quel, et je ne vais pas vous vendre ça comme une confirmation. Mais c’est une illustration nette d’un déséquilibre : un lien n’a pas le même poids selon qu’il est réellement cliqué ou simplement présent dans le code.
Bien qu’utile, le modèle du surfeur aléatoire pour le classement des pages ignore la réalité selon laquelle toutes les pages Web ne sont pas égales. C’est-à-dire que certaines pages Web sont clairement plus populaires que d’autres. Par conséquent, les liens associés à de telles pages sont plus susceptibles d’être parcourus par de véritables internautes et, en conséquence, devraient se voir accorder plus de poids que les liens qui sont peu susceptibles d’être sélectionnés par des internautes.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le levier est indirect mais réel : si un modèle de ce type était utilisé, la valeur d’un lien dépendrait de sa probabilité d’être cliqué, pas seulement de sa présence. Un lien noyé dans un footer, une sidebar ou un paragraphe que personne ne lit transmettrait donc peu, alors qu’un lien visible, contextuel et pertinent pour l’utilisateur pèserait davantage. Pour faire simple, il devient stratégique de travailler la pertinence du lien et sa position, et pas seulement leur nombre. Ça vaut pour le maillage interne (impact direct sur la circulation du poids) comme pour les liens obtenus à l’extérieur (impact indirect via le trafic réellement envoyé). À noter que le brevet décrit une collecte côté navigateur : c’est un modèle, pas la preuve d’un signal en production.
Exemple : Sur un article de blog, vous avez 15 liens internes dont un seul, placé dans le corps du texte au moment où le lecteur se pose la question, est vraiment cliqué. Dans une logique de clics observés, c’est ce lien-là qui concentre l’essentiel de la probabilité de transition. Le déplacer vers votre page stratégique et soigner son ancre vaut plus que d’en ajouter cinq autres en bas de page.
Thèmes : Expérience utilisateur, Positionnement, Backlinks, Crawl · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Agent rank
US-8224826-B2 · déposé le 21 juillet 2009, délivré le 17 juillet 2012
Inventeurs : David Minogue et Paul A. Tucker
Continuation du brevet US-7565358-B2
Prolongé par la continuation US-8296293-B2 (23 octobre 2012)
Agent Rank, c’est l’idée d’un score de réputation attaché à un « agent » (un auteur, un éditeur, un relecteur) plutôt qu’à une page ou à un domaine. L’agent signe numériquement des contenus, et son score dépend de ce qu’il a signé et des liens que ces contenus reçoivent. Cette continuation ajoute deux choses : un contexte (le sujet de chaque contenu signé) et un rôle déclaré (auteur, éditeur, éditeur-diffuseur, relecteur). Le score devient donc thématique et sensible à la manière dont l’agent se positionne par rapport au contenu. Attention à rester lucide : un brevet n’est pas une preuve d’usage en production, et rien ici ne dit que Google applique ce système tel quel. Mais la logique (réputation par entité, par sujet, par rôle) est cohérente avec ce qu’on pousse déjà côté E-E-A-T. Pas un levier direct, mais une grille de lecture stratégique.
En général, cependant, il est difficile de corréler le contenu d’une source d’information avec les agents responsables de la création ou de la publication de ce contenu. Par exemple, un auteur individuel peut contribuer du contenu à plusieurs sources d’information, le contenu au sein d’une seule source d’information peut provenir de plusieurs agents, ou la propriété et le contrôle des sources d’information peuvent changer au fil du temps.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Traitez l’auteur comme une entité à part entière, avec une réputation qui se construit sujet par sujet. Concrètement : identifiez clairement qui écrit, qui relit, qui publie, sur chaque contenu ; restez cohérent sur vos thématiques d’expertise plutôt que de vous disperser ; et obtenez des liens et des mentions qui pointent vers des contenus précis signés, pas seulement vers la home. Le brevet précise aussi qu’un score se calcule sur la portion signée d’une page, pas sur le reste. Une page mélangeant plusieurs contributeurs gagne donc à rendre visible qui est responsable de quoi. Impact direct limité, mais indirect réel sur la crédibilité par sujet.
Exemple : Un site santé fait écrire un article par un rédacteur et le fait relire par un médecin : vous affichez les deux rôles distinctement (auteur, relecteur), avec des pages profil cohérentes et centrées sur la thématique. Si le médecin ne relit que des sujets de sa spécialité, sa réputation par sujet reste nette, au lieu d’être diluée sur des contenus sans rapport.
Thèmes : Backlinks, Autorité, Entités et sémantique, Positionnement · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Brevets déposés en 2008
Rating raters
US-2009144272-A1 · demande de brevet déposée le 2 décembre 2008
Inventeurs : Anurag Adarsh, Apurv Gupta et Vihari Komaragiri
Ce brevet décrit un système qui note les notateurs : on compare les notes d’un utilisateur à celles des autres sur les mêmes contenus (pages, commentaires, produits), on en tire un score de qualité, et on pondère son influence en conséquence. Les fraudeurs et spammeurs, qui s’écartent trop de la foule, pèsent moins, voire disparaissent du calcul. Le brevet va plus loin : ce score peut servir à classer des documents, des résultats de recherche, et même à noter les auteurs des contenus. À noter que rien ne dit que Google l’applique tel quel au ranking web. C’est un mécanisme à comprendre, pas un levier à activer.
Certaines personnes sont motivées à « trafiquer » les systèmes de notation. Par exemple, un utilisateur qui fabrique un produit particulier peut chercher à soumettre de nombreuses évaluations faussement positives pour le produit afin d’augmenter sa note composite, et ainsi amener les autres à croire que le produit est meilleur qu’il ne l’est en réalité. De même, un utilisateur peut tenter de diminuer la note du produit d’un concurrent.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir, c’est que les signaux d’avis et de notes sont censés être pondérés par la fiabilité de celui qui les émet, pas comptés au kilo. Pour vous, le déséquilibre est clair : des notes en rafale, toutes extrêmes et alignées sur une seule cible, sont exactement le profil que ce type de système cherche à neutraliser (impact direct : elles comptent peu ; indirect : elles peuvent fragiliser la crédibilité de l’ensemble). Stratégique plutôt qu’inutile : viser des avis variés, issus de vrais utilisateurs, dont le comportement de notation reste cohérent avec celui du reste du public. Le brevet précise aussi que le biais personnel (le grand optimiste ou le grand pessimiste) est normalisé, donc un client très généreux en 5 étoiles n’est pas condamné d’office.
Exemple : Vous gérez une fiche produit ou un module d’avis sur un site : 30 avis 5 étoiles arrivés en deux jours, postés par des comptes qui n’ont jamais noté autre chose, ressemblent à un cluster de faux raters. Mieux vaut un flux d’avis étalé dans le temps, venant de comptes qui notent aussi d’autres produits, quitte à avoir une moyenne un peu moins parfaite.
Thèmes : Positionnement, Expérience utilisateur, Analytics · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Website quality signal generation
US-8442984-B1 · déposé le 31 mars 2008, délivré le 14 mai 2013
Inventeurs : Christopher C. Pennock, Jeremy Hylton et Corinna Cortes
Ce brevet décrit un pipeline qui fait noter des sites par des humains (évaluateurs), apprend quels signaux du site prédisent cette note, puis applique le modèle à tous les sites non notés. Le score obtenu sert ensuite à filtrer sous un seuil et à ordonner les résultats. Pour faire simple : une note de qualité calculée à l’échelle du site entier, pas seulement de la page. Les exemples de signaux cités sont le taux de clic, le taux d’abonnement (pour les blogs) et le PageRank. À noter que c’est un brevet centré sur les blogs, donc à transposer avec prudence : il prouve qu’un tel mécanisme est pensé et protégé, pas qu’il tourne tel quel aujourd’hui. Le levier est indirect mais bien réel.
Les sites Web sont classés, des relations entre les classements et les signaux du site Web sont identifiées, des modèles sont générés et des classements modélisés sont attribués à des sites Web non classés en appliquant les modèles aux signaux du site Web des sites Web non classés.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Un site peut être jugé comme un tout : la qualité et la cohérence thématique de l’ensemble des pages comptent, et des pages faibles ou hors sujet peuvent tirer l’ensemble vers le bas. Concrètement, élaguer, regrouper et resserrer la thématique devient stratégique. Les signaux d’entrée cités (clics en résultats, PageRank, fidélité de l’audience) se travaillent : titres et snippets qui méritent le clic, liens de qualité, raisons de revenir ou de s’abonner. Le brevet évoque aussi un filtrage en amont des sites spam ou qui ne chargent pas, et un seuil sous lequel un site peut disparaître des résultats : l’impact est direct (exclusion) ET indirect (classement). Reste un déséquilibre à garder en tête : on ne contrôle pas la note elle-même, seulement les signaux qui la nourrissent.
Exemple : Vous gérez un blog de 300 articles dont une centaine de contenus minces, hors sujet ou jamais cliqués. Supprimer ou fusionner ces pages et recentrer le site sur son cœur thématique améliore la cohérence d’ensemble qu’un évaluateur (ou un modèle entraîné sur ses notes) percevrait, plutôt que de laisser ces pages diluer la qualité moyenne.
Thèmes : Qualité du contenu, Spam, Positionnement, Analytics · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Brevets déposés en 2007
Anchor tag indexing in a web crawler system
US-8484548-B1 · déposé le 7 novembre 2007, délivré le 9 juillet 2013
Inventeurs : Huican Zhu, Jeffrey Dean, Sanjay Ghemawat et 2 autres
Division du brevet US-7308643-B1
Prolongé par la continuation US-9305091-B2 (5 avril 2016)
Ce brevet décrit la plomberie d’un crawler : à partir des liens extraits des pages, Google construit deux structures triées. Une « link map » classée par page source, qui alimente le calcul de PageRank (un score de pertinence indépendant de la requête). Et une « anchor map » classée par page cible, qui regroupe tout ce qui pointe vers un document. Pour faire simple, le texte d’ancre et le texte autour du lien sont rattachés à la page ciblée et indexés comme s’ils la décrivaient. Ce que les autres disent de votre page peut donc compter autant que ce que vous en dites. Rien de neuf sur le principe (on le sait depuis longtemps), mais c’est une confirmation mécanique, noir sur blanc, de la façon dont ça fonctionne côté indexation. Le levier est réel mais indirect : on ne pilote pas ce qu’on ne contrôle pas.
Les moteurs de recherche fournissent une source puissante de documents indexés provenant d’Internet qui peuvent être balayés rapidement. Cependant, à mesure que le nombre de documents sur Internet croît, les périodes de temps entre le moment où une page est explorée par un robot et le moment où elle peut être indexée et rendue disponible à un moteur de recherche deviennent de plus en plus longues.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Les ancres de vos liens entrants (internes comme externes) servent de description de la page cible dans l’index, avec le contexte textuel situé à une certaine distance de la balise. Ce qu’il faut retenir : soignez la pertinence des ancres, mais aussi la phrase qui entoure le lien. Le gain est maximal pour les pages pauvres en texte (images, vidéos, PDF, pages tout juste découvertes), pour lesquelles le texte des autres pages peut être une meilleure description que leur propre contenu. Côté maillage interne, des ancres génériques type « cliquez ici » gaspillent ce signal. Et puisque les couches de l’anchor map sont fusionnées et peuvent contenir des suppressions, un lien retiré ou modifié finit par disparaître de l’équation (le brevet ne dit pas en combien de temps).
Exemple : Vous avez une page de ressource en PDF ou une page outil quasi sans texte. Plutôt que de la lier partout avec « en savoir plus », vous la liez depuis vos articles avec des ancres descriptives, du genre « modèle de tableau de bord SEO à télécharger », et une phrase de contexte juste autour. Mécaniquement, ces termes se retrouvent associés à la page cible dans l’index.
Thèmes : Crawl, Indexation, Backlinks, Positionnement · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Modifying search result ranking based on a temporal element of user feedback
US-9092510-B1 · déposé le 30 avril 2007, délivré le 28 juillet 2015
Inventeurs : Robert J. Stets Jr. et Mark Andrew Paskin
Ce brevet décrit un mécanisme où les clics sur un résultat ne sont pas comptés en bloc : ils sont pondérés selon leur ancienneté, et comparés à la tendance de clics des autres documents sur la même requête. En gros, un résultat dont les clics progressent plus vite que le "bruit de fond" gagne en pertinence, et les vieux clics pèsent de moins en moins. Pourquoi ça compte ? Parce que ça dit que la popularité acquise ne suffit pas, c’est la dynamique récente qui joue (et ça casse l’effet boule de neige du « je suis déjà premier, donc je reste premier »). À noter que c’est un brevet, pas une confirmation d’usage en prod, et que les seuils cités (100 sélections, tranches de 2 semaines) sont des exemples de description, pas des règles gravées. Mais côté raisonnement, c’est exploitable : le comportement utilisateur a une date de péremption.
D’autres entrées diverses peuvent être utilisées à la place, ou en plus, de telles techniques pour déterminer et classer des résultats de recherche. Par exemple, les réactions des utilisateurs à des résultats de recherche particuliers ou à des listes de résultats de recherche peuvent être évaluées, de sorte que les résultats sur lesquels les utilisateurs cliquent souvent recevront un classement plus élevé.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir c’est que votre CTR et l’engagement ne sont pas un capital qu’on encaisse une fois : mécaniquement, ils s’érodent si la tendance ne suit pas. Concrètement : (1) surveillez le CTR par requête dans la Search Console sur des fenêtres glissantes (semaines, pas seulement le cumul), pour repérer une pente qui s’aplatit avant que le rang ne bouge ; (2) retravaillez title et meta description des pages qui stagnent pour relancer la pente de clics, pas seulement pour gagner un point de CTR ; (3) rafraîchissez vraiment les contenus sur les requêtes fréquentes, parce que c’est là que le mécanisme décrit cherche à contrer la rente de situation. Et gardez en tête le « direct ET indirect » : le gain n’est pas que dans le rang, c’est aussi la capacité à entretenir une dynamique face aux concurrents. Mais attention, on ne pilote pas ce signal à la main, ni en gonflant des clics artificiels : c’est un levier de pertinence perçue, pas un bouton.
Exemple : Vous êtes en position 3 sur une requête très recherchée, avec un bon CTR historique, mais depuis un mois la courbe de clics est plate alors que celle des concurrents monte. Vous réécrivez le title avec un angle plus actuel, mettez à jour le contenu et la date réelle de révision : si les clics repartent plus vite que ceux des autres pages de la SERP, c’est exactement le type de pente que ce brevet récompense.
Thèmes : Positionnement, Expérience utilisateur, Fraîcheur du contenu, Analytics · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Brevets déposés en 2006
Document scoring based on traffic associated with a document
US-8316029-B2 · déposé le 30 novembre 2006, délivré le 20 novembre 2012
Inventeur : Steve Lawrence
Division du brevet US-7346839-B2
Prolongé par la continuation US-9767478-B2 (19 septembre 2017)
Ce brevet décrit un score de document qui s’appuie sur l’historique des publicités présentes dans la page. On regarde à quelle fréquence les pubs apparaissent, disparaissent ou sont mises à jour, puis la qualité des annonceurs, mesurée par le trafic ou la fiabilité des pages vers lesquelles pointent ces pubs. Le score sert ensuite à classer la page face à d’autres, en complément des signaux de liens. L’idée est intéressante parce qu’elle montre que Google a pu envisager la publicité comme indice de fraîcheur et de qualité. Mais attention à ne pas en faire un levier miracle : un brevet décrit une possibilité, pas un facteur confirmé en production, et le levier reste ténu pour un SEO.
Les deux catégories de moteurs de recherche s’efforcent de fournir des résultats de haute qualité pour une requête de recherche. Plusieurs facteurs peuvent affecter la qualité des résultats générés par un moteur de recherche.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Rien à activer directement, mais une vigilance à avoir sur le déséquilibre entre contenu et monétisation. Si vous affichez des pubs ou des liens sponsorisés, la pertinence des destinations compte (impact direct sur l’expérience, indirect sur d’éventuels signaux de qualité). Évitez les emplacements qui pointent vers des sites douteux ou peu fréquentés. Et ne cherchez surtout pas à faire tourner des pubs en boucle pour simuler de la fraîcheur : la fraîcheur éditoriale réelle reste le seul terrain stratégique.
Exemple : Sur un site média ou un comparateur monétisé par de l’affichage, auditez les annonceurs et les pages de destination des bannières. Si certaines renvoient vers des sites de faible qualité, les retirer est un nettoyage cohérent avec ce que ce brevet suggère, sans promesse de gain de ranking mesurable.
Thèmes : Positionnement, Expérience utilisateur, Qualité du contenu, Spam · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Document scoring based on document content update
US-8112426-B2 · déposé le 21 novembre 2006, délivré le 7 février 2012
Inventeurs : Anurag Acharya, Jeffrey Dean, Paul Haahr et 4 autres
Division du brevet US-7346839-B2
Ce brevet décrit un score de qualité calculé à partir de l’historique des modifications d’un document : combien de fois il change (fréquence) et de combien (amplitude, mesurée sur le contenu visible, avec un poids réduit pour les parties jugées sans importance). Ce score sert ensuite à classer un résultat par rapport à un autre. Ce n’est donc pas une simple « fraîcheur » à la date de publication, c’est une trajectoire : le système compare aussi le rythme de changement d’une période à l’autre, et regarde si la thématique dérive ou si le texte d’ancre des liens entrants s’écarte du contenu. À noter qu’un brevet n’est pas la preuve d’un facteur actif, et que la description dit elle-même que ce score s’applique après la sélection des documents pertinents. Ce qu’il faut retenir : le levier est réel mais indirect, il se joue sur la manière dont vous faites vivre vos pages. Des mises à jour substantielles, pas cosmétiques.
De plus, des documents « périmés » (c’est-à-dire les documents qui n’ont pas été mis à jour pendant une période de temps et qui, ainsi, contiennent des données périmées) peuvent être classés plus haut que des documents « plus frais » (c’est-à-dire les documents qui ont été mis à jour plus récemment et qui, ainsi, contiennent des données plus récentes). Dans certains contextes particuliers, les documents périmés mieux classés dégradent les résultats de recherche.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Planifiez vos mises à jour comme un rythme éditorial, pas comme des retouches de dernière minute. Ce que le brevet valorise (une lecture à nuancer, puisque ce n’est qu’un brevet) : un changement qui touche une vraie part du contenu visible, de manière régulière, avec l’ajout de nouvelles pages dans un ensemble. Changer une date ou une phrase de pied de page est probablement sans valeur, puisque les zones jugées peu importantes pèsent peu. Autre point à surveiller : la cohérence entre l’évolution de vos contenus et les ancres des liens entrants. Si vous réorientez une page, vérifiez que le sujet reste en phase avec ce que les liens racontent. Enfin, une activité qui ralentit peut jouer contre vous, puisque l’accélération ou la décélération entre deux périodes entre dans le calcul.
Exemple : Sur un guide pillar, plutôt que de rafraîchir la date chaque trimestre, vous réécrivez les sections devenues obsolètes, vous ajoutez de nouveaux chapitres, et vous créez les pages satellites correspondantes. La part de contenu visible modifiée est significative, le rythme est régulier, et le sujet reste aligné avec les ancres des liens déjà acquis.
Thèmes : Fraîcheur du contenu, Positionnement, Crawl, Backlinks · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Document scoring based on document inception date
US-7840572-B2 · déposé le 20 novembre 2006, délivré le 23 novembre 2010
Inventeurs : Matt Cutts, Jeffrey Dean, Paul Haahr et 4 autres
Division du brevet US-7346839-B2
Prolongé par la continuation US-8521749-B2 (27 août 2013)
Ce brevet décrit un score qui part de la date de naissance d’un document, son « inception date ». Cette date n’est pas un simple timestamp : Google la reconstruit à partir de plusieurs indices (première découverte ou indexation du document, premier lien repéré vers lui, enregistrement du domaine, première mention dans un autre document, moment où il atteint un certain seuil de pages, voire la date déclarée par le serveur). Elle sert ensuite à ajuster un score, à mesurer le rythme de création des liens, ou à comparer l’âge d’une page à celui de ses concurrentes dans un même groupe de résultats. Ce n’est pas un levier qu’on actionne d’un clic, mais ça éclaire ce que Google regarde vraiment quand on parle d’« ancienneté » (et ça n’a rien à voir avec la date affichée dans la SERP). À noter que le brevet ne favorise ni l’ancien ni le récent par principe : tout dépend de la règle configurée.
De plus, les documents « stale » (c’est-à-dire les documents qui n’ont pas été mis à jour pendant une période de temps et qui contiennent ainsi des données stale) peuvent être classés plus haut que les documents « plus frais » (c’est-à-dire les documents qui ont été mis à jour plus récemment et qui contiennent ainsi des données plus récentes). Dans certains contextes particuliers, les documents stale mieux classés dégradent les résultats de recherche.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir c’est que l’âge d’une page se calcule à partir de signaux que vous pouvez influencer, direct ET indirect. Faites découvrir vite vos nouvelles URL (sitemap, maillage interne, premiers liens entrants) pour que la date de première découverte soit la plus tôt possible. Évitez de casser vos URL, de les migrer ou de les changer d’adresse sans redirection propre : vous risquez de repartir de zéro côté historique. Surveillez aussi la vitesse d’acquisition des liens : ce brevet la mesure par rapport à la naissance du document, donc une rafale de liens très tôt n’a pas le même sens qu’un flux régulier. Enfin, je reste prudent : rien ne prouve ici le poids réel de ce signal, et l’ajuster artificiellement (acheter un vieux domaine, par exemple) serait un pari hasardeux, d’autant que le texte distingue des sources plus ou moins manipulables.
Exemple : Vous publiez un guide stratégique : poussez-le tout de suite dans le sitemap et linkez-le depuis des pages déjà crawlées, pour fixer une date de première découverte rapide. Puis évitez de le republier sous une nouvelle URL « pour rafraîchir » : vous perdriez l’historique de naissance au profit d’une page qui repart de zéro.
Thèmes : Fraîcheur du contenu, Positionnement, Backlinks, Actualités · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Producing a ranking for pages using distances in a web-link graph
US-9165040-B1 · déposé le 12 octobre 2006, délivré le 20 octobre 2015
Inventeur : Nissan Hajaj
Prolongé par la continuation US-9953049-B1 (24 avril 2018)
Ce brevet décrit une alternative au PageRank classique : plutôt que de faire tourner un calcul lourd par page « de confiance » (les seeds, ces sites de départ jugés fiables), Google mesure la plus courte distance dans le graphe de liens entre une seed et chaque page. Chaque lien reçoit une « longueur » : plus la page source fait de liens sortants, plus le lien est long, donc moins favorable. Le score de la page décroît ensuite de façon exponentielle avec cette distance. À noter que le brevet retient la k-ième seed la plus proche (k entre 3 et 6, par exemple) et pas la première, pour éviter qu’une seule seed complaisante gonfle un score. Je ne vous cache pas que c’est du ranking par les liens, vieille école, et qu’on ignore comment il pèse aujourd’hui. Mais la logique, elle, est limpide et exploitable.
Cependant, la formulation simple de l’Équation (1) pour calculer le PageRank est vulnérable aux manipulations. Certaines pages web (appelées « pages de spam ») peuvent être conçues pour utiliser diverses techniques afin d’obtenir des PageRanks artificiellement gonflés, par exemple, en formant des « fermes de liens » ou en créant des « boucles ».
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qui compte, c’est la proximité de vos pages avec des sources de confiance, et pas le volume brut de liens. Un lien depuis une page qui n’en émet que quelques-uns est concrètement plus « court » (donc plus précieux) qu’un lien noyé dans une page à 200 sorties. Comme le brevet s’appuie sur la k-ième seed la plus proche, un seul lien d’une source prestigieuse ne suffit pas : il faut être proche de plusieurs sources fiables, pas d’une seule. Côté netlinking, on privilégie donc des liens depuis des pages à faible out-degree, elles-mêmes proches de sites d’autorité, plutôt que des listes de liens massives. Et par construction, l’impact est direct (distance de vos backlinks) ET indirect (la distance de vos référents compte aussi). Nuance : le brevet ne dit pas quelles seeds Google utilise ni le poids réel de ce signal aujourd’hui, donc on garde l’esprit critique.
Exemple : Vous hésitez entre un lien en page « ressources » d’un site de référence avec 150 liens sortants, et un lien éditorial dans un article d’un média sectoriel qui n’en contient que 5 : le second raccourcit nettement votre distance au graphe de confiance, surtout si ce média est lui-même cité par plusieurs sites d’autorité différents.
Thèmes : Positionnement, Backlinks, Maillage interne, Intention de recherche · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Detecting spam documents in a phrase based information retrieval system
US-7603345-B2 · déposé le 28 juin 2006, délivré le 13 octobre 2009
Inventeur : Anna Lynn Patterson
Prolongé par la continuation US-8078629-B2 (13 décembre 2011)
Ce brevet décrit un moteur qui indexe par phrases (groupes de mots porteurs de sens) et repère celles qui en annoncent d’autres : « voiture électrique » et « borne de recharge » qui vont ensemble, par exemple. Il en tire un filtre anti-spam : on compte combien de phrases liées apparaissent dans un document, on compare à ce qui est normal sur le corpus (une médiane, un écart-type…), et si c’est trop, la page est flaguée comme bourrage de mots-clés. Le document est alors inscrit sur une liste de spam, et son score de pertinence est rétrogradé à la requête. Ce qu’il faut retenir : ce n’est pas la répétition d’un mot qui pose problème, c’est un champ lexical trop complet, trop dense, par rapport à ce que font les pages naturelles du même sujet. À noter qu’on parle d’un brevet, pas d’une confirmation de ce qui tourne aujourd’hui, donc nuance. Mais la logique est saine et elle éclaire bien la limite des outils de « sémantique à cocher ».
Un autre problème qui se pose dans les systèmes existants de recherche d’information est l’apparition de documents « spam ». Certaines pages spam sont des documents qui ont peu, voire aucun, contenu significatif, mais comprennent plutôt des collections de mots et d’expressions populaires, souvent des centaines ou même des milliers d’entre eux ; ces pages sont parfois appelées « pages de bourrage de mots-clés ».
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ne traitez pas la liste de termes liés d’un outil d’optimisation sémantique comme une checklist à remplir à 100 %. Le brevet suggère que le signal de risque est l’écart par rapport à la norme du corpus : dépasser nettement le nombre habituel de termes associés à votre sujet peut être lu comme du bourrage. Visez la couverture utile pour le lecteur plutôt que l’exhaustivité du champ lexical, et placez les termes liés là où ils servent le propos, pas en tas. Impact direct (risque de rétrogradation de la page) ET indirect (une rédaction naturelle protège aussi la lisibilité et la confiance).
Exemple : Sur une page « assurance auto jeune conducteur », injecter tous les termes d’un export d’outil (franchise, bonus-malus, tous risques, tiers, résiliation, comparateur…) dans des paragraphes artificiels peut dépasser le niveau habituel des pages concurrentes. Mieux vaut traiter à fond les 5 ou 6 notions qui répondent vraiment à l’intention et laisser le reste hors page ou sur une page dédiée.
Thèmes : Spam, Intention de recherche, Indexation, Positionnement · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Generating structured information
US-2006200478-A1 · demande de brevet déposée le 1er mars 2006
Inventeurs : Egon Pasztor et Daniel Egnor
Ce brevet décrit comment un annuaire local fabrique une fiche d’entreprise propre à partir de sources hétérogènes : fournisseurs de données commerciales, site de l’entreprise, sites d’annuaires. Pour faire simple, on récupère des phrases en vrac (« fermé le lundi », « ouvert lun-ven 9-5 »), on les normalise en clés/valeurs canoniques, on rattache chaque fait à la bonne entité, puis on compare les versions entre sources pour attribuer un niveau de confiance. Ce sont ces niveaux de confiance qui décident des faits affichés. À noter que le brevet parle d’un annuaire local et pas du ranking web classique : il faut donc le lire avec recul, sans en faire une loi du moteur. Mais le principe (la cohérence entre sources pèse sur ce qui est retenu) est un levier réel pour le SEO local, et pour le GEO aussi.
Construire un annuaire avec une fonctionnalité robuste est un processus complexe. Certains types d’informations, tels que les noms, adresses et numéros de téléphone des restaurants et d’autres entreprises au sein d’une ville, sont relativement faciles à obtenir.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qui est affiché dépend de l’accord entre sources, pas de ce que votre site dit tout seul. Concrètement, une info ambiguë ou contradictoire (horaires, adresse, moyens de paiement, parking, services) risque de perdre en confiance, voire de ne pas être normalisable du tout (le brevet admet que certaines clés ou valeurs passent à la trappe). Le travail stratégique : harmoniser vos données partout (site, annuaires, fournisseurs de données), utiliser des formulations simples et canoniques, et présenter vos faits en paires clé/valeur lisibles plutôt que noyés dans de la prose. Impact direct sur la fiabilité des faits retenus, et indirect sur la fréquence à laquelle ils sont repris dans des réponses générées.
Exemple : Votre site indique « ouvert du lundi au vendredi 9h-18h, samedi jusqu’à 17h » alors qu’un annuaire affiche « fermé le samedi » : le fait est en conflit et sa confiance baisse. Alignez toutes les sources sur la même formulation, avec un bloc horaires clair sur votre site, et le fait a de bien meilleures chances d’être retenu tel quel.
Thèmes : Données structurées, Crawl, SEO local, Entités et sémantique · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Brevets déposés en 2005
Ranking video articles
US-7933338-B1 · déposé le 10 novembre 2005, délivré le 26 avril 2011
Inventeurs : Shahid Choudhry, John Piscitello, Christopher Richard Uhlik et 6 autres
Prolongé par la continuation US-8189685-B1 (29 mai 2012)
Ce brevet décrit comment Google classe des « video articles » (des contenus vidéo reçus de diffuseurs ou d’autres fournisseurs) en combinant deux familles de signaux : les métadonnées intrinsèques (titre, sous-titre, description, texte associé) et des données extrinsèques (source de diffusion, période de diffusion, notes tierces, données utilisateur). Le score n’est pas qu’une affaire de correspondance textuelle : il mélange un signal d’importance indépendant de la requête (le PageRank, dans un mode de réalisation) et des signaux dépendants de la requête. Rien de spectaculaire, et c’est un brevet déposé il y a un moment, donc à prendre avec recul : il ne dit pas comment Google classe la vidéo aujourd’hui. Il reste utile parce qu’il confirme une logique de fond : pour la vidéo, le texte autour du fichier compte énormément, et il est indexé finement.
Cependant, ces applications de recherche ne fournissent aucune indication de l’emplacement des termes de recherche dans les fichiers graphiques ou vidéo. En outre, ces applications de recherche peuvent renvoyer des résultats de recherche peu fiables puisqu’il y a relativement peu de données pour classer ou évaluer les résultats de recherche en fonction du contenu des fichiers graphiques ou vidéo qui sont pertinents ou utiles pour l’utilisateur pour la requête de recherche et pour localiser les résultats de recherche en fonction du contenu des fichiers vidéo.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir c’est que la vidéo se classe d’abord sur ce qu’on sait d’elle en texte. Le brevet cite titre, description, texte associé, mais aussi sous-titres codés, transcription voix-vers-texte et OCR du texte à l’écran, rattachés à des repères temporels dans un index inversé (un index qui associe chaque mot aux endroits où il apparaît). Concrètement, fournir une transcription propre, des sous-titres, un titre et une description soignés nourrit directement ces signaux. Côté extrinsèque, la réputation de la source, les avis tiers et les données utilisateur jouent aussi (impact direct ET indirect) : la vidéo ne se joue pas qu’on-page. Autre point : l’affichage prévoit des indicateurs de position des termes dans la vidéo, donc le découpage en segments est stratégique. À noter que le brevet ne chiffre aucun poids : on ne sait pas quel signal pèse le plus.
Exemple : Vous publiez un tutoriel vidéo sur votre site : ajoutez une transcription complète et des sous-titres, un titre explicite, une description qui reprend les sujets abordés, et découpez en chapitres. Le contenu parlé devient ainsi interrogeable segment par segment, au lieu de dépendre d’un simple nom de fichier.
Thèmes : Positionnement, Images et vidéos, Expérience utilisateur, Entités et sémantique · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Agent rank
US-7565358-B2 · déposé le 8 août 2005, délivré le 21 juillet 2009
Inventeurs : David Minogue et Paul A. Tucker
Prolongé par la continuation US-8224826-B2 (17 juillet 2012)
Agent Rank, c’est l’idée de noter les auteurs (les « agents ») plutôt que les pages. Chaque contenu est signé numériquement, la signature relie le contenu à une identité, et la réputation de cette identité se calcule façon PageRank : une référence venant d’un agent bien noté pèse plus lourd qu’une référence venant d’un agent faible. Le brevet décrit aussi des scores par thématique, et une réputation « difficile à monter, facile à perdre ». Ça ne prouve pas que Google l’applique tel quel aujourd’hui (je ne vais pas vous vendre ça comme un fait). Mais comme grille de lecture de l’E-E-A-T, de l’autorité d’auteur et de la logique d’entités, c’est un document précieux.
En général, cependant, il est difficile de faire correspondre le contenu sur une source d’information avec les agents responsables de la création ou de la publication de ce contenu. Par exemple, un auteur individuel peut contribuer du contenu à plusieurs sources d’information, le contenu au sein d’une seule source d’information peut provenir de plusieurs agents, ou la propriété et le contrôle des sources d’information peuvent changer au fil du temps.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir : l’autorité peut se rattacher à une personne identifiable, pas seulement à un domaine. Dans la logique du brevet, l’impact est direct ET indirect : votre contenu signé compte, et les références qu’il reçoit d’autres signataires crédibles comptent encore plus. Côté actionnable, il faut des auteurs clairement identifiés et cohérents d’une page à l’autre (bio, pages auteur, balisage Person/author), cantonnés à leurs sujets d’expertise puisque la réputation est contextuelle, et cités par des sources elles-mêmes reconnues. Autre point, la réputation se perd plus vite qu’elle ne se gagne : signer un contenu faible, c’est un déséquilibre risqué pour l’auteur. À noter aussi que le brevet isole le contenu signé du reste de la page (pubs, commentaires), donc la qualité se juge à la pièce, pas seulement au gabarit.
Exemple : Un site de santé fait signer ses articles par des professionnels réels, avec une page auteur et un balisage cohérent, plutôt que par « La rédaction ». Si ces auteurs sont cités par d’autres experts du même domaine, leur réputation thématique grimpe, et elle profite à chaque nouvel article qu’ils signent sur ce sujet.
Thèmes : Backlinks, Autorité, Knowledge Graph, Positionnement · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Deriving and using document and site quality signals from search query streams
US-7962462-B1 · déposé le 31 mai 2005, délivré le 14 juin 2011
Inventeurs : John Lamping et Mark Pearson
Ce brevet décrit un signal de qualité tiré des flux de requêtes. Quand une requête « demande » clairement un document (le texte de la requête colle au titre, à l’URL, au texte saillant ou aux ancres des liens entrants qui pointent majoritairement vers lui), ou quand une majorité d’utilisateurs choisit le même résultat pour la même requête, le document reçoit des points. Ces points ne sont pas le classement final. Ils servent de facteur de qualité dans les recherches suivantes, y compris sur d’autres requêtes, donc un signal plutôt global. À noter : les points sont plafonnés (par document, par utilisateur, par adresse réseau, par requête, sur une période donnée), ce qui limite le gaming. Ce qu’il faut retenir : la requête de marque ou de navigation, celle où l’internaute sait déjà ce qu’il cherche, vaut vote de qualité, et c’est cette demande-là qui nourrit le signal.
Le but du moteur de recherche est de fournir à l’utilisateur des liens vers des résultats pertinents de haute qualité, sur la base de la requête de recherche. Typiquement, le moteur de recherche accomplit cela en faisant correspondre les termes de la requête de recherche à un corpus de documents web préstockés.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Travaillez la correspondance entre les requêtes que vous visez et ce qui désigne votre page : titre, URL, texte saillant, et surtout ancres entrantes cohérentes qui pointent vers une seule page cible plutôt qu’éparpillées sur plusieurs. Un déséquilibre net en faveur d’une page, avec une majorité de liens et de clics sur elle, déclenche le signal. À l’inverse, des pages concurrentes sur la même intention diluent ce vote et risquent de ne produire aucune majorité, donc zéro point. Côté effet indirect : bâtir de la demande de marque et de la notoriété rend vos requêtes « nommantes », et le bénéfice peut se diffuser à d’autres requêtes. Ne comptez pas sur la triche : les plafonds par utilisateur et par adresse réseau sont faits pour ça. Et gardez l’esprit critique : le brevet décrit un mécanisme, pas son poids réel dans le classement actuel.
Exemple : Vous avez trois articles qui se disputent « audit SEO technique » et des ancres entrantes qui se répartissent entre eux : aucune majorité, aucun point. Vous consolidez sur une seule page (titre, URL et ancres alignés), puis vous faites pointer vos liens internes et vos mentions externes vers elle. La page devient celle que la requête désigne, et elle peut capter ce signal de qualité.
Thèmes : Backlinks, Expérience utilisateur, Positionnement, Analytics · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Methods and systems for identifying paraphrases from an index of information items and associated sentence fragments
US-7937396-B1 · déposé le 23 mars 2005, délivré le 3 mai 2011
Inventeurs : Alexandru Marius Pasca et Peter Szabolcs Dienes
Prolongé par la continuation US-8290963-B1 (16 octobre 2012)
Ce brevet décrit comment un moteur peut fabriquer tout seul sa liste de paraphrases, sans qu’on lui en fournisse une. Le principe : si deux fragments de phrase pointent vers la même date, la même entité ou le même concept, alors leurs formulations différentes disent probablement la même chose. Pour faire simple, « Soviet troops pulled out of Afghanistan » et « Soviet troops withdrew from Afghanistan » sont alignés, et ce qui diffère (« pulled out of » / « withdrew from ») devient une paire de paraphrases. Ce n’est pas un signal de ranking, c’est de la compréhension du langage. Mais mécaniquement, ça explique pourquoi vous n’avez pas besoin de répéter le mot-clé exact pour qu’une page soit jugée pertinente.
Des mots et des expressions différents peuvent être utilisés dans des documents et des requêtes de recherche qui ont la même signification ou une signification similaire. De tels mots et phases peuvent être appelés paraphrases. Les paraphrases identifiées ou connues peuvent être utiles dans la synthèse de documents, la recherche d’information et l’extraction d’information.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : L’ancrage sur l’entité (ou la date, ou le concept) compte plus que la formulation exacte. Le moteur apprend que deux tournures désignent la même chose quand elles reviennent souvent autour de la même entité, et il ne retient que les paires fréquentes (seuil de fréquence). Concrètement : écrivez naturellement, avec les variantes que les gens utilisent vraiment, et collez-les clairement à l’entité visée. Inutile de bourrer une page d’une seule expression, c’est contre-productif. Et si vous couvrez une entité avec des formulations courantes, plutôt que des tournures rares ou inventées, vous restez dans ce que ce type de mécanisme sait relier. À noter que le brevet ne dit pas comment ces paraphrases pèsent dans le classement, il parle de résumé, de recherche et d’extraction d’information. Le levier est donc indirect, mais réel.
Exemple : Vous rédigez une page sur le retrait d’un logiciel du marché : mêlez « retirer », « abandonner », « mettre fin à » autour du nom du produit, au lieu de marteler un seul verbe. Une requête formulée avec n’importe laquelle de ces variantes a alors plus de chances de retomber sur votre page, parce que le moteur a déjà appris que ces tournures vont ensemble.
Thèmes : Embeddings, Entités et sémantique, Indexation, Intention de recherche · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Brevets déposés en 2004
Systems and methods for correlating document topicality and popularity
US-8595225-B1 · déposé le 30 septembre 2004, délivré le 26 novembre 2013
Inventeurs : Amit Singhal et Urs Hoelzle
Ce brevet décrit un signal de popularité qui n’est pas global : chaque document est comparé uniquement aux autres documents de sa thématique. Les signaux d’usage cités sont le nombre de visites, d’accès, les parcours de navigation vers ou depuis la page, ou les accès d’un groupe d’utilisateurs précis. Au moment de la requête, le moteur infère le sujet de la requête, fait un premier classement par pertinence, puis réordonne avec cette popularité « par sujet ». Ce qu’il faut retenir : une page n’a pas à écraser les géants du web pour compter, elle doit être populaire dans son couloir thématique. Reste à garder la nuance : le texte ne chiffre rien et ne dit pas le poids de ce second classement, qui ressemble plus à un affinage qu’à un levier massif.
Un système reçoit des identifiants d’emplacement associés à des documents visités par un ou plusieurs utilisateurs. Le système récupère les documents en utilisant les identifiants d’emplacement reçus et associe les documents récupérés à un ou plusieurs sujets. Le système détermine une valeur de popularité associée aux documents récupérés et corrèle la valeur de popularité avec le ou les sujets afin de déterminer une popularité par sujet pour les documents récupérés.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le déséquilibre entre petits et gros sites est en partie neutralisé par le cloisonnement thématique. Votre cible stratégique devient donc la popularité relative dans une thématique bien délimitée, pas la notoriété globale. Concrètement, cela plaide pour un site clair sur son sujet (pour que la page soit rattachée sans ambiguïté à un topic), pour du contenu qui génère des visites et de la navigation entrante et sortante cohérente, et pour une analyse de la concurrence faite à l’intérieur du cluster thématique plutôt que contre tout le web. Impact direct : le réordonnancement des résultats sur les requêtes du sujet. Impact indirect : la qualité de la navigation interne, puisque les parcours de et vers la page font partie des signaux cités.
Exemple : Un petit site spécialisé en jardinage bio peut passer devant un gros média généraliste sur une requête de jardinage, si ses pages attirent plus de visites et de navigation que les autres pages du même sujet. Le média, lui, garde son poids global, mais ce poids ne pèse plus sur ce sujet précis.
Thèmes : Positionnement, Expérience utilisateur, Intention de recherche, Entités et sémantique · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Phrase-based searching in an information retrieval system
US-2006031195-A1 · demande de brevet déposée le 26 juillet 2004
Inventeur : Anna L. Patterson
Ce brevet décrit une recherche qui ne raisonne pas seulement en mots isolés mais en phrases (des séquences de mots qui forment un concept), et qui s’appuie sur les phrases « associées » pour sélectionner et classer les documents. Une phrase associée, c’est une expression qui apparaît ensemble avec une autre bien plus souvent que le hasard ne le prévoirait (le brevet mesure ça par un rapport entre co-occurrence réelle et co-occurrence attendue). Pour faire simple : un document qui contient la phrase demandée ET le bon cortège de phrases voisines remonte plus haut, et les phrases les plus informatives pèsent le plus lourd dans le score. Ce brevet est ancien dans sa logique, mais il donne un cadre de pensée très concret pour la couverture sémantique d’un contenu. À noter que je m’en tiens à ce que le texte décrit : ça ne dit pas comment Google fonctionne aujourd’hui, seulement ce que ce mécanisme impliquait.
La correspondance directe « booléenne » des termes de requête a des limitations bien connues, et en particulier n’identifie pas les documents qui ne contiennent pas les termes de requête, mais qui ont des mots apparentés. Par exemple, dans un système booléen typique, une recherche sur « Australian Shepherds » ne renverrait pas de documents sur d’autres chiens de berger tels que les Border Collies qui ne contiennent pas les termes exacts de la requête.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Travaillez la pertinence d’une page par le champ lexical qui accompagne naturellement l’expression cible, pas par la répétition de cette expression. Identifiez les phrases qui cooccurrent de façon anormalement fréquente avec votre sujet dans les contenus qui performent, et intégrez celles qui sont réellement informatives (pas les génériques). Le déséquilibre se joue là : une page qui répète le mot-clé sans son entourage conceptuel passe à côté du signal. Autre effet, indirect : le brevet utilise les phrases pour fabriquer les descriptions (les phrases qui contiennent le plus de phrases de la requête et de phrases associées sont choisies) et pour dédoublonner. Des paragraphes denses en vocabulaire pertinent et autonomes ont donc plus de chances de servir d’extrait, et des pages quasi identiques risquent l’élimination de l’index ou des résultats.
Exemple : Sur une page « chaussures de trail », ne vous contentez pas de répéter l’expression : couvrez ce qui l’accompagne vraiment quand on en parle (adhérence, drop, amorti, terrain technique, etc.), dans des phrases qui répondent à la question posée. La page devient à la fois mieux classée sur le concept et plus facile à extraire comme description.
Thèmes : Intention de recherche, Positionnement, Contenu dupliqué, Embeddings · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Determining quality of linked documents
US-7783639-B1 · déposé le 30 juin 2004, délivré le 24 août 2010
Inventeurs : Krishna Bharat, Amit Singhal et Paul Haahr
Prolongé par la continuation US-8176056-B1 (8 mai 2012)
Ce brevet décrit un PageRank « corrigé » de l’affiliation : Google repère les documents qui appartiennent à une même entité (structure du graphe de liens, trafic, noms d’hôte proches, adresses IP proches) et refuse de laisser leurs liens s’additionner à l’infini. Plus l’affiliation est forte, plus le groupe se comporte comme un seul vote (le maximum). Plus elle est faible, plus les votes se cumulent (la somme). Pour un SEO, ça compte parce que ça remet à leur place les stratégies de volume : dix liens issus d’une même sphère de contrôle ne valent pas dix fois un lien. À noter que c’est un brevet ancien et qu’on ne sait pas ce qui en reste tel quel aujourd’hui. Le principe de fond (diversité des sources, dilution par les liens sortants), lui, reste très utile pour arbitrer un budget netlinking.
Il peut être souhaitable de trier les résultats renvoyés par le moteur de recherche sur la base d’une certaine mesure objective de la qualité des résultats. Déterminer une métrique de qualité appropriée pour un document tel qu’une page Web peut être une tâche difficile.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Visez la diversité des entités qui vous citent plutôt que le nombre de liens. Plusieurs liens depuis des sites d’une même famille (mêmes IP, hostnames voisins, réseau interne, satellites) risquent d’être comptés comme un seul vote, donc le déséquilibre entre volume et valeur réelle joue contre vous. Un lien depuis une page qui n’en fait que quelques-uns pèse aussi plus que depuis une page qui en distribue des dizaines, puisque la contribution est divisée par le nombre de liens sortants. Côté maillage et audit de backlinks, regroupez mentalement vos liens par entité et jugez la valeur par groupe, pas en brut.
Exemple : Vous avez 30 backlinks, dont 20 viennent de cinq sites hébergés sur le même bloc d’IP et appartenant au même éditeur. Ces 20 liens pèsent probablement comme un ou quelques votes, pas vingt. Mieux vaut investir dans trois citations de sites indépendants, placées sur des pages qui font peu de liens sortants.
Thèmes : Positionnement, Backlinks, Maillage interne, Analytics · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Ranking documents based on user behavior and/or feature data
US-7716225-B1 · déposé le 17 juin 2004, délivré le 11 mai 2010
Inventeurs : Jeffrey A. Dean, Corin Anderson et Alexis Battle
Prolongé par la continuation US-8117209-B1 (14 février 2012)
Ce brevet, c’est le fameux « reasonable surfer » (le surfeur raisonnable). Pour faire simple : Google arrête de partir du principe que tous les liens d’une page se valent, et apprend à estimer la probabilité qu’un internaute clique réellement sur chacun. Cette probabilité devient un poids, et le rang du document cible dépend mécaniquement du poids des liens qui pointent vers lui. Ce qu’il faut retenir, c’est qu’un lien n’a pas la même valeur selon où il est, comment il est présenté et ce qu’il dit. Voilà un brevet qui change concrètement la façon d’évaluer un lien, que ce soit pour du netlinking ou du maillage interne.
Un système génère un modèle basé sur des données de caractéristiques relatives à différentes caractéristiques d’un lien d’un document de liaison vers un document lié et sur des données de comportement utilisateur relatives à des actions de navigation associées au lien. Le système attribue également un rang à un document basé sur le modèle.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Arrêtez de compter les liens comme des unités équivalentes. Le brevet cite des critères de position dans la page (et dans une liste), de taille de police, de couleur, de nombre de mots dans l’ancre, de lien image ou texte, de mots autour du lien, de proximité thématique entre la page source et la cible, et de même domaine ou non. Il cite aussi la quantité de liens présents dans la page source. Un lien en footer ou dans les « CGU » est appris comme peu cliqué, donc peu pondéré. Un lien contextuel, visible et pertinent pour le sujet a de bien meilleures chances de peser. Côté netlinking, jugez la probabilité de clic réelle du lien, pas seulement l’autorité de la page. Côté maillage interne, placez vos liens stratégiques dans le corps du contenu, avec une ancre claire et thématiquement cohérente, plutôt que dans un bloc de navigation ou un pied de page. À noter : le brevet décrit une logique et des critères, pas des pondérations chiffrées. Inutile donc de vouloir « optimiser au pixel près ».
Exemple : Vous hésitez entre un lien dans un article éditorial, en plein paragraphe et sur un sujet proche du vôtre, et un lien dans une liste de partenaires en bas de page d’un site généraliste. Le premier a mécaniquement bien plus de chances d’être cliqué, donc d’être bien pondéré. Pareil en interne : votre page money gagne à être liée depuis le corps de vos articles liés thématiquement, pas seulement depuis le footer.
Thèmes : Positionnement, Expérience utilisateur, Backlinks, Intention de recherche · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Brevets déposés en 2003
Information retrieval based on historical data
US-7346839-B2 · déposé le 31 décembre 2003, délivré le 18 mars 2008
Inventeurs : Anurag Acharya, Matt Cutts, Jeffrey Dean et 7 autres
Ce brevet, c’est le fameux « Historical data » de Google : au lieu de juger une page sur un instantané, le moteur regarde comment elle vit dans le temps. Âge du document, fréquence et ampleur des modifications, apparition et disparition des backlinks, évolution de l’ancre, clics, dwell time (le temps passé avant de revenir aux résultats), historique de position… Tout ça sert à moduler le score de pertinence, pas à le remplacer. Pour faire simple : le temps devient un signal à part entière. Ce n’est pas un seul levier, c’est un faisceau. À noter que le brevet décrit des possibilités, pas des pondérations confirmées : on n’a ni seuils ni poids, donc à manier avec esprit critique.
Les deux catégories de moteurs de recherche s’efforcent de fournir des résultats de haute qualité pour une requête de recherche. Il existe plusieurs facteurs qui peuvent affecter la qualité des résultats générés par un moteur de recherche. Par exemple, certains producteurs de sites web utilisent des techniques de spam pour gonfler artificiellement leur classement.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Trois chantiers stratégiques en découlent. 1) La fraîcheur n’est pas un absolu : elle dépend de la requête. Le brevet compare l’âge d’un document à celui du reste du jeu de résultats et prévoit même que des documents anciens soient favorisés quand l’historique de clics le suggère. Inutile donc de rafraîchir à tout prix : mieux vaut modifier là où ça compte (et pondérer par l’importance des passages modifiés, pas par un simple changement de date). 2) Les liens sont jugés dans la durée : longévité, âge, croissance de domaines indépendants qui vous citent, fraîcheur de la page qui lie. Un lien éphémère ou une page source abandonnée pèse moins qu’un lien durable, sur une page qui reste vivante. Impact direct sur le score, indirect sur votre stratégie de netlinking. 3) Les signaux de comportement et de légitimité comptent aussi : taux de sélection dans les SERP, dwell time, saisonnalité, et côté domaine, données d’expiration, DNS, name-servers. Un changement brutal de thématique ou une croissance d’ancres artificielle crée un déséquilibre visible dans l’historique.
Exemple : Vous gérez un guide de référence qui marche bien : plutôt que de le republier en changeant la date, vous mettez à jour les sections importantes, vous conservez l’URL (donc l’historique) et vous suivez l’évolution des domaines référents sur la durée. À l’inverse, une campagne d’ancres identiques obtenues d’un coup, sur des pages qui ne bougent plus, risque d’envoyer un signal de croissance peu naturel.
Thèmes : Fraîcheur du contenu, Positionnement, Backlinks, Intention de recherche · Intérêt SEO : 8/10 · Lire le brevet sur Google Patents
Limiting requests by web crawlers to a web host
US-7774782-B1 · déposé le 18 décembre 2003, délivré le 10 août 2010
Inventeurs : Catalin T. Popescu et Anurag Acharya
Ce brevet décrit comment Google répartit la charge qu’un site peut encaisser entre ses différents crawlers (principal, news, images…). Chaque crawler obtient un « bail » (lease) : une part de requêtes par unité de temps, limitée dans la durée, renouvelée ou rendue au pot commun. Ce n’est pas un signal de ranking, soyons clairs. Mais ça confirme que le crawl budget est un partage d’une capacité finie, avec des priorités entre crawlers, et pas un robinet infini. Le levier est indirect, mais réel pour les gros sites.
Lorsque les demandes simultanées de capacité de charge provenant de divers robots d’exploration du Web dépassent la capacité de charge maximale qu’un hôte Web peut fournir, il est presque certain que certains des robots d’exploration du Web en concurrence recevront un service lent de la part de l’hôte Web, et certaines requêtes peuvent même échouer. Un tel phénomène est parfois appelé « famine de capacité de charge » pour un robot d’exploration du Web.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : La capacité d’un hôte est plafonnée (un nombre maximal de requêtes par unité de temps) et se répartit entre plusieurs crawlers concurrents, pondérés par une priorité. Si votre serveur est lent ou fragile, la part disponible fond, et les URLs à crawler attendent leur tour : retards de téléchargement, index périmé. Le plafond peut aussi s’appliquer à un groupe d’hôtes partageant la même adresse IP. Vos sous-domaines ou sites mutualisés sur une même IP se disputent donc potentiellement le même budget. Ce qu’il faut retenir : chaque requête gaspillée (paramètres, doublons, redirections en chaîne) est une part de capacité qui n’ira pas à une page utile. Et l’impact est direct ET indirect : le crawl d’abord, la fraîcheur de l’index ensuite. À noter que le brevet ne dit rien sur la façon dont le plafond est fixé côté site : je ne vais pas vous inventer un réglage.
Exemple : Vous avez un site média, un sous-domaine d’images et un blog sur la même IP, avec une grosse part d’URLs à facettes inutiles. Nettoyer ces URLs et soigner le temps de réponse libère de la capacité pour que les crawlers news et principal repassent plus vite sur vos contenus frais.
Thèmes : Crawl, Positionnement, Outils SEO, Intention de recherche · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Information extraction from a database
US-7650330-B1 · déposé le 15 décembre 2003, délivré le 19 janvier 2010
Inventeur : Sergey Brin
Continuation du brevet US-6678681-B1
Ce brevet, c’est la méthode DIPRE (Dual Iterative Pattern Relation Extraction) en version continuation. On part de quelques exemples (par exemple des couples auteur/titre), on repère les pages qui les contiennent, on en déduit le gabarit de texte qui entoure ces données (le texte avant, entre ou après les champs), puis on s’en sert pour aspirer d’autres couples sur le reste du corpus. Pour faire simple : Google apprend à lire des listes à partir de quelques échantillons. Ce n’est pas un signal de ranking, et je n’ai pas de preuve dans le texte qu’il tourne tel quel en production. En revanche, ça éclaire la façon dont des faits et des entités peuvent être extraits de pages web, y compris en HTML brut. Le levier est donc indirect et ténu, mais il existe.
L’Internet, et plus particulièrement le World Wide Web (« Web »), est un vaste réservoir d’informations extrêmement distribué, tant dans l’emplacement que dans la manière dont l’information est stockée. Par exemple, un type particulier de données tel que des listes de restaurants peut être dispersé sur des milliers de sources d’information indépendantes (par exemple, des hôtes) dans de nombreux formats différents.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qui compte, c’est la régularité de vos gabarits. Si vos pages présentent une donnée (prix, date, auteur, caractéristique) toujours avec le même contexte textuel et la même structure HTML, un système de ce type a beaucoup plus de chances de la retrouver et de la rattacher à la bonne entité. À l’inverse, un gabarit incohérent d’une page à l’autre brouille le motif. Il faut donc soigner la cohérence éditoriale et HTML des listes, fiches et tableaux (impact direct sur l’extraction, indirect sur la compréhension de votre site). À noter que ça ne remplace pas les données structurées : c’est un filet de sécurité quand elles manquent, pas une raison de les abandonner.
Exemple : Vous gérez un annuaire de 300 fiches produits. Si chacune affiche « Marque : X – Référence : Y » avec le même balisage, un motif appris sur quelques fiches se généralise proprement aux autres. Si la moitié des fiches inverse l’ordre ou change les libellés, le gabarit ne tient plus et des données passent à la trappe.
Thèmes : Intention de recherche, Embeddings, Questions-réponses, Query fan-out · Intérêt SEO : 5/10 · Lire le brevet sur Google Patents
Duplicate document detection in a web crawler system
US-7627613-B1 · déposé le 3 juillet 2003, délivré le 1er décembre 2009
Inventeurs : Daniel Dulitz, Alexandre A. Verstak, Sanjay Ghemawat et 1 autre
Ce brevet décrit comment le crawler de Google écarte les doublons avant même l’indexation. Chaque page reçoit une empreinte (fingerprint, une sorte de code-barres de longueur fixe calculé sur le contenu). Les pages qui partagent la même empreinte forment un groupe de doublons, et un seul représentant est retenu, choisi sur une métrique indépendante de la requête, le PageRank étant cité en exemple. Ce qu’il faut retenir : quand deux contenus identiques existent, le gagnant n’est pas forcément le premier publié ni le plus beau, c’est celui qui pèse le plus en autorité. À noter que c’est un brevet ancien dans sa logique, donc à lire avec recul : il ne dit pas comment Google fait aujourd’hui, mais il pose une logique de canonicalisation encore très parlante.
Par exemple, dans le back-end d’un moteur de recherche, si des copies en double d’un même document sont traitées comme des documents différents non liés les uns aux autres en termes de leur contenu, cela amènerait le moteur de recherche à gaspiller des ressources, telles que de l’espace disque, de la mémoire et/ou de la bande passante réseau, afin de traiter et de gérer les documents en double. Dans le front-end, la conservation de documents en double obligerait le moteur de recherche à parcourir de grands index et à utiliser davantage de puissance de traitement pour traiter les requêtes.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Si votre contenu existe en plusieurs exemplaires (variantes d’URL, paramètres, versions http/https, syndication, pages quasi clonées), vous mettez vos propres pages en concurrence, et c’est la mieux dotée en autorité qui est indexée, pas forcément celle que vous voulez. Le déséquilibre se joue donc avant le ranking : la page écartée n’est tout simplement pas indexée. L’impact est direct (page absente de l’index) ET indirect (budget de crawl, stockage et fraîcheur gaspillés sur des copies). Le brevet mentionne aussi les redirections permanentes, utilisées pour remplacer les empreintes des liens sortants par celles des URL cibles : une 301 propre aide à consolider, et un doublon de contenu mal géré dilue. Le levier : réduire les doublons à la source (redirections, canonicals cohérents, liens internes vers la version voulue) plutôt que de laisser Google arbitrer à votre place. Un bémol d’esprit critique : le brevet parle d’identité de contenu par empreinte, donc il vise des doublons stricts, pas le quasi-duplicate ni la réécriture sémantique.
Exemple : Une fiche produit accessible via /produit, /produit?ref=newsletter et une version syndiquée chez un partenaire plus autoritaire : si le contenu est identique, c’est la version la plus forte en autorité qui risque de devenir le représentant indexé, donc potentiellement celle du partenaire. En redirigeant et en canonicalisant vos variantes vers une seule URL, et en différenciant le contenu syndiqué, vous évitez de perdre cet arbitrage.
Thèmes : Contenu dupliqué, Crawl, Indexation, Positionnement · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Anchor tag indexing in a web crawler system
US-7308643-B1 · déposé le 3 juillet 2003, délivré le 11 décembre 2007
Inventeurs : Huican Zhu, Jeffrey Dean, Sanjay Ghemawat et 2 autres
Ce brevet décrit comment le crawler transforme les liens sortants des pages en une « anchor map », un index trié par page cible. Chaque page cible y récupère le texte autour des liens qui pointent vers elle (dans une distance donnée de la balise ancre, avec ses attributs), et ces termes sont ajoutés à son index. Pour faire simple : une page est aussi décrite par ce que les autres en disent, pas seulement par son propre contenu. Le reste du brevet (couches de maps triées, fusions, entrées de suppression) relève de la plomberie interne, sans levier direct. Ce qu’il faut retenir, c’est que l’ancre et son contexte immédiat comptent comme matière d’indexation, avec un impact direct ET indirect. À noter : c’est un brevet ancien dans un contexte de crawler. Il confirme un principe, il ne dit rien de la pondération actuelle.
Cependant, à mesure que le nombre de documents sur Internet croît, il faut des périodes de temps de plus en plus longues entre le moment où une page est explorée par un robot et le moment où elle peut être indexée et mise à la disposition d’un moteur de recherche. En outre, il faut des périodes de temps de plus en plus longues pour remplacer ou mettre à jour une page une fois qu’elle a été indexée.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Le texte d’ancre et les mots autour du lien alimentent l’index de la page cible, y compris avant son crawl ou quand elle a peu de texte (images, vidéos, pages pauvres). Votre netlinking et votre maillage interne servent donc aussi à décrire vos pages, pas seulement à transmettre du poids. Soignez la pertinence de l’ancre ET de la phrase qui l’entoure. Et quand un lien est supprimé, la page source disparaît de la liste des liens entrants de la cible, donc un lien retiré perd aussi son apport descriptif.
Exemple : Une page catégorie quasi vide en texte, mais ciblée par des liens internes et externes dont la phrase environnante décrit précisément son sujet, récupère ces termes dans son index. À l’inverse, des ancres génériques du type « cliquez ici », noyées dans un paragraphe hors sujet, n’apportent aucun terme utile à la cible.
Thèmes : Crawl, Indexation, Maillage interne, Intention de recherche · Intérêt SEO : 7/10 · Lire le brevet sur Google Patents
Brevet déposé en 2000
Information extraction from a database
US-6678681-B1 · déposé le 9 mars 2000, délivré le 13 janvier 2004
Inventeur : Sergey Brin
Prolongé par la continuation US-7650330-B1 (19 janvier 2010)
Ce brevet décrit une mécanique d’extraction de données structurées à partir du Web, la fameuse approche DIPRE (Dual Iterative Pattern Relation Expansion). Pour faire simple, on part de quelques exemples (par exemple des couples auteur/titre), on regarde dans quel contexte HTML et URL ils apparaissent, on en déduit un motif, puis ce motif sert à dénicher de nouveaux couples. Et on recommence. Ce n’est pas un signal de ranking, soyons clairs. Mais mécaniquement, ça éclaire la façon dont un système peut bâtir des bases de faits (entités, relations) à partir de pages non balisées, sans intervention humaine. Pour un SEO/GEO, le levier est indirect mais réel : plus vos pages sont régulières, plus elles sont « lisibles » par ce genre de moteur.
Une manière dont cette information est extraite du Web est par des utilisateurs individuels qui parcourent (« surfent ») le Web pour localiser des informations d’intérêt et extraire manuellement l’information. Il devrait être tout à fait évident que cette méthode est très fastidieuse et ne fournit pas facilement une recherche exhaustive.
Extrait du brevet, traduit de l’anglais (texte original)
Ce que ça change pour le SEO
Conséquence : Ce qu’il faut retenir c’est que l’extraction repose sur la répétition : un motif de balisage (texte avant, texte entre les champs, texte après) et une structure d’URL cohérente. Le brevet précise que les motifs sont validés par leur spécificité et par le nombre de tuples qui les confirment, et que les tuples douteux sont rejetés s’ils ne matchent pas plusieurs motifs. Donc : gabarits constants pour vos fiches (produits, auteurs, adresses, avis), mêmes délimiteurs et même ordre des champs d’une page à l’autre, URLs organisées en préfixes logiques par type de contenu. Vous facilitez l’extraction fiable de vos données, et vous réduisez le risque qu’elles soient écartées comme bruit. À noter : ça ne remplace pas les données structurées, ça les complète. Et le brevet ne dit pas que Google exploite ça tel quel aujourd’hui, donc on reste sur du raisonnement, pas sur une promesse.
Exemple : Vous gérez un site de critiques de livres : si chaque fiche affiche « Titre, de Auteur » avec la même structure HTML et une URL du type /livres/…, un motif simple suffit pour extraire proprement tous les couples titre/auteur. Si une moitié des pages inverse l’ordre et l’autre mélange les formats, vos données deviennent difficiles à confirmer par plusieurs motifs.
Thèmes : Crawl, Intention de recherche, Embeddings, Création de contenu · Intérêt SEO : 6/10 · Lire le brevet sur Google Patents
Un brevet, ça prouve quoi au juste ?
Bon, autant le dire tout de suite : un brevet n’est pas une preuve d’utilisation. Google dépose des idées qu’il n’exploitera peut-être jamais, et rien ne l’oblige à breveter ce qu’il utilise.
Ce qu’un brevet montre, en revanche, c’est la façon dont les ingénieurs de Google posent un problème : quels signaux ils envisagent, ce qu’ils cherchent à mesurer, ce qu’ils veulent éviter. Pour faire simple, c’est une fenêtre sur le raisonnement, pas sur l’algorithme en production.
Dans chaque fiche, il y a donc trois choses à ne pas confondre :
- Ce que dit le brevet : l’extrait cité, mot pour mot.
- Ce qu’on en déduit : la description, la conséquence et l’exemple, qui sont une lecture du brevet, pas une affirmation de Google.
- Ce qu’on ne sait pas : si le mécanisme tourne réellement dans le moteur, et avec quel poids.
D'où viennent ces données ?
Les brevets viennent de la base publique Google Patents. Ma veille y repère les brevets de Google qui touchent à la recherche, les note, et je valide à la main ceux qui méritent une fiche.
Les textes de chaque fiche (description, conséquence, exemple, note d’intérêt) sont rédigés par une IA à partir du texte du brevet : ce sont des lectures, à prendre comme telles. Les extraits, eux, sont copiés tels quels depuis le brevet, avec leur emplacement entre parenthèses.
Dernière limite, autant la dire : la sélection est la mienne. Cette page ne prétend pas lister tous les brevets de Google, seulement ceux qui éclairent le SEO et la visibilité dans les réponses d’IA.
Et pour ce que Google a réellement déployé, et quand, il y a l’historique des mises à jour de Google Search.
Questions fréquentes
Un brevet déposé par Google est-il forcément utilisé dans son moteur ?
Non. Un brevet protège une idée, il ne dit pas si elle est en production. Certains mécanismes décrits ici sont sans doute utilisés, d’autres jamais, et rien dans le brevet ne permet de trancher.
Quelle différence entre la date de dépôt et la date de délivrance ?
La date de dépôt est celle où Google soumet sa demande. La date de délivrance est celle où l’office américain des brevets l’accorde. Pour comprendre à quelle époque Google travaillait sur un sujet, c’est la date de dépôt qui compte ; le délai moyen entre les deux, sur les brevets de cette page, est affiché en haut.
C'est quoi, une continuation ?
Une continuation reprend la description d’un brevet déjà déposé et en change les revendications, c’est-à-dire ce qui est précisément protégé. Quand Google en dépose une des années après le brevet d’origine, on peut y voir le signe que le sujet l’intéresse toujours.

Consultant SEO / GEO spécialisé en audits SEO avancés, stratégie de contenu automatisé et optimisé (avec relecture humaine), création d’outils sur mesures, analyse des brevets et algorithmes Google liés au SEO et à la recherche générative et domaines impactant le SEO: UX, social media, autorité de la marque, …
Classement des pages par Google: comprendre son algorithme

Quelques actions SEO que vous devez éviter en 2015
Le SEO n’arrête pas de progresser, Google met à jour son algorithme des centaines de fois par an. Beaucoup de...
Brevets Google : la liste commentée des brevets du moteur de recherche
La liste commentée des brevets de Google sur son moteur de recherche : dates, inventeurs, extraits d'origine et conséquences pour...
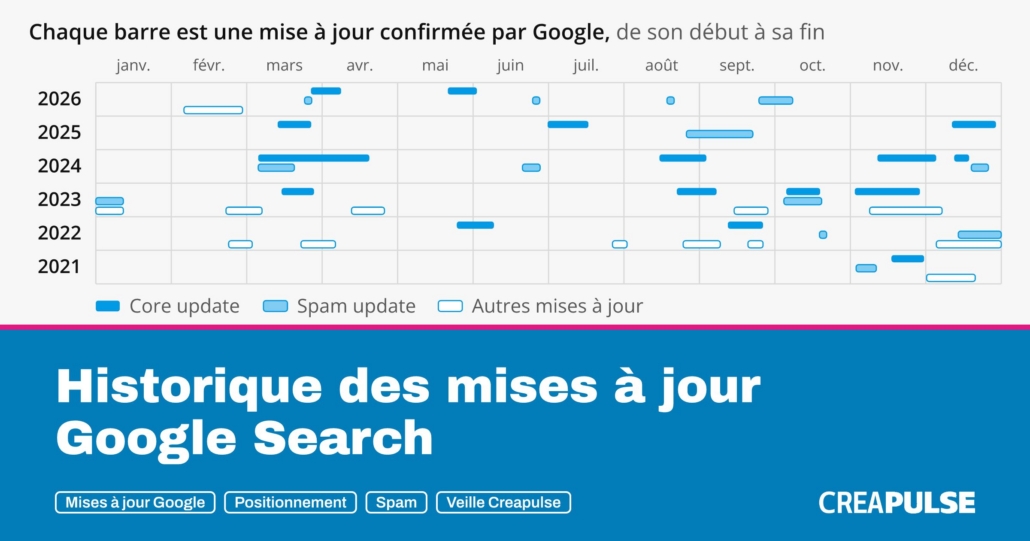
Historique des Mises à jour Google Search
La liste à jour des mises à jour de Google Search : core updates, spam updates, dates de début et...


Laisser un commentaire
Rejoindre la discussion?N’hésitez pas à contribuer !