Fanouts de ChatGPT: Une capture ne suffit pas
Ce qu’il faut retenir
- Les fanouts sont les sous-requêtes que ChatGPT lance quand il cherche sur le web. J’en ai capté 30 séries, sur 6 prompts SEO, le 12 octobre 2026.
- Sur 60 comparaisons entre deux runs du même prompt, une seule paire contient exactement les mêmes sous-requêtes.
- Sur un prompt commercial, 5 runs remontent 48 domaines différents, dont un seul commun aux cinq.
- 42 sous-requêtes sur 53 sont en anglais, pour des prompts posés en français.
- Derrière 24 formulations différentes, il n’y a que 3 intentions. C’est elles qu’il faut regarder.
Quand ChatGPT va chercher sur le web pour vous répondre, il ne tape pas votre question dans un moteur. Il la découpe en plusieurs sous-requêtes, qu’on appelle des fanouts, et c’est avec elles qu’il trouve les pages qu’il lit et qu’il cite. Voir ces fanouts, c’est voir ce que l’IA cherche vraiment.
J’ai voulu regarder ça de près sur des prompts SEO, et pas une fois : 30 fois, dans des conditions propres. Je vais tenter ici d’expliquer ce que j’ai vu, sachant que le sujet bouge vite (le format des données a changé entre le 1er et le 12 octobre, c’est dire). Comme à mon habitude, je vais vulgariser au maximum.
C’est quoi, un fanout ?
Pour faire simple : vous posez une question, le modèle la transforme en requêtes de recherche, il lit les résultats, puis il rédige sa réponse en citant quelques sources.
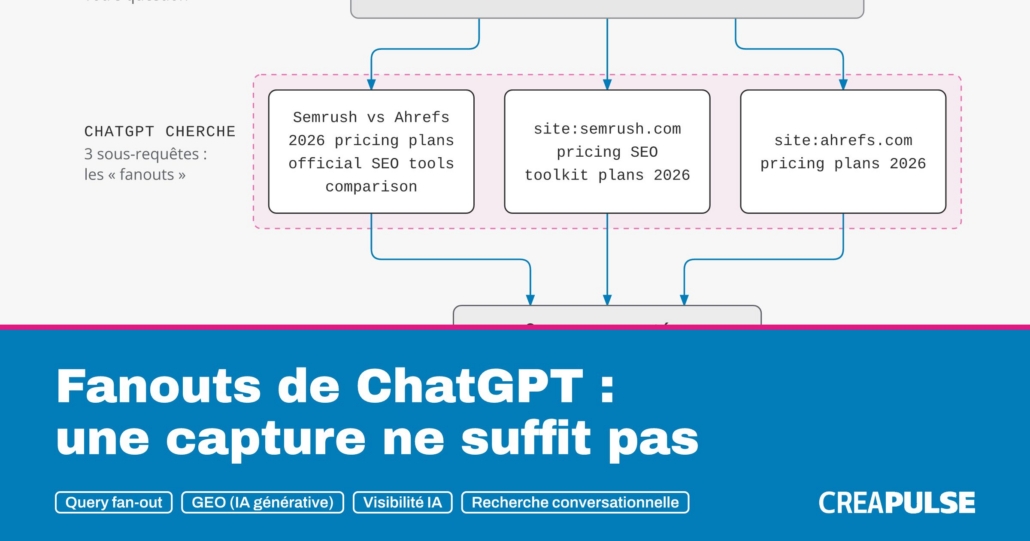
Un exemple réel. À la question « Semrush ou Ahrefs pour une PME française ? », ChatGPT a lancé ces trois recherches :
Semrush vs Ahrefs 2026 pricing plans official SEO tools comparisonsite:semrush.com pricing SEO toolkit plans 2026site:ahrefs.com pricing plans 2026
Vous me direz : il suffit de lui demander ce qu’il a cherché. J’ai essayé, six fois, juste après sa réponse. Il ne sait pas vous les redonner. Il répond qu’il n’a pas accès à l’historique de ses recherches, et c’est plutôt honnête de sa part : il n’a rien inventé. Mais du coup, il faut aller les chercher soi-même.
Comment on capte les fanouts de ChatGPT ?
Les sous-requêtes circulent dans les données que ChatGPT envoie à votre navigateur pendant qu’il répond. Il « suffit » de les lire au passage.
Deux façons de faire. La première, c’est l’extension Search & fan-out capture de RESONEO, gratuite, qui fait ça très bien. La seconde, c’est un petit script collé dans la console du navigateur. J’ai utilisé les deux sur les mêmes runs : 7 sous-requêtes sur 7 identiques. Et pour être honnête, leur capture est plus complète que mon script, qui avait raté une partie des pages remontées avant que je le corrige.
Reste à ne pas mesurer n’importe quoi. Mon protocole tient en quatre lignes :
- un chat temporaire en mode « Non personnalisé » ;
- un chat neuf à chaque run ;
- le même prompt, au caractère près ;
- le modèle réellement servi, noté à chaque fois.
À noter que le premier point est un piège. Par défaut, le chat temporaire de ChatGPT est « Personnalisé » : il lit votre mémoire et vos instructions. J’ai vérifié en posant la même question dans les deux modes : ChatGPT déclare avoir accès à 8 éléments de mémoire dans l’un, à 0 dans l’autre. Si vous mesurez en mode personnalisé, vous mesurez votre compte autant que le modèle.
Avec ça, j’ai lancé 6 prompts SEO, 5 fois chacun, le 12 octobre 2026 : le meilleur outil pour suivre sa visibilité dans les IA, Semrush ou Ahrefs, une agence SEO à Lyon, le prix d’un audit SEO, l’utilité du fichier llms.txt, et comment apparaître dans ChatGPT. Soit 30 runs et 53 sous-requêtes.
Le même prompt, cinq fois : qu’est-ce qui change ?
À peu près tout. Et à chaque étage.
Les requêtes
Sur les 60 comparaisons possibles entre deux runs d’un même prompt, une seule paire est identique. Sur 53 sous-requêtes, 49 formulations différentes.
Prenez le prix d’un audit SEO. Trois runs, trois recherches :
prix audit SEO France 2026 tarifs agence freelance audit technique sémantiqueprix audit SEO France 2026 tarif agence freelance audit technique éditorialprix audit SEO France tarifs agence consultant 2026
C’est la même idée, mais c’est jamais la même chaîne.
Les pages remontées
C’est là que ça se corse. Des requêtes presque identiques ne ramènent pas les mêmes résultats.
| Prompt | Domaines différents sur 5 runs | Communs aux 5 runs |
|---|---|---|
| Meilleur outil de visibilité IA | 48 | 1 |
| Utilité du fichier llms.txt | 50 | 2 |
| Apparaître dans ChatGPT | 29 | 3 |
| Semrush ou Ahrefs | 16 | 3 |
| Prix d’un audit SEO | 14 | 1 |
| Agence SEO à Lyon | 15 | 8 |
Sur le prompt commercial, le recouvrement moyen entre deux runs est de 11 %. Seul le prompt local est stable : à Lyon, 8 domaines reviennent à tous les coups.
Les sources citées
Être remonté ne veut pas dire être cité. À Lyon justement, 8 domaines sont présents dans les 5 runs… et aucun n’est cité dans les 5. Le plus régulier l’est 4 fois, le suivant 3.
Sur le prompt commercial, 21 domaines différents ont été cités au fil des 5 runs, aucun à chaque fois.
Les seules sources vraiment stables sont les sites officiels : la documentation d’OpenAI citée 5 fois sur 5 quand on demande comment apparaître dans ChatGPT, semrush.com et ahrefs.com 5 fois sur 5 sur le comparatif.
Une capture, c’est un tirage. Un peu comme un lancer de dés : vous voyez un résultat, pas la loi qui est derrière.
Qu’est-ce qu’une seule capture vous fait croire ?
J’ai fait le test avec l’extension de RESONEO : le même prompt (« Semrush ou Ahrefs pour une PME française ? »), capté deux fois à 45 secondes d’écart.
| Capture 1 | Capture 2 | En commun | |
|---|---|---|---|
| Sous-requêtes | 3 | 3 | 0 |
| Pages remontées | 33 | 34 | 16 |
| Domaines | 8 | 14 | 8 |
| Pages affichées en citation | 3 | 0 | 0 |
Avec la première capture, vous concluez que ChatGPT cite trois pages de Semrush et d’Ahrefs. Avec la seconde, qu’il n’en met aucune en avant. Les deux sont vraies. Les deux sont incomplètes.
La variabilité elle-même n’est pas la faute de l’outil, c’est mécanique : c’est ChatGPT qui se comporte comme ça. Le souci, c’est que rien ne vous le dit. Ni la page de présentation de l’extension ni son tableau de bord ne préviennent que deux captures du même prompt peuvent n’avoir aucune requête en commun. Vous regardez une capture, vous la prenez pour la réponse.
Ce que fait cette extension, et elle le fait bien, c’est lister : chaque conversation, ses requêtes, ses pages. Elle n’est pas pensée pour comparer plusieurs runs d’un même prompt. J’ai essayé quand même, en rangeant mes deux captures dans un projet (version 6.0.1). Les requêtes s’empilent dans une liste à plat, où trois formulations de la même idée comptent pour trois. Et le compteur du haut additionne au lieu de dédoublonner : 22 « domaines détectés » pour 14 réellement distincts. Il y a bien une colonne qui indique dans combien de conversations un domaine apparaît, mais rien qui dise, côté requêtes, ce qui revient et ce qui est un accident.
Ce qui ne change pas : les intentions
Bon, si tout bouge, on fait quoi ?
On regarde autrement. D’un run à l’autre, les sous-requêtes d’un même prompt partagent 55 à 78 % de leurs mots. Les formulations changent, le sujet cherché, lui, reste.
J’ai donc regroupé les sous-requêtes par intention : celles qui cherchent la même chose vont ensemble, quelle que soit leur formulation ou leur langue. Sur « Semrush ou Ahrefs », j’ai 10 runs (les 5 de la série, plus 5 runs de contrôle), qui ont produit 24 formulations différentes. Regroupées, ça donne ça :
| Ce que l’IA cherche | Formulations | Présent dans |
|---|---|---|
| Quels sont les tarifs de Semrush et d’Ahrefs ? | 14 | 10 runs sur 10 |
| Semrush ou Ahrefs : lequel choisir ? | 9 | 10 runs sur 10 |
| Quelles fonctionnalités propose Semrush ? | 1 | 1 run sur 10 |
24 lignes d’un côté, 3 de l’autre. Et surtout une information qu’une liste ne donne pas : les deux premières intentions sont là à chaque fois, la troisième est un accident.
Même chose sur le prompt commercial : 22 formulations, 5 intentions, dont une seule présente dans les 10 runs.
C’est ça, la donnée utile : les questions que l’IA se pose à tous les coups, celles qu’elle se pose une fois sur dix, et pas la formulation exacte du jour.
Qu’est-ce qu’on voit quand on regroupe ?
Trois choses, que je n’aurais pas vues sur une capture isolée.
Elle cherche souvent en anglais. 42 sous-requêtes sur 53 sont en anglais, pour des prompts posés en français. Le français n’apparaît que quand le prompt contient un ancrage géographique (« à Lyon », « en France »). Pourquoi ? Personne ne le sait vraiment : OpenAI ne documente pas le choix de la langue. Je ne suis pas le seul à le voir, Peec AI a mesuré la même chose en février 2026 sur plus de 10 millions de prompts : 43 % des fanouts de prompts non anglais partent en anglais. Attention à ne pas en tirer trop : la langue d’une sous-requête ne dit pas quelles sources l’IA retiendra.
Elle choisit ses marques avant de chercher. À la question du meilleur outil de visibilité IA, mon prompt ne cite aucun nom. Pourtant Profound, Peec et Otterly sont écrits dans les sous-requêtes de 4 runs sur 5. Le modèle sait déjà qui il va regarder. Si votre marque n’est pas dans ce lot, le problème n’est pas votre contenu, c’est votre notoriété.
Elle va parfois directement sur un site. Dans 3 runs sur 30, tous sur le prompt qui nomme deux marques, ChatGPT a utilisé l’opérateur site: pour aller lire la page de tarifs de chacune. Et ça, sans aucune personnalisation du compte.
Notre approche : répéter, regrouper, noter la fiabilité
Vous l’aurez compris, je ne crois plus à la capture unique. L’outil que j’ai construit part de trois principes :
- répéter : plusieurs passes par prompt, systématiquement ;
- regrouper : des intentions rédigées en clair, avec les sous-requêtes qui les composent ;
- noter la fiabilité : « présent dans 3 passes sur 3 » ne vaut pas « 1 sur 3 ».
| Une capture | Notre approche | |
|---|---|---|
| Ce que vous lisez | une liste de requêtes | des intentions |
| Les variantes d’une même idée | comptées séparément | regroupées |
| Ce qui est stable | impossible à dire | noté, passe par passe |
| Les marques et les sites visés | à repérer à l’œil | signalés |
Voici ce que sort le prototype sur « Semrush ou Ahrefs » : les tarifs d’Ahrefs et de Semrush dans 3 passes sur 3, le comparatif dans 2 sur 3, les données de mots-clés pour la France dans 1 sur 3. Avec un signal en plus : l’IA va lire directement ahrefs.com et semrush.com.
L’outil va un cran plus loin : il dit pour chaque intention si elle mérite une page dédiée ou une simple section, avec un titre appuyé sur ce que Google affiche déjà.
Conclusion
Ce qu’il faut retenir c’est que les fanouts de ChatGPT ne sont pas une liste à collectionner. Les requêtes changent à chaque run, les pages remontées encore plus, les sources citées aussi. Ce qui tient, ce sont les intentions, et il faut plusieurs passes pour les voir.
J’espère ne pas vous avoir perdu en route 😉
Et vous, quand vous regardez ce que ChatGPT dit de votre marque, vous le faites sur un run, ou sur plusieurs ?
Questions fréquentes
Quelle différence entre un fanout et une requête ?
La requête, c’est ce que vous tapez. Les fanouts sont les sous-requêtes que le modèle en tire pour interroger un moteur : entre 1 et 4 par réponse dans mes captures.
Combien de fois faut-il répéter un prompt ?
Plus d’une, c’est le minimum. Dans mes captures, les intentions principales revenaient à chaque run et les secondaires une fois sur dix : quelques passes suffisent pour voir les premières. Pour les pages remontées, c’est une autre histoire : sur un sujet commercial, 5 runs n’en font pas le tour (48 domaines différents).
L’outil lit-il ma session ChatGPT ?
Non. Il interroge les modèles plusieurs fois par leur API, sans toucher à votre compte. Ce n’est pas exactement le produit que vous utilisez, alors je le contrôle contre des captures réelles : sur mes 6 prompts, 8 des 9 intentions les plus fréquentes dans ChatGPT sont retrouvées en 3 passes.
Faut-il un compte payant pour capter ses fanouts ?
Non, tout a été fait sur un compte gratuit. Sachez juste qu’il change de modèle après quelques messages (de gpt-6 à gpt-6-mini au bout de 5 dans mon cas). Sur les deux prompts que j’ai comparés, les deux modèles se comportent de la même façon.
Et Gemini ?
Sur mes 6 prompts, Gemini reformule très peu : aucune recherche pour deux d’entre eux, la question reprise telle quelle pour trois, deux sous-requêtes pour un seul. C’est une observation sur 6 cas, pas une étude.
Méthode et limites. Mesures du 12 octobre 2026 : un seul compte (gratuit), un seul jour, une connexion hors de France, 5 runs par prompt sur le modèle gpt-6-mini. Le format des données lues n’est pas documenté par OpenAI et change régulièrement.

Consultant SEO / GEO spécialisé en audits SEO avancés, stratégie de contenu automatisé et optimisé (avec relecture humaine), création d’outils sur mesures, analyse des brevets et algorithmes Google liés au SEO et à la recherche générative et domaines impactant le SEO: UX, social media, autorité de la marque, …
Visibilité dans les réponses IA (GEO)
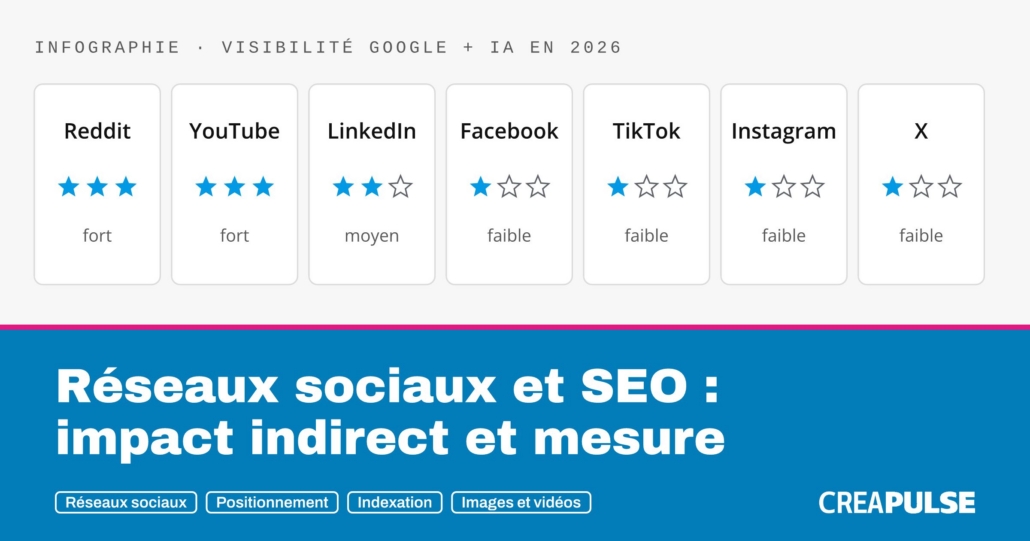
Influence des reseaux sociaux sur le SEO et GEO [Infographie]
Les réseaux sociaux ne font pas ranker une page, mais ils la font connaître. Quels réseaux ressortent dans Google et...
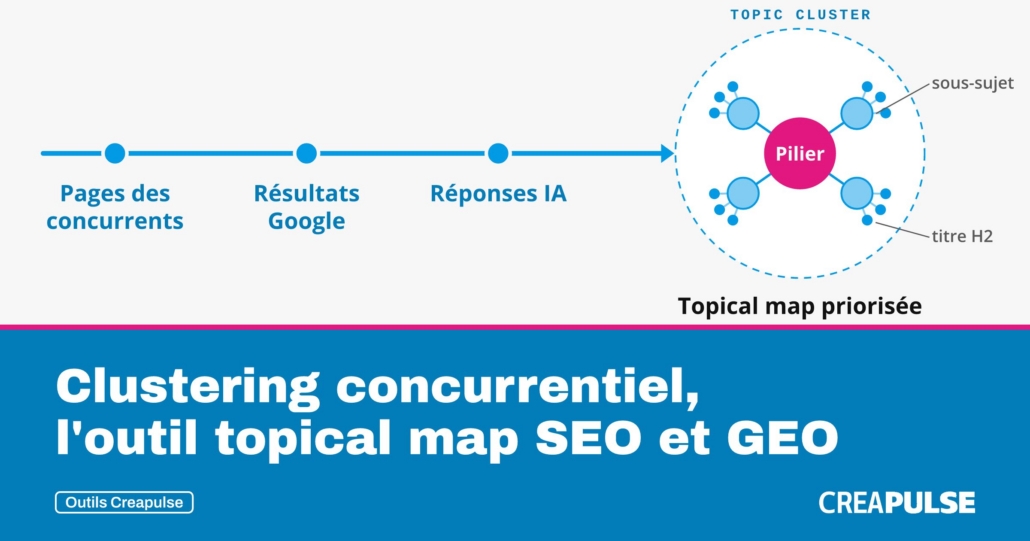
Clustering concurrentiel : la topical map que dessinent Google et ses réponses IA
Clustering concurrentiel lit les pages de vos vrais concurrents, regroupe les requêtes par les résultats Google et tire de ses...
Quelle IA est la plus utilisée en ce moment ? Stats mises à jour chaque jour
Classement quotidien des IA les plus utilisées (OpenAI, Anthropic, Google, DeepSeek, GLM, Kimi, Qwen) d'après les tokens réellement traités par...
Fanouts de ChatGPT: Une capture ne suffit pas
J'ai capté 30 fois les sous-requêtes que ChatGPT lance en coulisses. Une seule paire de runs identique sur 60 :...


Laisser un commentaire
Rejoindre la discussion?N’hésitez pas à contribuer !