Méthodologie d’audit technique SEO et cas pratique sur un site
En bref
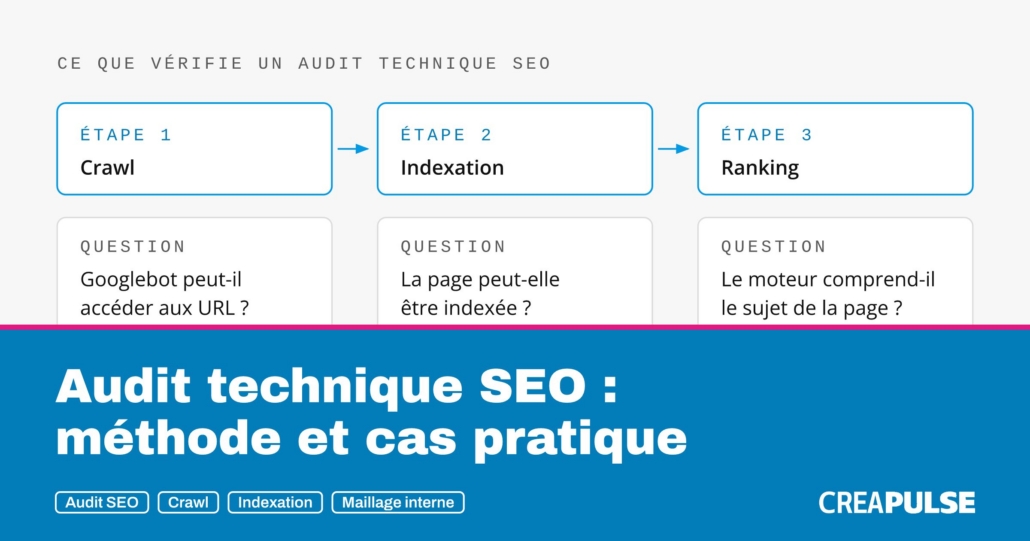
- Un audit technique SEO vérifie trois étapes dans l’ordre : le crawl, l’indexation et la compréhension des pages par le moteur. Un blocage en amont rend mécaniquement les suivantes inutiles.
- Le bon moment, c’est avant une refonte, une migration ou un changement de CMS, sur le site en staging, puis juste après pour vérifier qu’il n’y a pas de régression. Pas six mois plus tard, quand le trafic a déjà chuté.
- Un audit sans priorités, ça sert à rien. Chaque action se classe selon son impact SEO et son effort de correction : les quick wins d’abord, les chantiers de croissance planifiés, le reste noté sans y mettre de budget.
- Le cas pratique porte sur sejour.lastminute.com : 131 996 pages connues, une profondeur moyenne de 5 et 4 576 ms de chargement moyen. De quoi passer en revue pages inutiles, paginations, profondeur, redirections et ancres de liens.
L’audit d’un site sur le plan du référencement est sans doute le travail le plus important à faire pour optimiser sa visibilité et bien référencer son site sur google. L’audit SEO peux intervenir à plusieurs moments de la vie d’un site internet, lors de la création du site web, d’une migration, d’une refonte, d’une pénalité ou simplement car le site n’arrive pas à décoller dans les pages de résultats des moteurs de recherche. Vu que je peux difficilement rentrer dans le détail de l’analyse SEO d’un site client, j’ai décidé d’analyser le référencement du sous-domaine sejour.lastminute.com. Pourquoi ce sous-domaine ? parce qu’à vu de nez, je me doutais que j’allais trouver pas mal de choses intéressantes, je voulais un site avec une certaine volumétrie de pages mais pas perdre trop de temps non plus. Ceci dit, le site a déjà réalisé certaines optimisations SEO comme le javascriptage des filtres, des descriptions dynamiques pour éviter trop de contenu dupliqué,… Je vais concentrer l’analyse de cet audit SEO avant tout sur le plan technique et structurel, sachant que l’objectif principal d’un audit technique de référencement naturel est d’apporter des solutions concrètes et opérationnelles pour améliorer la perception du site par Google, et in fine les conversions utilisateur.
Comprendre l’audit technique SEO et son périmètre
Définition et périmètre de l’audit technique SEO
Pour faire simple, un audit technique SEO sert à vérifier que les moteurs peuvent crawler, indexer et comprendre votre site sans friction. On ne juge ni la qualité de la rédaction ni la popularité des liens entrants à ce stade là : on contrôle la tuyauterie et la base technique qui décide si vos pages ont une chance d’exister dans Google.
Le scope de l’audit technique plus étroit que celui d’un audit SEO global, sachant qu’en général je réalise des audits techniques comme une partie d’un audit global, et très rarement comme un audit seul. Chaque étape du process a ses propres contrôles, et un blocage en amont rend mécaniquement les suivantes inutiles.
| Étape | Question posée | Contrôles techniques associés |
|---|---|---|
| Crawl | Googlebot peut-il accéder aux URL ? | robots.txt, codes HTTP, profondeur, pages orphelines, temps de réponse |
| Indexation | La page peut-elle être retenue ? | noindex / X-Robots-Tag, canonicals, duplication, contenu CSR |
| Compréhension et ranking | Le moteur saisit-il le sujet de la page ? | titles, Hn, données structurées, hreflang, Core Web Vitals, mobile |
C’est un peu le contrôle technique d’une voiture : on ne regarde pas la couleur, on vérifie que ça roule. Si vous proposez un super contenu mais que celui-ci n’a pas les bases techniques qui lui permettent d’etre lu et correctement compris par les bots de Google ou les bots IA, c’est du gachis et une perte d etemps. Une étude de 2026 chiffre justement les seuils à viser pour des critères techniques comme le LCP, le crawl ou le nombre de liens internes.
Étude, 2026 : L’étude établit que la qualité technique du site est le principal déterminant de la visibilité, avec des seuils de 2,5 s pour le LCP, 0,96 pour le crawl-clean ratio et 8 à 12 liens internes par page.
Quand lancer un audit technique SEO
Un audit technique peut être réalisé à plusieurs moments : création de site, refonte, migration, changement de CMS, … Dans chacun de ces cas, une erreur de configuration peut passer inaperçue pendant des semaines.
Un noindex oublié sur un gabarit, un robots.txt de préproduction qui part en production, des redirections incomplètes, des mauvaises canoniques, un serveur qui bloque les bots IA ou Googlebot… Tout ça se voit dans un crawl, rarement à l’œil nu.
Ce qu’il faut retenir, c’est que le bon moment est de le faire avant sur le site en staging , et aussi juste après pour confirmer aucune régression, pas six mois plus tard quand le trafic a déjà chuté. Et si vous n’avez pas de changement à signaler, l’audit technique peut etre réalisé dans le cadre d’une optimisation plus globale ou dans le cadre d’un contrôle régulier pour repérer les effets de bords après certaines évolutions sur le site.
Audit technique SEO
Pour auditer un site sur le plan technique, il y a quelques pré-requis et outils SEO nécessaires:
- Un crawler: Botify, screaming frog, …
- L’accès aux logs serveur, et les analyser avec un analyseur de logs et/ou avec des commandes linux.
- L’accès au compte google webmaster tools
- L’accès au compte analytics
- Et surtout l’expérience d’un expert SEO capable d’interpréter toutes ces informations.
En plus des informations données par ces outils, le client peux également en donner, sur l’historique du site, les derniers changements survenus, afin de mieux comprendre certains constats. En l’occurrence, je me suis basé uniquement sur un crawl du site mais vous le verrez, ça permet déjà d’identifier de nombreux facteurs bloquants et leviers d’optimisations.
Prioriser selon impact SEO et effort de correction
Un audit qui sort deux cents constats sans aucune vraie action opérationnelle et sans priorités, ça sert à rien. Un audit qui dit par où commencer, c’est mieux. Je classe donc chaque action selon deux curseurs : l’impact SEO attendu (crawl, indexation, pagerank interne, visites) et l’effort de correction (temps de développement, risque, dépendances).
Ça donne trois familles :
- Les quick wins (fort impact, faible effort) : Par exemple, modifier un robots.txt, supprimer certaines pages, appliquer des redirections, corriger le WAF (Web Application Firewall) d’un serveur qui bloque des bots (IA ou google) ….
- Les chantiers lourds ou ce que j’appelle des chantiers de croissance (fort impact, gros effort) : changer toute une arborescence, créer des nouveaux hubs de pages
- Le reste (faible impact) : on le note, mais on ne lui consacre pas de budget tant que le reste n’est pas traité.
À noter que la faisabilité compte autant que l’impact : un chantier lourd se planifie et se découpe, il ne se bâcle pas. Les quick wins donnent des résultats rapides, les chantiers lourds donnent les gros gains en continu.
Comprendre le site
Le crawl du site sejour.lastminute.com est le site le plus important des sous-domaines Lastminute sur Google.fr, juste derrière le site principal www.fr.lastminute.com. Son crawl a permis d’extraire ces informations macro:
- 131 996 pages connues
- 74 828 pages sur le domaine sejour.lastminute.com (les urls crawlées ne proviennent pas uniquement du sous domaine analysé)
- 66 309 pages crawlées en code 200 (code de réponse normal d’une page web)
- 57 151 liens sortants vers d’autres sous-domaines
- Temps de chargement moyen des pages: 4 576 ms (hors JS et images)
- La profondeur moyenne du site est de 5
Ces datas permettent déjà d’apercevoir certains facteurs bloquants:
- Toutes les pages du sous-domaine séjour ne répondent pas normalement en 200. Ce sont peut-être des pages d’erreur 404, des redirections 301 ou autres.
- Le temps de chargement est lent, facteur important pour le crawl de googlebot et l’expérience utilisateur, voir le guide sur l’optimisation des performances
- La profondeur du site est assez élevé, sachant que les pages profondes reçoivent moins d’énergie (linkjuice) de la part de google et ont moins de chance d’être visible sur les pages de résultats des moteurs.
- Beaucoup de liens vers d’autres sous-domaines. Idéalement, pour l’audit, il aurait fallu prendre en compte l’ensemble des sous-domaines de Lastminute ou au moins les plus importants (5 ou 6).
Ces données permettent de donner des pistes SEO et de donner des directions sur les analyses à creuser. Elles peuvent aussi être intéressantes dans le cadre d’un pré-audit et ainsi convaincre sur la nécessité de réaliser un audit SEO. Mais ce n’est pas suffisant, quelles sont les pages ou les catégories de pages les plus profondes ? Les types de pages qui se chargent lentement ? Quelles sont les pages en erreur ? Pour faire une analyse plus en détails, il est indispensable de catégoriser le site.
Catégorisation du site
Pour faire un audit SEO avancé et pouvoir donner des recommandations précises, l’étape de la catégorisation est surement la plus importante. Catégoriser un site consiste à segmenter le site en différentes catégories afin de mettre en lumière les causes des facteurs bloquants et de prioriser les recommandations. On peux catégoriser un site de différentes manières, sur un plan structurel et/ou sémantiques. Et il n’y a pas de manière unique de le faire, l’objectif est que cela serve les objectifs de l’audit SEO. Cette catégorisation n’est pas seulement utile pour la partie technique, mais aussi pour l’analyse du linking interne, la partie contenu, social, linking externe qu’on verra dans la suite de cette série de guides.
Catégorisation structurelle

Catégorisation de sejour.lastminute.com sur le plan structurel
A partir des urls récupérées par le crawler ou des adresses récupérées via les logs, je catégorise le site à l’aide d’expressions régulières afin que ça m’aide à mieux comprendre le site. Voici un exemple d’expression régulière: ^/hotel-[\w-]+\.html$ Cette expression régulière permet de récupérer tous les pages que j’ai placé dans la catégorie « hotel-pays » comme http://sejour.lastminute.com/hotel-bresil.html En fait, cette catégorisation mixe une vision structurelle du site avec par exemple les pays et les villes qui ne sont pas au même niveau; et une vue sémantique avec le type de voyages : séjour, week-end, camping,..
Catégorisation sémantique

catégorisation sémantique
La vue est ici plus grossière, un peu moins utile pour l’audit technique mais très utile pour la partie sémantique et ainsi mieux voir la distribution du contenu par univers.
Pages inutiles

pages inutiles au referencement
Lors de la catégorisation, j’ai identifié des pages que j’ai jugé inutile au SEO. Les pages inutiles sont des pages sans objectif SEO comme des pages dupliquées, des pages vides, des pages d’erreur, des pages qui ne servent pas à l’exploration d’autres contenus, des pages non pertinentes, … Ici, dans notre cas, 70% des pages crawlées sont inutiles, et parmi ces pages inutiles 62% sont des liens vers d’autres sous-domaines et 36% vers des paginations.
Les liens vers d’autres sous-domaines
C’est un cas assez particulier, Les pages des autres sous-domaines ne sont pas des pages inutiles en soi mais il y a plus de liens vers d’autres sous-domaines que de pages utiles dans le sous-domaine sejour (57 139 vs 39 448) . Ça signifie que le sous-domaine sejour fourni plus d’énergie (linkjuice) aux autres sous-domaines qu’à son propre domaine. De plus, un ratio aussi déséquilibré de liens externes peut-être perçu par Google comme une tentative de pousser artificiellement le site principal FR (c’est le principal sous-domaine lié). L’objectif des recommandations sur ce sujet seront de limiter les liens vers les sous-domaines, vus par google.
Les paginations
Décidément, la encore , c’est un cas particulier, et qui prouve aussi qu’il n’y a pas de vérités absolues en référencement naturel. Les paginations lorsqu’elle sont un minimum optimisées servent normalement à l’exploration des pages produits/articles , c’est leur principal objectif SEO en général, elles ont leur utilité même si elles sont peu efficaces et qu’il faut limiter leur volume. Sauf qu’ici, les produits liés par les paginations sont en nofollow, surement pour éviter une détection de transmission artificielle de jus entre le sous-domaine sejour et le site principal. Les paginations n’ont pas non plus vocation à se positionner, elles sont no-index d’ailleurs. Par exemple: http://sejour.lastminute.com/hotel-etats-unis.html?nbprods=10&sort=0&default=0&pageID=3 Le site fait donc des liens vers des 33 749 paginations, presque autant que de pages utiles (39 448), qui ne servent pas à explorer de produits et qui n’ont pas vocation à se positionner, elles sont donc inutiles. En quoi c’est un problème ?
- 18% du pagerank interne est distribué aux paginations au détriment des pages stratégiques du site, qui sont elles, destinées à ramener du trafic.
- C’est une perte de crawl pour googlebot, googlebot va crawler des pages mais on lui dit juste après que cette page n’est pas destinée à être indéxée sur Google. Googlebot n’étant pas complètement idiot, il a tendance à ralentir son crawl sur les pages en noindex, ce qui semble assez logique même si ça ne résout pas tout. Une analyse des logs aurait permit de le confirmer.
La solution concernant les paginations est assez simple, il faudrait les javascripter, comme c’est déjà fait avec les pages de filtres. De cette manière, elles restent accessibles pour l’utilisateur mais invisibles au moteur. A noter qu’il faut faire attention à la technique de javascriptage employée car google crawle de mieux en mieux le javascript. La aussi, une analyse de googlebot permettrait de valider ou pas la méthode de javascriptage utilisée. Dans le cadre d’une refonte, d’autres solutions seraient envisageables comme un scroll infini en ajax par exemple.
Problèmes des pages inutiles
De manière générale, les pages inutiles peuvent être responsables de plusieurs problèmes:
- Sources de duplications pénalisables par Google panda.
- Perte de crawl, comme on l’a vu
- Perte de pagerank interne
Robots.txt : accès, blocages et ressources critiques
Le robots.txt est un fichier à la racine du site qui indique aux robots quelles URL ils peuvent explorer, rien de plus. Il sert surtout à gérer le trafic d’exploration et à ne pas surcharger le serveur. Ce n’est pas un outil d’indexation : une URL bloquée mais référencée ailleurs peut très bien se retrouver dans l’index de Google.
Le robos.txt peut aussi etre utilisé pour autoriser ou refuser certains bots IA, on peux meme autoriser les bots IA à afficher vos pages en tant que sources citées, et refuser en revanche que votre contenu serve à leur entrainement.
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /
Dans cet exemple de regles robots.txt:
- Pas de crawl par GPTbot: c’est le bot de chatgt qui sert à entrainer son modèle, il est bloqué ici.
- Crawl par OAI-Searchbot: Votre site peut être cité sur chatgpt
C’est ce que font des sites comme leparisien ou lemonde, ils bloquent GPTBot , ClaudeBot et d’autres , mais laissent l’accès à OAI-SearchBot (chatgpt) et à Claude-SearchBot. A moins que ce soit une erreur de leur part …. je me pose la question car tout deux indique claude-web et anthropic-ai dans leurs règles alors que ces bots ont été remplacés par Claude-SearchBot et claudebot, donc pas certains qu’ils soient à jour.
À vérifier aussi lors de l’audit : que le fichier répond bien, qu’aucune section stratégique n’est bloquée par une règle trop large (après une migration, c’est vite arrivé), et que les CSS et JS nécessaires au rendu des pages importantes restent accessibles à Googlebot.
Balises noindex et en-têtes X-Robots-Tag
Pour empêcher l’indexation, c’est ici que ça se joue : la balise meta robots dans le HTML, ou l’en-tête HTTP X-Robots-Tag, pratique pour les PDF et autres fichiers sans HTML.
Comme pour les paginations du cas pratique, Googlebot doit crawler la page pour lire son noindex. Donc ne combinez pas robots.txt et noindex sur une même URL : le robot ne verra jamais la consigne.
Dernier contrôle, et le plus rentable : lister les pages stratégiques en noindex, typiquement oubliées après une migration. Le risque est explicite, et le crawl le détecte en quelques minutes.
Profondeur des pages

Profondeur des pages utiles
C’est quoi la profondeur en SEO ? C’est le nombre de clics nécessaires pour atteindre une page depuis la page d’accueil. Pourquoi c’est important ? Plus une page est profonde, moins elle est considérée comme importante par Google (je vulgarise). C’est assez logique, les vêtements qu’on met souvent ou qu’on préfère, on ne va pas les ranger au fond du placard 🙂 Quel est l’impact d’une page profonde? Soit elle ne sera tout simplement pas vue par Google donc pas visible dans les serps (pages de résultats d’un moteur de recherche), soit elle sera explorée par google mais peu ou pas active (page active: page recevant au moins une visite). On voit sur le tableau ci-dessous que plus la profondeur augmente, plus le taux de pages actives baisse.

Plus une page est profonde, moins elle est active
Est ce que le sitemap.xml permet de résoudre le problème d’une page profonde? Non, le sitemap.xml ne résoud pas le problème car même si une page profonde est explorée par googlebot via le sitemap, cette page ne sera pas forcément indéxée, et encore moins bien positionnée. Seul le maillage de liens et la profondeur permettra de valoriser une page auprès de google afin de la rendre active. Le sitemap est important pour l’actualité et la vidéo cependant. Pour en savoir plus, je vous conseille cet article sur l’impact du sitemap sur le seo. Revenons à notre cas pratique, 60% de la partie utile du site est au delà de la profondeur 3 et on voit que le taux de pages actives en profondeur 3 est inférieur à 1%. (calcul fait par rapport aux positions des pages). Je ne vais pas rentrer dans le détail ici, mais l’objectif des recommandations concernant la profondeur sera d’identifier les catégories de pages profondes (ce qui est simple vu que le site est finement catégorisé) et de remonter les pages les plus stratégiques en terme de visites ,d’exploration et d’efficacité crawl/visites. Je ferais surement une série de guides uniquement sur la structure et le PR sculpting et je prépare aussi des formations inter pour la rentrée, keep in touch.
Structure des URL et logique d’arborescence
Une URL bien construite indique la place d’une page dans le site : /categorie/sous-categorie/page. C’est lisible pour l’utilisateur, et ca facilite la catégorisation des urls accessoirement, même si ce dernier critère facilite surtout le travail du consultant SEO ou du data analyste.
Attention à une erreur fréquente : le nombre de dossiers dans l’URL n’est pas la profondeur. Une page en /a/b/c/d peut être à un clic de l’accueil si elle y est liée, et une page en /a/ peut être à six clics. Seul le chemin de liens compte.
Par expérience, Le poids de l’url est assez faible en SEO, une URL « dégueullasse » et paramétrée peux aussi bien se positionner qu’une URL plus « jolie ».
Il faut surtout contrôler que les URL restent stables, sans paramètres inutiles (comme l’URL de pagination vue plus haut avec ses nbprods, sort et pageID), et cohérentes avec la hiérarchie des catégories.
Attention aussi à la logique métier derrière, si une fiche produit peux appartenir à plusieurs catégories, il vaux mieux la mettre à la racine du site et pas dans un dossier /categorie/.
Profondeur des pages stratégiques
Le repère habituel est de garder les pages stratégiques à 3 clics maximum de l’accueil. Au-delà de 3 ou 4 niveaux, l’accessibilité pour les robots se dégrade, et le PageRank interne se dilue à chaque clic.
Mon analyse : le robot ne crawle pas au hasard, il arbitre entre l’importance d’une URL et sa fréquence de changement. Une page profonde, peu liée et qui bouge peu cumule donc les handicaps pour être revisitée.
Brevet Google US-7308643-B1 : le brevet décrit un robot d’exploration qui ordonnance son crawl en combinant le PageRank indépendant de la requête d’une URL et la fréquence de changement observée du document.
Temps de chargement

Temps de chargement moyen par catégories
L’univers « Hotel » a un temps de chargement moyen de près de 3 secondes alors que c’est la catégorie de pages la plus volumineuse. Il faut donc en priorité accélérer le chargement de ces pages, un objectif réaliste serait d’atteindre un temps de chargement entre 500 ms et 1 seconde. Les pages inutiles c’est pas grave vu qu’on est censé limiter leur exploration par Google. Le temps de chargement analysé prend en compte uniquement le code HTML et pas les JS, les CSS ou les images. Ca se rapproche du temps de chargement côté googlebot, mais ça veux dire aussi que le chargement utilisateur est bien supérieur à 3 secondes, ce qui est beaucoup. On peux voir aussi la vitesse d’exploration sur google webmaster tools mais ce n’est pas catégorisé comme ici. De plus, lorsqu’on voit la vitesse d’exploration qui baisse sur goowle webmaster tools, ce n’est pas forcément bon signe, voire le contraire, peut-être qu’il crawle rapidement des pages sans intérêt, d’où l’intérêt de la catégorisation. Je rappelle l’importance du temps de chargement:
- C’est un facteur de crawl: plus une page est crawlée rapidement et plus google verra de pages sur le site
- C’est un critère de conversion : L’expérience utilisateur sera meilleur si le site est rapide
- C’est un critère de positionnement: Google positionne mieux les sites rapides depuis avril 2010
Lisez ce guide pour en savoir plus sur l’optimisation des performances
Core Web Vitals: TBT, LCP, CLS, FCP, speed index, INP and co
Le temps de chargement HTML vu plus haut ne dit pas tout. Les Core Web Vitals mesurent ce que l’utilisateur voit vraiment :
- Total Blocking Time (TBT) – 30% du score pagespeed : La mesure du temps qu’une page est bloquée sans pouvoir répondre aux interactions du visiteur
- Largest Contentful Paint (LCP) – 25% du score pagespeed : le temps d’affichage de l’élément principal de la page (gros visuel ou bloc de texte) ;
- Cumulative Layout Shift (CLS) – 25% du score pagespeed: la stabilité visuelle, le bouton qui saute au moment où vous cliquez, vous connaissez 😉
- First Contentful Paint (FCP) – 10% du score pagespeed: le moment où le premier texte ou la première image sont affichés
- INP : la réactivité quand un visiteur clique ou tape, latence de l’interaction la plus longue (ignore les valeurs abbérantes) ;
Dans le cadre d’un audit technique ou meme d’une surveillance continue de la vitesse des pages, c’est mieux de segmenter par type de pages (on revient à l’importance de la catégorisation , toujours) car chaque type de page a son propre score de performance. Dans ce graphe ci dessous, on voit le suivi du LCP par type de page, issu du Digital Dashboard d’un client (Dashboard digital 360):
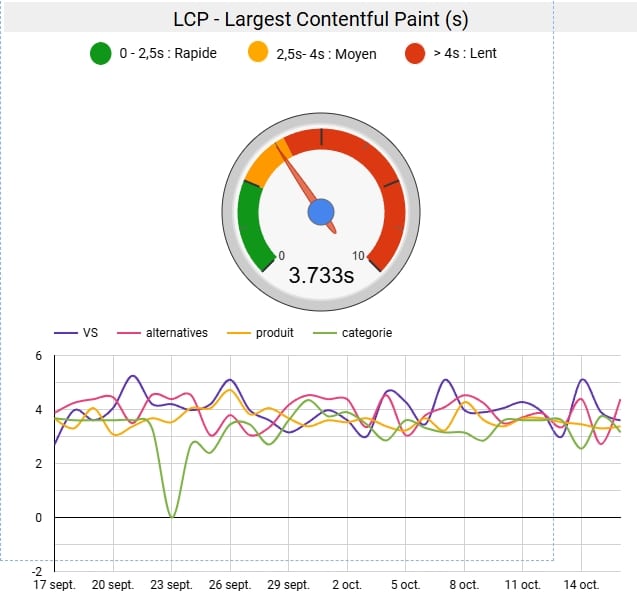
Utilisez PageSpeed Insights, Lighthouse, GTmetrix, et le rapport Core Web Vitals de la Search Console, qui s’appuie sur des données réelles. On a vu par exemple en début d’article qu’un seuil en dessous de 2,5 s pour le LCP était conseillé. Et d’après la doc officielle de pagespeed , le LCP qui reentre 2,5s -4s c’est un score moyen, et > à 4s c’est considéré comment lent.
Et oui, les Core Web Vitals sont évalués par Google à partir de données réelles d’utilisateurs (CrUX), ce n’est donc pas uniquement pour les moteurs de recherche, mais aussi pour l’utilisateur (UX). J’insiste un peu la dessus, car un développeur un peu tétu pensait que c’était que pour le SEO, et que son site est super rapide.
L’impression de vitesse qu’on a depuis son poste n’est pas forcément l’imperession moyenne des visiteurs.
Images, cache, minification et CDN
Une fois les Core Web Vitals mesurés, les leviers sont assez récurrents. Pour faire simple :
- Images : les compresser, les redimensionner et, idéalement, passer à des formats modernes comme WebP ou AVIF.
- Minification CSS/JS : retirer espaces et commentaires pour alléger les fichiers.
- Cache navigateur : le visiteur ne retélécharge pas ce qu’il a déjà.
- CDN : servir les fichiers depuis un serveur proche de l’utilisateur.
Commencez par les images, c’est souvent là que se joue le LCP. PageSpeed Insights liste ces points avec les fichiers concernés, ce qui donne un plan d’action actionnable.
Structure HTML, contenu et signaux d’indexation
Ici, on est un peu à la frontière entre technique et sémantique que je traite plus longuement dans cet article . Une fois l’accès aux pages garanti, reste à vérifier que Google les comprend. Voici une mini- checklist on-page de quelques basiques :
- Titles : uniques, jamais vides ni dupliqués.
- Meta descriptions: Pour l’utilisateur surtout et améliorer el CTR
- Hn : une hiérarchie de titre et inter-titres logique et cohérente
- Canonicals : présentes et pointant la bonne URL. Indique aux moteurs quelle est la page originale et évite au passage l’indexation de versions de la meme url avec parametres.
- Doublons : URLs paramétrées, copies inter-domaines.
- Données structurées : balisage utile pour le SEO et encore plus pour le GEO
Titles, meta descriptions et unicité
Les titles et meta descriptions sont la vitrine de vos pages dans les résultats. Ils doivent être uniques, optimisés, descriptifs, donner envi de cliquer et ne pas être laissés vides.
Sur un gros site, on peux les auditer avec un crawler comme Screaming Frog, identifier les doublons, les titles manquants et trop longs. Je le traite plus longuement dans l’audit sémantique mais le title reste un des points les plus importants dans une page. Donc un title dupliqué ou pas optimisé, c’est un problème !
Hiérarchie Hn et cohérence du template
Un H1 clair, des H2 et H3 qui découpent le sujet logiquement : c’est la base. C’est utile pour l’utilisateur pour qui il est plus agréable de lire un contenu rythmé et aéré. C’est pour les moteurs IA et googlebot qui voit un contenu hierarchisé, facilement parsable, qui répond « logiquement » à plusieurs intentions ou sous intentions du meme sujet.
Contenu dupliqué, canonicals et cannibalisation
La canonical est une recommandation donnée aux moteurs, pas une directive qu’ils sont censés suivre à la lettre. Elle doit être cohérente sur tout le site : redirections, sitemap, maillage, backlinks. Si Google detecte des incohérences, il peux ignorer la canonique et prendre en compte la version majoritaire.
La cannibalisation, c’est quand plusieurs pages visent la même intention : on tranche, on fusionne ou on différencie.
Pour duplication, Imaginez un classeur où l’on ne garde qu’un exemplaire de chaque document identique. Google évalue la duplication avant même d’évaluer la pertinence, et donc certaines URL peuvent disparaître de l’index avant d’être jugées. L’avantage pour Google est d’économiser des ressources, « pourquoi perdre du temps à juger ce contenu si je sais déja qu’il est dupliqué ». Ce principe d’économie de ressources est d’ailleurs repris dans d’autres aspects du fonctionnement du moteur de recxerche. Voici un brevet qui décrit justement comportement de Google avec le contenu dupliqué:
Brevet Google US-7984054-B2 : le brevet décrit un système qui regroupe au crawl les documents au contenu identique, choisit un représentant selon des scores indépendants de la requête et n’indexe que celui-là. Dans le texte du brevet : « For these reasons, it would be desirable to develop a system and method of detecting duplicate documents crawled by a search engine before the search engine makes any further effort to process these documents. »
Des pages strictement identiques risquent donc d’être regroupées avant toute évaluation on-page.
Données structurées et balisage utile
Les données structurées aident à étiqueter le contenu. Elles servent aussi les réponses d’IA : selon une étude de 2026 sur les moteurs génératifs, un HTML structuré double la citation et multiplie par 4 la fidélité d’extraction par rapport à un contenu non structuré équivalent.
« Utile » veut dire que le balisage décrit ce qui est réellement visible sur la page, sans en rajouter. On peux le valider avec le l’outil schema.org, et on contrôle chaque type de page.
Selon une étude de 2023 sur des médias d’information américains, 80 % des attributs de métadonnées d’un article étaient les mêmes pour un même CMS, quels que soient l’éditeur, le marché ou le public visé. Un défaut de gabarit se répète sur toutes les pages qui l’utilisent, et sa correction aussi.
Autrement dit, un CMS ou un thème WordPress mal configuré peut limiter la découvrabilité des contenus par les bots IA ou googler search, même si les articles sont excellents
La visibilité d’un contenu en SEO et GEO dépend non seulement de sa qualité éditoriale, mais aussi de son infrastructure technique de métadonnées.
Les redirections

Répartition des codes http
9% du crawl sur la partie utile se fait sur des redirections 301. Les redirections 301 sont parfois nécessaires mais utilisées de manière abusive et inappropriée, elles ont un impact négatif sur le référencement pour plusieurs raisons:
- Elles ralentissent le crawl de google, une 301 étant plus lente à crawler qu’une page en code 200 (code de réponse normal d’une page). page A > page B redirigée > page C.
- Il y a une perte de jus entre la page A et la redirection sur la page B vers C
- C’est déceptif pour l’utilisateur surtout si la page d’atterrissage s’éloigne de la promesse du lien.
Après extraction des urls concernées, je constate plusieurs sources de pages responsables de ces redirections, comme par exemple les liens sur la pagination 1, ou le bloc « trouvez aussi » qui fait des liens vers des pages redirigées lorsque aucun produit n’est disponible:

urls en 301: sources et destinations
Les solutions sont au cas par cas, mais en général il s’agit de remplacer la mauvaise url par la bonne tout simplement ou de supprimer le lien pour le moteur et/ou l’utilisateur. Pour les pages de produits non disponibles, ça dépend, mais pour des pages qui ont tendance à lister des produits qui partent et qui reviennent fréquemment, il est souvent préférable de ne pas rediriger la page et de la laisser en 200, tout en affichant un message approprié pour l’utilisateur, proposer des produits associés et éviter la duplication. Un audit plus avancé et avec plus de données serait nécessaire.
Les ancres de liens

Ancres de liens de liens suroptimisées
L’analyse des ancres de liens d’un site est à la fois utile pour l’optimiser mais aussi pour éviter la suroptimisation. En effet, L’utilisation excessive d’une même ancre de lien peux être pénalisé par Google Penguin. L’excès est relatif, il dépend du ratio d’utilisation des autres ancres, des autres combinaisons avec ce même mot clé, du netlinking, de la concurrence du mot-clé, etc.. Ici, on constate que « vol pas cher » est un texte de lien très utilisé relativement aux autres, c’est une expression très concurrentielle d’ailleurs, il y a donc un risque par rapport au filtre penguin. Regardons plus en détails les combinaisons de mots clés utilisés dans les ancres de liens:

Occurences des ancres de liens
J’ai extrait le nombre d’occurences des différentes combinaisons de textes de liens sur un top 1000 des ancres les plus utilisées. On voit sur l’extrait ci-dessus que « vol pas cher » est souvent combiné à une ville « vol pas cher bangkok » , « vol pas cher Madrid », … Cela permet de rendre son utilisation plus légitime et plus naturelle. D’ailleurs lorsqu’on cherche « vol pas cher » sur google, sur qui on tombe ? Il sont premiers sur cette expression clé très concurrentielle. Ça montre bien l’intérêt de varier ses ancres. Ceci dit, je serais eux, le lèverais un peu le pied sur l’utilisation de « vol pas cher » seul, ils sont déjà premier dessus, donc pas utile d’en rajouter.
SEO International, sécurité, mobile, javascript
Hreflang et sites multilingues
Le hreflang indique à Google quelle version d’une page proposer selon la langue ou le pays. Pour un site multilingue, qu’il soit par dossier, par sous domaine, par domaine (cctld), c’est indispensable. C’est d’autant plus important lorsqu’un site cible plusieurs langues et plusieurs pays, ça permet d’éviter les confusions d’indexation et de cibles visées.
À vérifier :
- la réciprocité : si A pointe vers B, B doit pointer vers A, et chaque page doit se référencer elle-même ;
- des codes langue/pays valides, avec un
x-defaultsi besoin ; - des URL cibles en 200 et indexables, jamais redirigées ni en noindex ;
- la cohérence avec les canonicals.
Une hypothèse de travail à garder en tête : un filtrage par langue peut écarter des ressources avant le classement classique. Contrôlez donc aussi que chaque locale dispose réellement de sa couverture de contenu.
HTTPS, HSTS, certificats et mixed content
Le HTTPS fait partie du socle attendu. Selon une étude de 2025 sur les redirections, parmi 6 millions de redirections canoniques, les passages HTTP→HTTPS dominent, avec environ 4,6 millions de cas, signe d’une large adoption des protocoles sécurisés.
Ce qu’on vérifie dans un audit technique: certificat valide et non expiré, redirection 301 de HTTP vers HTTPS, canonicals et sitemap en HTTPS, et aucun contenu mixte (une page HTTPS qui charge des ressources en HTTP).
Reste le cas de HSTS. C’est un signal « entrez uniquement par la voie sécurisée » que le site affiche au navigateur,. En gros, si un utilisateur est passé la première fois sur le site via la version http (via un veux backlink par exemple), la deuxième fois, le navigateur aura déja enregistré le signal et passera directement par la voie https, sans meme passer par la redirection. Mais attention, HSTS est un complément, il ne remplace surtout pas la redirection HTTP vers HTTPS. Ca fait gagner un peu termps au visiteur, quelques centaines de millisecondes selon la latence du serveur, mais c’est un gain non négliogeable pour un gros site par exemple, surtout si le site est inscrit en HSTS préload (une liste blanche intégré aux navigateurs). Pour s’inscrire à cette liste HSTS preload: https://hstspreload.org/
Mais l’objectif principal de HSTS à la base c’est la sécurité, ça évite les attaques de rétrogradation, de SSL Stripping et certaines attaques de Man-in-the-Middle.
Étude, 2025 : Les mécanismes d’upgrade comme HSTS et HTTPS-Only augmentent l’usage de HTTPS et protègent des attaques de rétrogradation, mais HSTS fuit un bit indiquant si le navigateur a déjà visité le site.
Mobile-first
Google explore le web en version mobile : ce que le robot voit sur mobile fait foi. Le contenu principal, les métadonnées et les données structurées doivent donc rester cohérents entre mobile et desktop. Je vous renvoie à la documentation Google sur l’indexation mobile-first, et à mon étude de cas sur l’index mobile first et crawl.
Rendu JavaScript et accès aux ressources
Même logique pour le JavaScript : un contenu injecté côté client (CSR) n’existe pour Google que s’il apparaît dans le rendu. Vérifiez avec l’inspection d’URL de la Search Console, et assurez-vous que CSS et JS ne sont pas bloqués par le robots.txt. Pour aller plus loin, j’ai détaillé la méthode dans mon article sur l’audit technique et crawl JavaScript.
Conclusion
Bon, je vais m’arrêter là pour cette petite partie d’audit technique SEO. En fonction des sites, il y a des points qu’on peux plus ou moins développer. D’ailleurs, mes audits SEO se ressemblent rarement d’un client à un autre, je déroule pas betement une checklist mais je traite uniquement les points qui méritent une attention et pour les lesquels de la croissance est possible. Si un site est super rapide, j’en parle meme pas par exemple, pas utile de faire du remplissage pour dire qu’il y a rien à faire sur cet aspect là. Bon voila, Je me suis appuyé de quelques cas pratiques pour parler de ce qui me semblait le plus important sur le plan technique et avec les données disponibles. Pour ceux intéressés par un devis pour un audit SEO et un pré-audit gratuit de leur site, je reste à votre disposition.

Consultant SEO / GEO spécialisé en audits SEO avancés, stratégie de contenu automatisé et optimisé (avec relecture humaine), création d’outils sur mesures, analyse des brevets et algorithmes Google liés au SEO et à la recherche générative et domaines impactant le SEO: UX, social media, autorité de la marque, …
Audit de site web
Cannibalisation SEO : détecter les conflits d’URL, les corriger et concentrer l’autorité
Vos pages se font concurrence sur la même requête et Google hésite ? Voici comment repérer ces conflits d'URL, choisir...
Catégoriser ses URLs pour un audit SEO : méthode, regex et outil
Pourquoi et comment catégoriser ses URLs avant un audit SEO : deux axes, un fichier de règles, quelques regex simples...

Audit technique SEO et crawl javascript
Comment Google crawle le javascript? Ses limitations ? Ce qu'il faut savoir pour bien auditer le SEO d'un site en...

[Guide] Comment connaitre et supprimer les mauvais Backlinks
Pour sortir ou prévenir d'une pénalité, Voici un guide pour identifier facilement les mauvais backlinks (liens entrants) et pénalisants vers...

Audit de site ecommerce
Un audit e-commerce sort rarement 5 problèmes, plutôt 50. Voici comment je les trouve (vitesse, navigation, tunnel, tracking) et par...

L’Audit sémantique: Méthodologie et outils
L'audit sémantique ou l'audit de contenu fait partie de toute stratégie de référencement ou webmarketing. Je vous présente une méthodologie...


Laisser un commentaire
Rejoindre la discussion?N’hésitez pas à contribuer !